面试题库
Java 后端面试题总汇
Java 基础、集合、并发 JUC、IO 网络、反射设计模式、JVM、MySQL、Spring、Redis/MQ/ES、微服务与项目人事话术,合并去重版总汇。
- Java
- 后端
- 面试
Java 后端面试题总汇
由原《JavaSE 面试题》《Java 高频必过面试题》《JavaWeb 框架与微服务面试题》《MySQL 面试题》《Java 后端知识总汇》五篇合并去重而成:同题仅保留更详细的版本,按主题重组为十一章,全文连续编号。
一、Java 基础与面向对象
写出Java的四类八种基本数据类
整数 byte (1字节) short (2字节) int (4字节) long (8字节) 小数(浮点) float (4字节) double (8字节) 字符 char (2字节) 布尔 boolean (Java虚拟机规范没有规定boolean的大小,实现取决于具体的JVM实现。通常 独立变量占4字节,数组中占1字节) 备注:除去boolean类型之外的七种数据类型,可以根据规则进行自动类型转换和强制类型转换
1. 基本数据类型的类型转换规则
基本类型的类型转换分为自动转换和强制转换。这里的基本数据类型指除了boolean之外的7种数值型数 据类型。 自动转换规则:容量小的数据类型可以自动转换成容量大的数据类型,也可以说低级自动向高级转换。 下图是自动转换的方向 强制转换规则:高级变为低级需要强制转换。
如何转换:
(1)、赋值运算符“=”右边的转换,先自动转换成表达式中级别最高的数据类型,再进行运算。 (2)、赋值运算符“=”两侧的转换,若左边级别>右边级别,会自动转换;若左边级别 == 右边级别, 不用转换;若左边级别 < 右边级别,需强制转换。 (3)、可以将整型常量直接赋值给byte, short, char等类型变量,而不需要进行强制类型转换,前提 是不超出其表述范围,否则必须进行强制转换。 备注:除了基本数据类型,引用数据类型的类型转换是开发中更常用的场景,分为「向上转型」和「向 下转型」,分别采用自动类型转换和强制类型转换
2. char型变量能存贮一个中文汉字吗
在Java中,char类型是用来表示单个字符的数据类型,它基于Unicode编码(具体实现为UTF-16),可 以存储各种语言的单个字符,包括中文汉字。 char类型占用2个字节的内存空间,对应UTF-16编码中1个16位的编码单元。绝大多数常用中文汉字(如 「中」「国」)的UTF-16编码仅需1个16位单元即可表示,因此可以直接赋值给char变量:char ch = ‘中’;,编译器会自动将字符转换为对应的Unicode编码值(如「中」的编码是0x4E2D,也可写成转义序 列\u4e2d)。 UTF-8是Unicode的另一种编码实现(传输/存储常用),中文汉字在UTF-8中通常占3字节,但这与Java 内存中char的存储逻辑无关——char的存储仅依赖UTF-16编码,而非UTF-8。 需要注意的是:极少数增补区的生僻古汉字,其UTF-16编码需要2个16位单元(即2个char)才能表示, 这类字符无法用单个char存储,需用String类型表示。char的核心用途是存储单个字符(包括单个中文 汉字),String则用于存储多个字符组成的字符串。
3. & 和 && 的区别
& 逻辑与符号的左右两边,无论真或假都要执行 && 短路与符号的左边如果为假,符号的右边不再执行,提高了代码的执行效率 备注:&还可以用作位运算符。当&两边操作数或两边表达式的结果不是boolean类型时,&用于按位与 运算符的操作。
4. 用最有效率的方法算出2乘以8等于多少
使用位运算来实现效率最高。 位运算符是对操作数以二进制比特位为单位进行操作和运算,操作数和结果都是整型数。 对于位运算符“<<”, 是将一个数左移n位,就相当于乘以了2的n次方,那么,一个数乘以8只要将其左移3 位即可,位运算cpu直接支持的,效率最高。 所以,2乘以8等于几的最效率的方法是2 << 3。
5. switch的条件变量可以是什么类型
byte,short,int,char,枚举、String 具体细节为:
- 整数类型中的 byte、short、int一直可以。(long不可选) 2)字符类型中的char一直可以(可以理解为int) 3)JDK1.5后增加了enum枚举类型 4)JDK1.7后增加了String类型。但本质是「语法糖」—— JVM 会把 String 转成 hashCode()(int 类 型)再执行 switch 备注:八大基本数据类型中:long、boolean、float、double 不可以作为switch的参数,尤其记住long 不可以,这一点很容易错误记忆
6. Java中变量和常量有什么区别
在Java中,变量和常量是两个不同的概念,它们有以下几点区别:
- 可变性: 变量是可以被修改的,其值可以在程序的执行过程中改变。 常量是不可被修改的,其值在定义后不能再被改变。
- 声明与赋值: 变量需要先声明,并可以在声明后进行赋值。声明时需要指定变量的类型 常量在定义时需要使用final关键字进行修饰
- 内存空间: 变量在内存中占用一块存储空间,可以改变这个存储空间中的值。 常量通常会被编译器在编译时直接替换为对应的值,所以在内存中不会为常量分配额外的存储 空间,而是直接使用常量的值。
- 使用场景: 变量用于存储会发生变化的数据,例如计数器、临时结果等,在程序的执行过程中可以根据需 要改变其值。 常量用于表示不可变的数据,例如数学常数、配置项等,在程序中通常希望保持其固定的值, 避免误操作导致值的变化。 备注:更进步讲,常量可分为编译时常量和运行时常量。编译时常量(基本类型+String字面量):编译 器会进行常量替换,不会在运行时分配内存;运行时常量(new创建的对象等)仍然需要分配内存
7. for-each与常规for循环的效率区别
在Java中,for-each循环(也称为增强型for循环)和常规for循环有一些差异,包括它们在执行效率上的 区别。下面是它们之间的一些比较:
- 执行效率:在大多数情况下,常规for循环的执行效率比for-each循环高。这是因为for-each循环需 要额外的步骤来获取集合或数组中的元素,而常规for循环可以直接通过索引访问元素,避免了额 外的开销。
- 可变性:常规for循环具有更大的灵活性,可以在循环过程中修改计数器,从而控制循环的行为。 而for-each循环是只读的,不能在循环过程中修改集合或数组的元素。
- 代码简洁性:for-each循环通常比常规for循环更加简洁易读,尤其在遍历集合或数组时。使用for- each循环可以减少迭代器或索引变量的声明和管理,使代码更加清晰。 尽管常规for循环在执行效率上可能更高,但在大多数实际情况下,两者之间的性能差异不会对程序性能 产生显著影响。因此,根据具体的使用场景和代码可读性的需求,可以选择使用for-each循环或常规for 循环。在只需要遍历集合或数组而不修改其中元素的情况下,for-each循环是一个方便且简洁的选择。
8. break与continue的区别
关键字
作用范围
核心效果
执行后跳转位置
break 循环(for/while/do- while)、switch 终止整个循环 /switch 循环 /switch 结构的下一 行代码 continue 仅循环(for/while/do- while) 跳过本次循环剩余代码, 继续下一次循环 for:先执行更新语句 (i++)再判断条件; while/do-while:直接判 断循环条件
方案
优点
缺点
适用场景
带标签的 break 代码简洁、直接、 效率高 新手可能觉得标签 “不直观” 绝大多数场景(官方推 荐) 标志位 逻辑更 “线性”,易 理解 需多定义变量,外层循环多 一次判断 团队规范禁止使用标签 的场景
9. 跳出循环时如何在内层循环跳出外层循环?
方案1:带标签的 break 方案2:标志位
publicclassLabelBreakDemo {
publicstaticvoidmain(String[] args) {
// 给外层循环添加标签:outerLoop(标签名自定义,符合变量命名规则即可)
outerLoop:for (inti=1; i<=3; i++) { // 外层循环:i从1到3
System.out.println("外层循环 i = "+i);
// 内层循环:j从1到3
for (intj=1; j<=3; j++) {
System.out.println("  内层循环 j = "+j);
// 触发条件:j=2时跳出外层循环
if (j==2) {
System.out.println("  触发条件,跳出外层循环!");
breakouterLoop; // 直接终止outerLoop标签对应的外层循环
}
}
}
System.out.println("循环结束");
}
}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
publicclassFlagBreakDemo {
publicstaticvoidmain(String[] args) {
// 定义布尔标志位:控制外层循环是否终止
booleanisQuit=false;// 外层循环:仅保留原本的i范围判断,移除标志位判断
for (inti=1; i<=3; i++) {
System.out.println("外层循环 i = "+i);
// 内层循环:j从1到3
for (intj=1; j<=3; j++) {
System.out.println("  内层循环 j = "+j);
1
2
3
4
5
6
7
8
9
10
10. 递归的定义和优缺点
递归算法是一种直接或者间接地调用自身算法的过程。 递归和循环是编程中实现「重复执行逻辑」的两种核心方式,二者本质等价。理论上所有递归都能转循 环,反之亦然 递归的实现必须满足 3 个核心条件,否则会导致无限递归、栈溢出等严重问题:
- 自调用(核心特征)
- 明确的递归出口(终止条件)
- 问题题规模递减(收敛性)
推荐使用递归的场景:
树形结构的遍历和操作(二叉树 / 多叉树的遍历(前序 / 中序 / 后序)、树形菜单解析、文件夹递 归遍历) 分治算法的实现(归并排序、快速排序) 问题本质具有递归特性(如汉诺塔) 代码可读性要求高于性能要求
优先使用循环的场景:
简单重复操作 大数据量处理 性能敏感的代码 递归深度可能很大的情况 递归优点:代码简洁直观,贴合分治 / 树形问题,编码简单; 递归缺点:性能开销大、易栈溢出、调试难度高。
// 触发条件:j=2时修改标志位
if (j==2) {
System.out.println("  触发条件,标记退出!");
isQuit=true; // 修改标志位为true
break; // 先终止内层循环
}
}
// 内层循环结束后,单独判断标志位,决定是否终止外层循环
if (isQuit) {
break; // 终止外层循环
}
}
System.out.println("循环结束");
}
}
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
// 树形遍历递归
voidtraverse(TreeNoderoot) {
if (root==null) return;
traverse(root.left);
System.out.println(root.val);
traverse(root.right);
}
// 转为循环+栈
1
2
3
4
5
6
7
8
9
11. 冒泡排序算法和代码实现
冒泡排序是入门级的排序算法,是交换排序的一种,核心思想非常形象 —— 就像水里的气泡会逐渐上浮 一样,每一轮遍历都会把当前未排序部分的最大元素”冒泡” 到正确的位置。
基本算法(以升序排序为例)
1)整个数列分成两部分:前面是无序数列,后面是有序数列 2)初始状态下,整个数列都是无序的,有序数列是空 3)如一个数列有n个元素,则至多需要n-1趟循环才能保证数列有序;至少需要1趟循环 4)每一趟循环可以让无序数列中最大数排到最后,(也就是说有序数列的元素个数增加1) 5)每一趟循环都从数列的第一个元素开始进行比较,依次比较相邻的两个元素,比较到无序数列的末尾 即可(而不是数列的末尾) 6)如果前一个大于后一个,交换 7)如果已经有序,可提前退出循环。定义一个符号量flag,默认有序true;发生交换置为false,一趟循 环结束后,根据flag的值判断是否有序;有序退出即可
voidtraverseLoop(TreeNoderoot) {
Stack<TreeNode>stack=newStack<>();
TreeNodecurr=root;
while (curr!=null||!stack.isEmpty()) {
while (curr!=null) {
stack.push(curr);
curr=curr.left;
}
curr=stack.pop();
System.out.println(curr.val);
curr=curr.right;
}
}
10
11
12
13
14
15
16
17
18
19
20
21
22
publicclassTestBubbleSort {
publicstaticvoidsort(int[] a) {
inttemp=0;
// 外层循环,它决定一共走几趟
for (inti=0; i<a.length-1; ++i) {//内层循环,它决定每趟走一次
for (intj=0; j<a.length-i-1 ; ++j) {//如果后一个大于前一个
if (a[j+1] <a[j]) {
//换位
temp=a[j];a[j] =a[j+1];a[j+1] =temp;
}
}
}
publicstaticvoidsort2(int[] a) {
inttemp=0;
for (inti=0; i<a.length-1; ++i) {
//通过符号位可以减少无谓的比较,如果已经有序了,就退出循环
intflag=0;
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
12. 选择排序算法和代码实现
选择排序也是一种最基本的排序算法,其算法思想如下: 1)整个数列分成两部分:前面是有序数列,后面是无序数列 2)初始状态下,整个数列都是无序的,有序数列是空 3)一共n个数,需要n-1趟循环(一趟都不能少) 4)每比较完一趟,有序数列数量+1,无序数列数量-1 5)每趟先假设无序数列的第1个元素(整个数列的第i个元素)是最小的,让当前的最小数,从第i+1个元 素开始比较,一直比较到最后一个元素。如果发现更小的数,就假设当前数是最小数。 6)一趟比较完后,将发现最小数和无序数列的第一个数交换(如果最小数不是无序数列的第一个数) 冒泡排序最多需要n-1趟循环,最少1趟循环;选择排序必须进行n-1趟循环,一趟也不能少 冒泡排序中最多的操作就是比较和交换,一趟循环中可能发生多次交换;而选择排序中最多的操作是比 较,一趟比较结束后如果发现更小的值才交换一次。
for (intj=0; j<a.length-1-i ; ++j) {
if (a[j+1] <a[j]) {
temp=a[j];a[j] =a[j+1];a[j+1] =temp;
flag=1;
}
}
if(flag==0){  break;}
}
}
}
21
22
23
24
25
26
27
28
29
30
publicclassTestSelectSort {
publicstaticvoidsort(intarr[]) {
inttemp=0;
for (inti=0; i<arr.length-1; i++) {
// 认为目前的数就是最小的, 记录最小数的下标
intminIndex=i;
for (intj=i+1; j<arr.length; j++) {
if (arr[minIndex] >arr[j]) {
// 修改最小值的下标
minIndex=j;
}
}
// 当退出for就找到这次的最小值
if (i!=minIndex) {
temp=arr[i];
arr[i] =arr[minIndex];
arr[minIndex] =temp;
}
}
}
}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
13. 直接插入排序的算法和代码实现
直接插入排序基本思想是:
仅有一个元素的序列总是有序的,因此,对 n 个记录的序列,可从第二个元素开始直到第 n 个元素,逐 个向有序序列中执行插入操作,从而得到 n 个元素按关键字有序的序列。 一般来说,在含有 j-1 个元素的有序序列中插入一个元素的方法是:从第 j-1 个元素开始依次向前搜索应 当插入的位置,并且在搜索插入位置的同时可以后移元素,这样当找到适当的插入位置时即可直接插入 元素
publicclassTestInsertSort {
publicstaticvoidsort(intarr[]) {
inti, j;
for (i=1; i<arr.length; i++) {
inttemp=arr[i];
for (j=i; j>0&&temp<arr[j-1]; j--) {
arr[j] =arr[j-1];
}
arr[j] =temp;
}
}
}
1
2
3
4
5
6
7
8
9
10
11
12
14. 说出成员变量和局部变量的区别
物理位置 成员变量: 类中方法外 局部变量: 方法中或方法定义的小括号里面 内存位置 成员变量: 在堆内存中 局部变量: 通常在栈内存中(栈帧) 生命周期 成员变量: 随着对象创建而产生,随着对象的消失而消失 局部变量: 随着方法的调用而产生,随着方法调用结束而消失 有无默认值 成员变量: 有默认值, 整数0,小数0.0 字符 ‘\u0000’ 布尔 false 引用数据类型 null 局部变量: 没有默认值,使用的时候,必须先赋值 备注:成员变量根据是否使用static修饰可分为静态成员变量和实例成员变量,以上分析针对后者
15. 静态成员变量与实例成员变量的区别
使用static修饰的成员变量称为静态成员变量,是属于某个类的;而不使用static修饰的成员变量成为实 例成员变量,是属于类的每个对象的。区别如下: 内存份数:不管有多少个对象,static变量只有1份。对于每个对象,实例变量都会有单独的一份 内存位置 : 静态变量在(jdk6在方法区中)/(jdk8在堆中),实例变量在堆内存中。 生命周期 : 静态变量随着.class文件加载而产生,随着.class文件结束而结束; 实例变量随着对象的创 建而产生,随着对象的结束而结束。 调用方式: 静态变量既可以通过类名.直接进行调用, 也可以通过对象名.进行调用; 实例变量只能通 过对象名.进行访问。 备注:静态成员变量和实例成员变量都是成员变量。局部变量不能使用static修饰
16. static关键字都能修饰什么?都有什么特点
一个类的成员包括变量、方法、构造方法、代码块和内部类,static可以修饰除了构造方法以外的所有
成员。 修饰成员变量, 叫静态变量具有共享性,节省内存空间; 修饰方法: 静态方法: 可以直接使用类名.进行调用; 修饰代码块: 静态代码块 ,给静态变量进行赋值;当类被第一次加载时执行静态代码块,且只被执行 一次
访问控制
public
protected
默认
private
同一类中成员 是 是 是 是 同一包中其它类 是 是 是 不同包中的子类 是 是 不同包中对非子类 是
英文
位置不同
作用不同
重 载 overload 同一个类中 在一个类里面为一种行为提供多种实现方式并提高可读性 重 写 override 子类和父类 间 父类方法无法满足子类的要求,子类通过方法重写满足要 求
修饰符
返回值
方法名
参数
抛出异常
重载 无关 无关 相同 不同 无关 重写 大于等于 小于等于 相同 相同 小于等于 修饰内部类: 静态内部类;属于整个外部类,而不是属于外部类的每个对象。不能访问外部类的非 静态成员,可以访问外部类的静态成员 备注:还有静态导入 import static java.lang.Math.*; 非导入类和接口,而是导入类和接口的静态成员
17. private/默认/protected/public权限修饰符的区别
这是Java中的四个权限修饰符,和面向对象的三大特征的封装性有密切关系。这四个修饰符都可以修饰 类的成员,另外其中的默认和public还可以修饰类。
修饰类的成员
修饰类
public:公共的可被同一项目中所有包的所有类访问。 (须与文件名同名) 默认:可被同一个包中的类访问。 备注:内部类属于类的成员,所以可以使用四个修饰符修饰,这一点和类不同
18. overload和override(重载和重写)的区别
核心区别:作用不同(解决的问题不同) 语法区别:一个方法的声明自左向右包括权限修饰符、方法返回值、方法名、参数列表、抛出的异常类 型等。下面从这几方面说明区别,不会有遗漏 重载举例:构造方法重载、println()方法重载 重写举例:Object类的toString()、equals()、hashCode()等都可以被子类重写 备注:静态方法无法进行方法重写,添加@override注解将会报错
19. this和super都能用到哪些地方
this是对象内部指代自身的引用,super代表对当前对象的直接父类对象的引用 1)、访问成员变量 this:可以区分成员变量与局部变量重名问题,如果本类没有这个成员变量,也可以调用父类的成员变量。 super:可以区分本类成员变量与父类成员变量重名问题,只能调用父类的成员变量。 2)、访问成员方法 this:可以调用本类的成员方法,如果本类没有这个成员方法,也可以调用父类的成员方法。 super:只能调用父类的成员方法。 3)、访问构造器 this:可以通过this() 或 this(参数) 让其本类的构造方法直接相互调用。 super:子类通过super() 或 super(参数) 调用父类的构造方法。
20. == 和 equals的区别
在Java中,”==“是一个比较操作符,用于比较两个变量的值是否相等。而”equals()“是Object类中定义
的方法,用于比较两个对象是否相等。
具体区别如下:
- ”==“用于比较基本数据类型和引用类型变量的地址值是否相等。对于基本数据类型,比较的是它们 的实际值;对于引用类型,比较的是它们所引用的对象的地址值。
- “equals()“方法用于比较两个对象的内容是否相等。默认情况下,它与”==“的作用相同,比较的是 对象的地址值。但是,可以根据具体的类重写该方法,以实现自定义的比较逻辑。
需要注意以下几点:
对于基本数据类型,使用”==“进行比较更加直接和高效。 对于引用类型,使用”equals()“进行比较更加准确和灵活,但需要注意重写”equals()“方法,以满足 自定义的比较需求。 总结起来,”==“比较的是变量的值或引用的地址值,而”equals()“比较的是对象的内容。
21. 构造器是否可被重写
构造器是 Java 中用于创建并初始化类的对象的特殊方法,与普通成员方法存在本质区别:构造器的名 称必须与所属类的类名完全一致,且没有任何返回类型(包括 void 也不能声明)。 在 Java 中,构造器完全不支持重写(Override)。重写的核心要求是子类定义与父类方法名、参数列 表完全一致的方法,而构造器因名称与类名强绑定,子类构造器的名称必然与父类不同(例如父类 Person 的构造器为Person() ,子类Student 的构造器只能是Student() ),根本无法满足重写的基 础条件;同时,构造器的核心作用是完成当前类对象的实例化与初始化,若允许重写,会破坏继承体系 中 “先初始化父类、再初始化子类” 的逻辑,导致对象创建和初始化过程混乱,违背类的设计原则。 不过,子类可以通过调用父类的构造器来完成父类成员的初始化操作。在子类构造器中,可通过super 关键字显式调用父类的无参或有参构造器(若未显式调用,编译器会默认在子类构造器第一行插入 super() ,调用父类无参构造器),并传递对应的初始化参数。这种方式能确保父类的构造器被正确执 行,从而完成父类属性的初始化,是子类复用父类初始化逻辑的合法方式。 总结来说,构造器本身不具备被重写的条件和可能,但子类可通过super 关键字调用父类构造器,实现 对父类成员的初始化,而非重写父类构造器的逻辑。
22. Java支持多继承么,为什么
Java不直接支持多继承,即一个类不能同时继承多个父类。这是由设计上的考虑和语言特性决定的。 Java中选择了单继承的设计,主要出于以下几个原因:
- 继承的复杂性:多继承会引入菱形继承等复杂性问题。当一个类同时继承自多个父类时,可能会出 现命名冲突、方法重复实现等问题,导致代码难以理解和维护。
- 接口的存在:Java提供了接口(Interface)的概念来解决多继承的问题。接口允许一个类实现多个 接口,从而达到类似多继承的效果。接口与类的分离可以降低代码的耦合度,并且使得类的设计更 加灵活和可扩展。
- 单一职责原则:Java鼓励使用组合而非继承的方式,遵循设计原则中的单一职责原则。通过将功能 划分为独立的类,然后在需要时进行组合,可以实现更灵活、可复用的代码结构,提高代码的可维 护性。 尽管Java不支持直接的多继承,但可以使用接口或抽象类等方式来模拟部分多继承的功能。接口提供了 一种更灵活、更安全的多继承方式,允许类实现多个接口并获得各个接口的方法声明,同时避免了多继 承的复杂性问题。
23. Object类的方法有哪些?
Object类是所有类的顶级类,能够放在Object类的中方法肯定不简单。非常常规的问题,打开IDEA直接 瞧一眼 toString() - 返回一个以字符串形式表示当前对象的信息。 equals() - 比较两个对象是否相等,默认 == hashCode() - 返回对象的hash值。目的是为了更好的支持哈希表,比如基于Java中的HashMap使 用 getClass() - 获取运行是的Class对象,属于反射的那一套,获取运行是的一些数据。 clone() - 创建对象的副本。深拷贝和浅拷贝的内容 默认是浅拷贝,将当前对象复制一份,其中的基本数据类型直接复用值,引用数据类型是复用 地址值。 深拷贝,将当前对象复制一份,其中的基本数据类型直接复用值,引用数据类型会重新的创建 一个,不会复制之前的地址。深拷贝要自己编写克隆内部的引用类型对象。 finalize() - 当触发垃圾回收时,如果当前对象无法基于可达性分析定位到,就会被垃圾回收器回收 掉,在回收之前,如果这个对象重写了finalize,那就会触发finalize方法执行。可以执行一些其他 的清理工作。(Finalize在JVM中,他不保证一定执行,他用的守护线程) wait() - 当某个线程持有当前对象锁时,可以执行对象锁.wait,将持有对象锁的线程挂起等待。 notify() - 当某个线程持有当前对象锁时,可以执行对象锁.notify,唤醒之前基于wait挂起的一个线 程。 notifyAl() - 当某个线程持有当前对象锁时,可以执行对象锁.notifyAll方法,唤醒之前所有基于wait 挂起的线程。 备注:9个方法中clone() 、finalize()是protected方法,其他都是public方法; 还有 hashCode()、getClass() 、clone()、wait()、notify()、notifyAl()共6个方法是native本地方法(Java 本身无法实现,需要调用C/C++实现的代码)
24. 为啥要有clone(克隆)?
Java中提供的clone方法主要是允许将一个对象进行copy,做到快速的复制一个对象。而不需要new一个 空对象,然后自己慢慢导入数据,开发效率太低。 这可以减少内存分配和垃圾回收的压力,尤其是在创建大量对象时。 默认的方法实现是浅拷贝。如果需要深拷贝,必须重写clone 方法,并在其中实现深拷贝的逻辑。 如果再问clone,基本就是聊聊深拷贝,和浅拷贝。 默认是浅拷贝,将当前对象复制一份,其中的基本数据类型直接复用值,引用数据类型是复用地址 值。 深拷贝,将当前对象复制一份,其中的基本数据类型直接复用值,引用数据类型会重新的创建一 个,不会复制之前的地址。深拷贝要自己编写克隆内部的引用类型对象。 备注:设计模式中的原型模式(prototype)是一种创建型设计模式,它就是通过克隆clone()已有对象 来快速创建新对象,而不是通过new关键字。
25. 浅拷贝和深拷贝
深拷贝和浅拷贝就是指对象的拷贝,一个对象中存在两种类型的属性,一种是基本数据类型,一种是实 例对象的引用。 1.浅拷贝是指,对基本数据类型进行值传递,对引用数据类型进行引用传递般的拷贝。 2.深拷贝是指,对基本数据类型进行值传递,对引用数据类型,创建一个新的对象,并复制其内容,此 为深拷贝。
浅拷贝例子:
packagese.copy;
classPhoneimplementsCloneable {
privateStringname;
1
2
3
4
publicStringgetName() {
returnname;
}
publicvoidsetName(Stringname) {
this.name=name;
}
@Override
protectedObjectclone() throwsCloneNotSupportedException {
returnsuper.clone();
}
}
classPersonimplementsCloneable {
privateStringname;
privatePhonephone;
publicStringgetName() {
returnname;
}
publicvoidsetName(Stringname) {
this.name=name;
}
publicPhonegetPhone() {
returnphone;
}
publicvoidsetPhone(Phonephone) {
this.phone=phone;
}
@Override
protectedObjectclone() throwsCloneNotSupportedException {
returnsuper.clone();
}
}
publicclassShallowCopy {
// 浅拷贝
publicstaticvoidmain(String[] args) throwsCloneNotSupportedException
{
Phonephone=newPhone();
phone.setName("小米");
// 创建一个Person对象(原对象)
Personperson=newPerson();
person.setName("hzk");
// 设置引用类型属性
person.setPhone(phone);
// 打印原对象的属性值
System.out.println(person);
System.out.println(person.getName());
System.out.println(person.getPhone());
System.out.println(person.getPhone().getName());
System.out.println("-----------------");
// 克隆一个Person对象(克隆对象)
PersoncopyPerson= (Person) person.clone();
// 打印克隆对象的属性值
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
运行结果:
深拷贝例子:
System.out.println(copyPerson);
System.out.println(copyPerson.getName());
System.out.println(copyPerson.getPhone());
System.out.println(copyPerson.getPhone().getName());
// 浅拷贝由于会拷贝引用数据类型的地址,因此修改拷贝对象的值,其被拷贝对象的值也会 跟着变化。反之,同理。
copyPerson.getPhone().setName("华为");
System.out.println("原对象的引用类型Phone值"+
person.getPhone().getName());
System.out.println("克隆对象的引用类型Phone值"+
copyPerson.getPhone().getName());
}
}
62
63
64
65
66
67
68
69
70
71
72
73
74
75
packagese.copy;
classPhone1implementsCloneable {
privateStringname;
publicStringgetName() {
returnname;
}
publicvoidsetName(Stringname) {
this.name=name;
}
@Override
protectedObjectclone() throwsCloneNotSupportedException {
returnsuper.clone();
}
}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
classPerson1implementsCloneable {
privateStringname;
publicStringgetName() {
returnname;
}
publicvoidsetName(Stringname) {
this.name=name;
}
publicPhone1getPhone() {
returnphone;
}
publicvoidsetPhone(Phone1phone) {
this.phone=phone;
}
privatePhone1phone;
@Override
protectedObjectclone() throwsCloneNotSupportedException {
//        return super.clone();
//继续利用clone()方法,对该对象的引用类型变量再实现一次clone()方法。 // 要想深克隆要不就是序列化和反序列化要不就是继续clone
Person1person= (Person1) super.clone();
person.setPhone((Phone1) person.getPhone().clone());
returnperson;
}
}
publicclassDeepCopy {
// 深拷贝
publicstaticvoidmain(String[] args) throws
CloneNotSupportedException{
Phone1phone1=newPhone1();
phone1.setName("小米");
Person1person1=newPerson1();
person1.setName("hzk");
person1.setPhone(phone1);
System.out.println(person1);
System.out.println(person1.getName());
System.out.println(person1.getPhone());
System.out.println(person1.getPhone().getName());
System.out.println("-----------------");
Person1copyPerson1= (Person1) person1.clone();
System.out.println(copyPerson1);
System.out.println(copyPerson1.getName());
System.out.println(copyPerson1.getPhone());
System.out.println(copyPerson1.getPhone().getName());
System.out.println("-----------------");
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
运行结果
26. final,finally,finalize的区别
在Java中,final、finally和finalize是三个不同的关键字,它们具有不同的作用和用法。
- final: final是一个修饰符,可以用于修饰类、方法和变量。 用于修饰类时,表示该类不能被继承,即为最终类。 用于修饰方法时,表示该方法不能被子类重写。 用于修饰变量时,表示该变量是一个常量,其值不能被修改。
- finally: finally是一个关键字,用于定义一个代码块,通常与try-catch结构一起使用。 finally块中的代码无论是否抛出异常,都会被执行。 finally块通常用于释放资源、关闭连接或执行必要的清理操作。
- finalize: finalize是Object类中的一个方法,被用于垃圾回收机制。 finalize方法在对象被垃圾回收之前被调用,用于进行资源释放或其他清理操作。 通常情况下,我们不需要显式地调用finalize方法,而是交由垃圾回收器自动调用。 总结: final是修饰符,用于限定类、方法和变量的性质。 // 深拷贝不会拷贝引用数据类型的地址(而是会创建一个新对象空间), //因此修改拷贝对象的值,其被拷贝对象的值不会跟着变化。反之,同理。
copyPerson1.getPhone().setName("华为");
System.out.println("原对象的引用类型Phone值---"+
person1.getPhone().getName());
System.out.println("克隆对象的引用类型Phone值---"+
copyPerson1.getPhone().getName());
}
}
76
77
78
79
80
81
82
83
finally是一个关键字,用于定义一个代码块,在异常处理中用于确保特定代码无论如何都会被执 行。 finalize是一个Object类中的方法,用于对象的垃圾回收前的清理操作。 备注:finalize方法已被废弃,不推荐使用。在现代Java中,可以使用try-with-resources语句或手动释 放资源的方式来替代finalize方法的功能。
27. Java 创建对象有几种方式
在 Java 中,有以下几种常见的方式来创建对象:
- 使用 new 关键字:这是最常见、最推荐的创建对象的方式。通过调用类的构造器(无参或有参均 可),使用 new 关键字可直接在堆内存中分配新的对象空间,并完成对象属性的初始化。
- 使用反射:Java 的反射机制允许在运行时动态创建对象。需先获取类的 Class 对象,再通过 Class 对象获取对应的 Constructor 构造器对象,最后调用构造器的 newInstance () 方法,即可实现对 象的动态创建。
- 使用 Class 类的 newInstance () 方法:这是反射创建对象的简化写法,仅适用于具有默认无参构 造器的类;需注意该方法在 Java 9 及以上版本已被标记为过时,推荐替换为 Constructor 类的 newInstance () 方法。
- 使用 clone () 方法:如果类实现了 Cloneable 接口(否则会抛出 CloneNotSupportedException 异常),就可以使用 clone () 方法创建已有对象的副本,该方式创建对象时不会调用类的构造器。
- 使用对象的反序列化:通过将实现了 Serializable 接口的对象序列化为字节流,再将字节流反序列 化,可还原出对象实例;该方式同样无需调用类的构造器,常用来实现对象的持久化或跨进程传 输。 其中,使用 new 关键字是最基础、最易维护的创建对象方式。其他方式通常在特定场景下使用:反射适 用于动态创建对象的场景(如框架开发),clone () 适用于快速复制已有对象的场景,反序列化适用于 对象跨介质复用的场景,而 Class.newInstance () 仅建议在兼容旧版代码时使用。
28. 多态的技能点(前提条件,向上转型、向下转型)
实现多态的三个条件
- 继承的存在;(继承是多态的基础,没有继承就没有多态)
- 子类重写父类的方法。(多态下会调用子类重写后的方法)
- 父类引用变量指向子类对象。(涉及子类到父类的类型转换)
向上转型 Person person = new Student()
- 将一个父类的引用指向一个子类对象,称为向上转型,自动进行类型转换。
- 此时通过父类引用变量调用的方法是子类覆盖或继承父类的方法,而不是父类的方法
- 此时通过父类引用变量无法调用子类特有的方法
向下转型 Student stu = (Student)person;
- 将一个指向子类对象的引用赋给一个子类的引用,称为向下转型,此时必须进行强制类型转换。
- 向下转型必须转换为父类引用指向的真实子类类型,否则将出现ClassCastException,不是任意的强 制转换
- 向下转型时可以结合使用instanceof运算符进行强制类型转换,比如出现ClassCastException异常。 备注:接口和实现类之间也可以实现多态,不见得必须是子类和父类之间
抽象类
接口
有单继承限制 没有单继承限制 有构造器 没有构造器 有成员变量 没有普通成员变量。只有公共的静态的常量。 可以包含抽象方法和普通方法。 JDK8 之前都是公共的抽象方法。 JDK8 之后允许有公共的静态方法和默认方法。 JDK9 之后允许有私有的方法。
29. 接口与抽象类的区别
抽象类和接口是Java中的两种机制,用于实现类之间的继承和多态性。它们有以下几点区别: 设计目的:抽象类的设计目的是提供类的继承机制,实现代码复用,适用于拥有相似行为和属性的 类;接口的设计目的是定义一组规范或契约,实现类遵循特定的行为和功能,适用于不同类之间的 解耦和多态性实现。继承抽象类体现的是”is-a”关系,而实现接口体现的是”can-do”关系。 定义和设计:抽象类是使用abstract关键字定义的类,可以包含抽象方法和非抽象方法,可以有实 例变量和构造方法;接口通过interface关键字定义,只能包含抽象方法、默认方法和静态方法,不 包含实例变量或构造方法。 继承关系:一个类只能继承自一个抽象类,但可以实现多个接口。 构造方法:抽象类可以有构造方法,子类可以通过super()调用父类的构造方法;接口没有构造方 法。 默认实现:抽象类可以包含非抽象方法,子类可以直接使用;接口可以包含默认方法,提供通用实 现,子类可以选择重写或者使用默认实现。 总之,抽象类和接口是实现继承和多态性的两种机制。抽象类和接口的设计目的、定义和使用方法等方 面都有所区别,需要根据实际情况选择合适的方式进行设计和使用。 把控细节:
抽象类:
例子(example):
packagese.abstracts;
publicabstractclassAbstractDemo {
// 抽象类和普通类基本没有区别(只是多了一个可以定义抽象方法)
privateinta;// 成员变量
privatestaticintb;//静态变量
privatestaticfinalintc=1;//常量
// 1.抽象类中静态方法—有方法的实现
publicstaticvoida() {
}
// 2.抽象类中构造方法
publicAbstractDemo(inta) {
this.a=a;
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
接口:
例子(example):
30. 说说你对内部类的理解
1) 什么是内部类?
}
// 3.抽象类中实例方法
publicvoidb() {
}
// 4.抽象类中定义一个抽象方法,注意没有方法实现体。
//public abstract void c(){ //fail
//
//}
publicabstractvoidc();// ok
}
18
19
20
21
22
23
24
25
26
27
28
29
30
31
packagese.abstracts;
publicinterfaceInterfaceDemoextendsInterfaceDemo1, InterfaceDemo2 {
// 1.接口中不能定义静态方法—但是可以有静态方法的实现
publicstaticvoida() {
}
//public static void b();//fail
// 2.接口中不可以定义构造方法
//public InterfaceDemo(){//fail
//
//}
// 3.接口中不可以定义实例方法(没有static  也没有abstract关键字)
//public void c();//fail
// 4.接口中不能定义变量—只能有常量
publicstaticfinalintd=1;
//public int x;//fail
// 5.接口中所有的默认方法都是public abstract修饰且访问修饰符必须要是public或者
不写,不写则使用默认(注意:默认指的不是default)
// 抽象类中的访问修饰符四种都可以(public protected private 不写)
voidworld();// public abstract
// 1.8允许接口中有方法的实现,但是必须用关键字default修饰
defaultStringhello() {
return"hello";
}
}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
内部类是Java中一种特殊的类,它定义在其他类或方法中,并且可以访问外部类的成员,包括私有成 员。它允许类之间共享代码和数据,同时可以提高代码的模块化和封装性。 内部类的主要作用是实现更加灵活和封装的设计。需要注意的是,过度使用内部类会增加代码的复杂 性,降低可读性和可维护性。因此,在使用内部类时要考虑其是否真正有必要,并且仔细进行设计和命 名。 内部类是 Java 中一个非常重要的特性,它允许在一个类的内部定义另一个类。内部类在实际开发中有很 多应用场景,比如事件处理、封装和模块化设计等。以下是一些常见的面试问题和答案,帮助你深入理 解内部类。 案例:
2) 内部类的类型有哪些?
内部类分为如下几种: 成员内部类:定义在一个类的内部,并且不是静态的。成员内部类可以访问外部类的所有成员,包 括私有成员。在创建内部类对象时,需要先创建外部类对象,然后通过外部类对象来创建内部类对 象。 静态内部类:定义在一个类的内部,使用static关键字修饰的内部类。与成员内部类不同,静态 内部类不能访问外部类的非静态成员,但可以访问外部类的静态成员。在创建静态内部类对象时, 不需要先创建外部类对象,可以直接通过类名来创建。 局部内部类:定义在一个方法或作用域块中的类,它的作用域被限定在方法或作用域块中。局部内 部类可以访问外部方法或作用域块中的 final 变量和参数。 匿名内部类:没有定义名称的内部类,通常用于创建实现某个接口或继承某个类的对象。匿名内部 类会在定义时立即创建对象,因此通常用于简单的情况,而不用于复杂的类结构。
3) 成员内部类
成员内部类是定义在类内部的类,可以直接访问外部类的成员变量和方法。
publicclassOuterClass {
privateintouterField=10;
// 成员内部类
classInnerClass {
publicvoiddisplay() {
System.out.println("Outer field: "+outerField);
}
}
publicstaticvoidmain(String[] args) {
OuterClassouter=newOuterClass();
OuterClass.InnerClassinner=outer.newInnerClass();
inner.display();
}
}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
publicclassOuterClass {
privateintouterField=10;
classInnerClass {
publicvoiddisplay() {
System.out.println("Outer field: "+outerField);
}
}
1
2
3
4
5
6
7
8
4) 静态内部类
静态内部类使用static关键字修饰,它不能访问外部类的非静态成员变量和方法。
5) 局部内部类
局部内部类定义在方法或构造函数中,只能在定义它的作用域内使用。
6) 匿名内部类
匿名内部类没有类名,通常用于实现接口或继承类。它常用于简化代码,特别是在事件处理中。
publicstaticvoidmain(String[] args) {
OuterClassouter=newOuterClass();
OuterClass.InnerClassinner=outer.newInnerClass();
inner.display();
}
}
9
10
11
12
13
14
15
publicclassOuterClass {
privatestaticintstaticField=20;
staticclassStaticInnerClass {
publicvoiddisplay() {
System.out.println("Static field: "+staticField);
}
}
publicstaticvoidmain(String[] args) {
OuterClass.StaticInnerClassstaticInner=new
OuterClass.StaticInnerClass();
staticInner.display();
}
}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
publicclassOuterClass {
publicvoidcreateInnerClass() {
classLocalInnerClass {
publicvoiddisplay() {
System.out.println("Local Inner Class");
}
}
LocalInnerClasslocalInner=newLocalInnerClass();
localInner.display();
}
publicstaticvoidmain(String[] args) {
OuterClassouter=newOuterClass();
outer.createInnerClass();
}
}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
7) 内部类的作用是什么(优点)?
内部类的主要作用包括: 封装性:将内部类定义为private类,它的作用范围只限于当前外部类,这是更小的类的访问范围。 外部类只能使用默认和public修饰。
内部类可以直接访问外部类的成员,哪怕是private
间接实现多重继承:外部类、多个内部类可以分别实现不同的父类。 用匿名内部类实现回调功能 解决继承及实现接口出现同名方法的问题 事件处理:内部类常用于 GUI 编程中的事件处理。 简化代码:匿名内部类可以简化代码,特别是在实现接口时。
8) 内部类的缺点是什么?
复杂性:内部类的生命周期与外部类相关联,可能会导致内存泄漏。 性能开销:内部类会增加内存占用,因为每个内部类实例都包含对外部类实例的引用。
9) 内部类的生命周期
内部类的生命周期与外部类的实例相关联。非静态内部类的实例必须依附于外部类的实例,而静态内部 类的实例可以独立存在。
10) 内部类在实际开发中的应用
内部类在实际开发中非常常用,尤其是在以下场景: 事件处理:在 GUI 编程中,内部类常用于事件监听器的实现。 封装:内部类可以封装相关代码,提高代码的模块化。 简化代码:匿名内部类可以简化代码,特别是在实现接口时。
publicclassAnonymousInnerClassExample {
publicstaticvoidmain(String[] args) {
Consumer<String>consumer=newConsumer<String>() {
@Override
publicvoidaccept(Strings) {
System.out.println("Consumed: "+s);
}
};
consumer.accept("Hello, Anonymous Inner Class!");
}
}
1
2
3
4
5
6
7
8
9
10
11
publicclassOuterClass {
classInnerClass {
// 非静态内部类必须依附于外部类的实例
}
staticclassStaticInnerClass {
// 静态内部类可以独立存在
}
}
1
2
3
4
5
6
7
8
9
importjavax.swing.*;
importjava.awt.event.ActionEvent;
importjava.awt.event.ActionListener;
1
2
3
4
总结
内部类是 Java 中一个非常强大的特性,它允许在类内部定义另一个类,从而实现更紧密的封装和模块化 设计。在面试中,理解内部类的基本概念、类型、优缺点以及应用场景是非常重要的。
31. 静态内部类与非静态内部类有什么区别
在Java中,静态内部类和非静态内部类都是一种嵌套在其他类中的内部类。它们之间有以下几点区别:
- 实例化方式:静态内部类可以直接通过外部类名来实例化,而非静态内部类必须要通过外部类的实 例来实例化。
- 对外部类的引用:静态内部类不持有对外部类实例的引用,而非静态内部类则会持有对外部类实例 的引用。这意味着在静态内部类中不能直接访问外部类的非静态成员(方法或字段),而非静态内 部类可以。
- 生命周期:静态内部类的生命周期与外部类相互独立,即使外部类实例被销毁,静态内部类仍然存 在。非静态内部类的生命周期与外部类实例绑定,只有在外部类实例存在时才能创建非静态内部类 的实例。
- 访问权限:静态内部类对外部类的访问权限与其他类一样,根据访问修饰符而定。非静态内部类可 以访问外部类的所有成员,包括私有成员。
publicclassGUIExample {
publicstaticvoidmain(String[] args) {
JFrameframe=newJFrame("Button Example");
JButtonbutton=newJButton("Click Me");
// 使用匿名内部类实现事件监听器
button.addActionListener(newActionListener() {
@Override
publicvoidactionPerformed(ActionEvente) {
System.out.println("Button clicked!");
}
});
frame.add(button);
frame.setSize(300, 200);
frame.setDefaultCloseOperation(JFrame.EXIT_ON_CLOSE);
frame.setVisible(true);
}
}
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
32. 异常结构图
Throwable分为两大类:
- Error类,表示仅靠程序本身无法恢复的严重错误,比如说内存溢出、动态链接异常、虚拟机错 误。应用程序不应该抛出这种类型的对象。假如出现这种错误,除了尽力使程序安全退出外,在其 他方面是无能为力的。所以在进行程序设计时,应该更关注Exception类。
- Exception类,由Java应用程序抛出和处理的非严重错误,比如所需文件没有找到、零作除数,数 组下标越界等。它的各种不同子类分别对应不同类型异常。可分为两类:Checked异常和Runtime 异常
Exception异常分为两大类
- 运行时异常:包括RuntimeaException及其所有子类。不要求程序必须对它们作出处理,比如 ArithmeticException、NullPointerException等。即使没有使用try-catch或throws进行处理,仍 旧可以进行编译和运行。如果运行时发生异常,会输出异常的堆栈信息并中止程序执行。
- Checked异常(检查异常):除了运行时异常外的其他异常类都是Checked异常。程序必须捕获或 者声明抛出这种异常,否则出现编译错误,无法通过编译。处理方式包括两种:通过try-catch捕获 异常,通过throws声明抛出异常从而交给上一级调用方法处理。
33. 有哪些常见的运行时异常
运行时异常是在 Java 程序运行过程中才会出现的异常,通常情况下不需要进行 try-catch 处理。以下是6 个常见的运行时异常: 空指针异常(NullPointerException):当应用程序尝试使用 null 对象时抛出。 数组越界异常(ArrayIndexOutOfBoundsException):当应用程序尝试访问数组元素的时候, 数组下标超出了数组的范围。 类型转换异常(ClassCastException):当应用程序尝试将一个对象强制转换为不是其实例的子 类时抛出。 非法参数异常(IllegalArgumentException):当应用程序传递一个无效或不合法参数时抛出。 算术异常(ArithmeticException):比如除数为0。 数字格式异常(NumberFormatException):字符串转数字格式错误,如int num = Integer.parseInt(“abc”); 这些异常是在程序运行过程中出现的,并且多数情况下是由于编程错误造成的。因此,在编写 Java 程序 时,应该避免出现这些异常。如果必须出现,也应该在代码设计时加以处理,避免对应用程序的正常运 行造成影响。
34. Java中的异常处理机制是怎样的
异常是在程序执行过程中可能出现的错误或意外情况。它们通常表示了程序无法正常处理的情况,如除
零错误、空指针引用、文件不存在等。
Java中的异常处理机制通过使用try-catch-finally语句块来捕获和处理异常。具体的处理过程如下:
- 使用try块包裹可能会抛出异常的代码块。一旦在try块中发生了异常,程序的控制流会立即跳转到 与之对应的catch块。
- 在catch块中,可以指定捕获特定类型的异常,并提供相应的处理逻辑。如果发生了指定类型的异 常,程序会跳转到相应的catch块进行处理。一个try块可以有多个catch块,分别处理不同类型的异 常。
- 如果某个catch块成功处理了异常,程序将继续执行catch块之后的代码。
- 在catch块中,可以通过throw语句重新抛出异常,将异常交给上一级的调用者处理。
- 可以使用finally块来定义无论是否发生异常都需要执行的代码。finally块中的代码始终会被执行, 无论异常是否被捕获。 通过合理使用异常处理机制,可以使程序更具健壮性和容错性。在处理异常时,应根据具体情况选择是 恢复正常执行、报告错误给用户,还是终止程序运行。同时,应避免过度捕获异常和不处理异常导致的 问题,以及使用异常替代正常程序流程控制的做法。 备注:try-catch是正确的语法,比较常见;try-finally也是正确的语法,但是很少见
35. throw和throws 的区别
throw 是具体抛出一个异常对象,在方法的内部, 后面有且只能有一个异常对象,代码一旦遇到了throw证 明出现了问题,代码就会停止,线程会异常退出。 throws 是异常的声明, 在方法定义的小括号后面,后面可以跟多个异常的类型,方法有throws,代码不一定 发生异常。 作用不同:throw用于程序员自行产生并抛出异常;throws用于声明在该方法内抛出了异常 使用的位置不同:throw位于方法体内部,可以作为单独语句使用;throws必须跟在方法参数列表 的后面,不能单独使用。 内容不同:throw抛出一个异常对象,且只能是一个;throws后面跟异常类,而且可以有多个。
36. int和Integer的区别
int和Integer之间的区别主要在以下几个方面:
- 数据类型:int是Java的基本数据类型,而Integer是int的包装类,属于引用类型。
- 可空性:int是基本数据类型,它不能为null。而Integer是一个对象,可以为null。
- 自动装箱与拆箱:int可以直接赋值给Integer,这个过程称为自动装箱;而Integer也可以直接赋值 给int,这个过程称为自动拆箱。
- 性能和内存开销:由于int是基本数据类型,它的值直接存储在栈内存中,占用的空间较小且访问速 度快。而Integer是对象,它的值存储在堆内存中,占用的空间相对较大,并且访问速度较慢。因 此,频繁使用的整数推荐使用int,不需要使用对象特性时可以避免使用Integer。
- Integer提供了多个与整数相关的操作方法,例如,将一个字符串转换成整数,Integer中还定义了 表示整数的最大值和最小值的常量 总的来说,int是基本数据类型,适用于简单的整数运算和存储,没有对象的特性和可空性。而Integer是 int的包装类,可以作为对象使用,具有更多的方法和一些方便的功能,如转换、比较等,但相对会带来 一些性能和内存开销。
37. 包装类的拆箱装箱
装箱(boxing):将基本类型转换成包装类对象。比如:Integer i1 = new Integer(100); Integer i1 = Integer.valueOf(100); 拆箱(unboxing):将包装类对象转换成基本类型的值。比如:int intValue = i.intValue(); JDK1.5开始支持自动装箱(autoboxing)和自动拆箱(autounboxing)功能, 从而实现了包装类和基本 数据类型之间的自动转换
例子(example):
packagese.packing;
publicclassIntAndIntegerDemo {
publicstaticvoidmain(String[] args) {
// 一组:两个Integer对象比较
// 结论:两个对象比较地址一定不等,则结果为false
Integerinteger=newInteger(66);
Integerinteger1=newInteger(66);
System.out.println(integer==integer1);
// 二组:Integer类型属性值和int属性值比较
//结论:包装类Integer和基本数据类型比较的时候,将包装类自动拆箱为int,然后进行 //比较,本质就是两个int变量进行比较,只要两个变量的值相等,则结果就为true
Integerinteger2=newInteger(88);
//Integer a = 88;
inti=88;
System.out.println(integer2==i);
// 三组:new Integer()类型变量值和Integer类型的变量值比较
// 结论:new Integer() 堆中地址 Integer 常量池中地址,地址不等
Integerinteger3=newInteger(88);
Integerj=88;
System.out.println(integer3==j);
// 四组:Integer类型的变量值和Integer类型的变量值(范围在:[-128~127]相等,)
// 其它则不相等会创建新的Integer对象
Integerk=-129;
Integerl=-129;
System.out.println(k==l);
}
}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
java为什么要引入自动装箱和拆箱的功能?主要是用于java集合中,Listlist=new ArrayList(); list集合如果要放整数的话,只能放对象,不能放基本类型,因此需要将整数自动装箱成对象。
38. 说说你对Integer缓存的理解
在Java中,Integer类对于一定范围的整数值进行了缓存。该范围默认是从-128到127。这意味着当创建 一个Integer对象并赋值为在此范围内的整数时,会直接从缓存中返回该数字对应的Integer对象,而不 会每次都创建新的对象。 这种缓存的设计主要是出于性能和内存优化的考虑。由于整数在编程中经常被使用,通过缓存重用 Integer对象可以减少频繁创建和销毁对象带来的开销,同时节省了内存空间。因为缓存中的对象是提前 创建好的,所以可以直接复用,不需要每次创建新的对象。 需要注意的是,虽然缓存的范围可以通过参数进行调整,但这个范围是有限制的,超出范围的整数仍然 会创建新的Integer对象。因此,在使用==比较Integer对象时,推荐使用.equals()方法进行值的比较, 以避免因为缓存机制而产生的意外结果。 Integer缓存的具体实现是Integer类中的静态内部类IntegerCache,该类全部源码如下
publicfinalclassIntegerextendsNumber
implementsComparable<Integer>, Constable, ConstantDesc {
privatestaticclassIntegerCache {
staticfinalintlow=-128;
staticfinalinthigh;
staticfinalInteger[] cache;
staticInteger[] archivedCache;
static {
// high value may be configured by property
inth=127;
StringintegerCacheHighPropValue=
VM.getSavedProperty("java.lang.Integer.IntegerCache.high");
if (integerCacheHighPropValue!=null) {
try {
h=Math.max(parseInt(integerCacheHighPropValue), 127);
// Maximum array size is Integer.MAX_VALUE
h=Math.min(h, Integer.MAX_VALUE- (-low) -1);
} catch( NumberFormatExceptionnfe) {
//If the property cannot be parsed into an int,ignore it.
}
}
high=h;
// Load IntegerCache.archivedCache from archive, if possible
CDS.initializeFromArchive(IntegerCache.class);
intsize= (high-low) +1;
// Use the archived cache if it exists and is large enough
if (archivedCache==null||size>archivedCache.length) {
Integer[] c=newInteger[size];
intj=low;
for(inti=0; i<c.length; i++) {
c[i] =newInteger(j++);
}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
39. String,StringBuilder 与 StringBuffer 的区别
三者均是Java中用来处理字符串的类,它们之间的主要区别如下:
- 可变性: String是不可变的类,一旦创建就不能被修改。每次对String进行操作时,都会创建一个新的 String对象。 StringBuffer和StringBuilder是可变的类,可以动态修改字符串内容。
- 线程安全性: String是线程安全的,因为它是不可变的。多个线程可以同时访问同一个String对象而无需担 心数据的修改问题。 StringBuffer是线程安全的,它的方法使用了synchronized关键字进行同步,保证在多线程 环境下的安全性。 StringBuilder是非线程安全的,不使用synchronized关键字,所以在多线程环境下使用时需 要手动进行同步控制。
- 性能: 由于String是不可变的,每次对String进行操作都会创建一个新的String对象,频繁的字符串 拼接会导致大量的对象创建和内存消耗。 StringBuffer是可变的,对字符串的修改是在原有对象上进行,不会创建新的对象,因此在频 繁的字符串拼接场景下比String更高效。 StringBuilder与StringBuffer类似,但不保证线程安全性,因此在单线程环境下性能更高。 综上,如果在单线程环境下进行字符串操作,且不需要频繁修改字符串,推荐使用String;如果在多线 程环境下进行字符串操作,或者需要频繁修改字符串,优先考虑使用StringBuffer;如果在单线程环境 下进行频繁的字符串拼接和修改,推荐使用StringBuilder以获取更好的性能。 备注:String、StringBuffer、StringBuilder都被定义为final类
40. String 与new String有什么区别
Java中字符串可以通过两种方式创建:使用字符串字面量直接赋值给变量或使用关键字new创建一个新 的String对象。它们之间有以下区别:
archivedCache=c;
}
cache=archivedCache;
// range [-128, 127] must be interned (JLS7 5.1.7)
assertIntegerCache.high>=127;
}
privateIntegerCache() {}
}
}
37
38
39
40
41
42
43
44
45
46
对比维度
字面量”Hello” newString(“Hello”)
存储位置
字符串常量池 堆内存
对象创建
首次出现时在常量池创建,之后复用 每次new都创建新对象
内存效率
高(复用) 低(重复创建)
引用比较(==)
相同字面量指向同一对象 不同对象,指向不同
内容比较(equals)
相同内容返回true 相同内容返回true
41. String类能被继承吗,为什么
在Java中,String类是被final关键字修饰的,即不可继承。final关键字表示一个类不允许被其他类继 承,也就是说,String类不能被任何其他类继承。 这是因为String类具有不可变性和安全性,这些特性可以防止一些潜在的问题,如字符串池中的重用和 安全性漏洞。 如果String类能被继承,子类有可能修改原字符串的值,这将破坏字符串对象的不可变性。 另外String类内部使用private final char[] value来存储字符,这个数组不对外暴露,确保了不可变性。 因此,尽管我们不能从String类派生出新的子类,但我们可以使用String类提供的方法来操作和处理字符 串。例如,我们可以使用String类的concat()方法连接两个字符串,或使用indexOf()方法查找子串在字 符串中的位置等。String类已经包含了大量的方法,可以满足大多数字符串操作的需求。
42. 金额到底用Long还是Bigdecimal
首先float和double肯定是排除的,因为它们内部使用科学计数法,转换二进制的时候有可能出现无限小 数位的问题。那么大家就会选择Long和BigDecimal, Long类型在存储时(比如保留2位小数点)x100, 取 出来/100。其实本质都是一样的,都是避免使用浮点数进行表达,只是Long属于隐式设定小数点, BigDecimal属于显式设定小数点。那么这2种到底怎么选择呢? 我的建议是:在代码层面用BigDecimal ,数据库层面可视情况定 首先long性能更好: 整数类型(如long)通常在计算机硬件上的性能更好,因为它们的操作可以在硬件层面上更有效 地执行。 BigDecimal需要额外的空间和计算开销。 阿里的ava开发手册是推荐用分存储的,希望大家都能用Long存储分,照顾一下彼此的开发体验。但是 对于一些金融系统要求小数点位数要求比较多,比如精确后六位,如果每次存x1000000 那long类型 的内存开销也荡然无存了也会降低可读性即易用性,不如用Decimal
43. 使用String或StringBuffer实现具体功能示例
功能:编写一段Java程序,把一句英语中的每个单词中的字母次序倒转,单词次序保持不变,例入输入 为”There is a dog.”,输出结果应该是”erehT si a god.”要求不使用Java的库函数,例如String类的split, reverse方法 思路:将字符串转化成字符数组,然后根据数组中空格的位置判断每个单词所占的索引范围,根据得到 的索引将数组中的每个单词逆序后拼接到新的字符串中。
44. 日期格式化用yyyy还是YYYY
一个工作6年的小伙伴日期时间格式化还在写大写YYYY,你是真的没踩过雷啊! 如果你现在还在用大写YYYY格式化日期,那赶紧换成小写yyyy。 有什么区别?踩过雷的我来告诉你!通常情况下可能没问题,但是在跨年的时候大概率就会有问题了。 你可以尝试把“2024-12-31 23:59:59”通过大写Y和小写Y进行格式化,会发现大写Y的日期2024年变成了 2025年,为什么会这样呢? 原因很简单,大写的YYYY表示一个基于周的年份。它是根据周计算的年份,而小写的yyyy是基于日历的 年份。 所以通常情况下,你就发现不了什么问题,但在跨年的第一周或最后一周可能会有差异。
45. JDK8的新特性
interface的新特性:(不需要说太细,点一嘴,他没啥扩展的。)
publicclassTestStringReverse {
publicstaticvoidmain(String[] args) {
Stringinput="we should study hard";
System.out.println("逆转后的字符串为:"+reverseWords(input));
}
publicstaticStringreverseWords(Stringinput) {
StringBufferbuffer=newStringBuffer("");
//将字符串转化成字符数组
char[] arr=input.toCharArray();
//index用来记录每个单词的起始索引
intindex=0;
//遍历字符数组,将空格前边的单词挨个拼接到str中
for (inti=0; i<arr.length; i++) {
if (arr[i] ==' ') {
//根据空格位置将空格前边一个单词密续追加到str中
for (intj=i-1; j>=index; j--) {
buffer.append(arr[j]);
}
//单词拼接完成后,拼接一个空格
buffer.append(" ");
//让index指向下一个单词的起始位置
index=i+1;
}
}
//将最后一个单词拼接上
for (inti=arr.length-1; i>=index; i--) {
buffer.append(arr[i]);
}
returnbuffer.toString();
}
}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
default关键字:可以规避接口中必须要重写的这点,一些不必要的方法,不常用的方法,可以来个 default给予默认的实现。 static关键字:可以在接口中提供直接访问的方法,给予接口名.方法,去调用。
时间类新特性:
支持时区,ZonedDateTime类,允许你方便的处理不同时区的信息。不需要三方依赖库。 线程安全性,他一旦创建是不可变的,线程安全,可以在并发环境中用! 更丰富的API,之前Date需要配置Calender去做一些时间处理,而现在,java.time包下的时间类, API嘎嘎丰富。 但是注意一点,在使用time包下的时间时,注意指定好序列化JSON的序列化格式。。。。。
lambda,Stream
lambda Stream
HashMap的红黑树结构变化
HashMap在JDK 1.8中引入红黑树后,其结构变化主要体现在链表树化、红黑树拆分和红黑树退化 三个核心环节 一个语法糖,让代码看着更舒服,比如匿名内部类,不需要再去new 接口,重新抽象方法了。 提高一些可读性,看着更舒服,并且利用它支持函数式编程和stream
1
2
链式调用,舒服的一批,还提供了各种丰富的中间操作,map,filter等等,然后可以可以上一个 collect结束整个流操作。 而且操作结果时,过滤,映射,规约,排序,匹配等等,嘎嘎好用。 但是需要一定的学习成本。
1
2
3
特性
数组(Array)
集合(Collection)
数据结
构
底层结构唯一,就是顺序表,分 配连续的空间 多种底层结构供选择:顺序表、双向链表、哈希 表、红黑树等
长度
固定长度(初始化时指定,不可 修改) 动态长度(自动扩容 / 缩容,无需手动指定)
存储类
型
可存储基本类型(int、char 等) 或引用类型 只能存储引用类型(基本类型需用包装类,如 Integer)
类型安
全
编译期检查类型 泛型加持后,编译期严格检查类型,避免类型转 换错误
功能 /
方法
仅提供长度属性(length),无 内置操作方法 提供丰富的操作方法 (size/add/remove/contains/sort 等)
遍历方
式
普通 for 循环、增强 for 循环 普通 for、增强 for、迭代器(Iterator)、 Lambda(Java 8+)
适用场
景
数据量固定、追求极致性能(如 底层实现) 数据量动态变化、需要频繁增删 / 查询操作
46. 流的使用
list.stream().filter(n->n%2==0)   // 过滤元素 → 过滤出偶数 [2,4]
list.stream().map(n->n*2)           // 元素转换 → [2,4,6,8]
List<List<Integer>>lists=Arrays.asList(Arrays.asList(1,2),
Arrays.asList(3,4)); lists.stream().flatMap(Collection::stream) //扁平化映射(将每个
元素转为Stream后合并)→ [1,2,3,4]
Arrays.asList(1,2,2,3).stream().distinct() // 去重(基于 equals ())  → [1,2,3]
47. 四个内置函数式接口
48. 四种方法引用赋值
List<String>list=Arrays.asList("a", "b", "c");// 传统方式
for (Strings : list) {
System.out.println(s);
}
// Lambda简化
list.forEach(s->System.out.println(s));
// 进一步简化(方法引用):list.forEach(System.out::println)
List<Integer>numList=Arrays.asList(1,2,3,4,5);
// Lambda实现:过滤偶数 -> 乘以2 -> 求和
intsum=numList.stream()
.filter(n->n%2==0) // 单参数省略括号
.map(n->n*2)         // 单行代码省略大括号/return
.reduce(0, (a,b) ->a+b);
System.out.println(sum); // 输出:2+4 → 4+8=12
方法引用类型
格式
核心特点
示例
静态方法引用 类名::静态方法 名 无实例依赖,直接引用类方 法 Integer::parseInt 实例方法引用 对象::实例方法 名 依赖特定对象的实例方法 System.out::println 特定类型实例方法引 用 类名::实例方法 名 任意该类型对象的实例方法 String::length 构造方法引用 类名::new 引用构造方法,创建对象 ArrayList::new
49. 异常类都有哪些
Throwable接口: Error(系统错误) Exception (异常) RuntimeException(运行时异常,非受检) NPE、数组 / 字符串越界 CheckedException(编译时异常,受检) IO 异常、数据库异常、类型转换异常 处理核心:RuntimeException 侧重预防,CheckedException 必须显式捕获 / 声明,Error 无需 处理。
50. 类的加载机制
类从被加载到 JVM 内存中,到卸载出内存,整个生命周期包含加载、验证、准备、解析、初始化 5 个 核心阶段 类加载器分类: 双亲委派模型(核心规则) 逻辑:类加载时,先委托父加载器加载,父加载器加载失败(找不到类),子加载器才自己加载; 优势:避免类重复加载,保证核心类(如java.lang.String )不被篡改(沙箱安全);
二、集合
51. 集合与数组的区别
52. Java集合框架是什么?说出集合框架的一些优点?
答:每种编程语言中都有集合,最初的Java版本包含几种集合类:Vector、Stack、HashTable等。随着 集合的广泛使用,Java1.2提出了囊括所有集合接口和实现类、算法的集合框架。 在保证线程安全的情况下使用泛型和并发集合类,Java已经经历了很久。 集合框架的部分优点如下: (1)使用核心集合类降低开发成本,而非实现我们自己的集合类。 (2)使用经过严格测试的集合框架类,代码质量会得到提高。 (3)通过使用JDK附带的集合类,可以降低代码维护成本。 (4)复用性和可操作性。
53. 集合接口的常见实现类
1、List接口的实现类 List接口的实现类最常用的有ArrayList和LinkedList、Vector ArrayList类实现了可变的数组,可以根据索引位置对集合进行快速的随机访问。 LinkedList类采用双向链表结构保存对象,便于向集合中插入和删除对象,但是如果将元素插入到集合 的尾部,其实ArrayList远比LinkedList快。 Vector:也是List的一个常见实现类,但是在该类中的大多数方法都加了synchronized关键字,因此相比 ArrayList、LinkedList集合在多线程访问时是线程安全的。 2、Set接口的实现类 Set接口的实现类常用的有HashSet和TreeSet、LinkedHashSet。它们的元素都不可重复。 HashSet:底层是哈希表,遍历元素和添加顺序、大小顺序无关。 TreeSet:底层是红黑树,元素按照大小顺序存储和遍历。 LinkedHashSet:底层是哈希表+双链表,遍历元素可以体现添加时顺序。顺序性是体现和HashSet不同 之处。
54. Map接口的实现类
Map接口的实现类常用的有HashMap、LinkedHashMap和TreeMap。它们的key都不可重复。这里面 的key不可重复,指的是容器中同一个Key只会存在一个。 HashMap:哈希表,底层是数组+链表+红黑树。遍历元素和添加顺序、大小顺序无关。 LinkedHashMap:哈希表+双链表,遍历元素可以体现添加顺序。 TreeMap:红黑树,元素按照key大小顺序存储和遍历。
例子(example):
55. List、Map、Set三个接口存取元素时,各有什么特点?
packagese.collect.map;
importjava.util.*;
importjava.util.concurrent.ConcurrentHashMap;
publicclassMapDemo1 {
publicstaticvoidmain(String[] args) {
System.out.println("input          1 : 1     3 : 3     2 : 2     4 :
4     5 : 5");
//HashMap
Map<String, String>hashMap=newHashMap<String, String>();
hashMap.put("1", "1");
hashMap.put("3", "3");
hashMap.put("2", "2");
hashMap.put("4", "4");
hashMap.put("5", "5");
System.out.print("HashMap        ");
for (Stringkey : hashMap.keySet()) {
System.out.print(key+" : "+hashMap.get(key) +"     ");
}
System.out.println();
//LinkedHashMap
Map<String, String>linkedHashMap=newLinkedHashMap<String,
String>();
linkedHashMap.put("1", "1");
linkedHashMap.put("3", "3");
linkedHashMap.put("2", "2");
linkedHashMap.put("4", "4");
linkedHashMap.put("5", "5");
System.out.print("LinkedHashMap  ");
for (Stringkey : linkedHashMap.keySet()) {
System.out.print(key+" : "+linkedHashMap.get(key) +"
");
}
System.out.println();
//TreeMap
Map<String, String>treeMap=newTreeMap<String, String>();
treeMap.put("1", "1");
treeMap.put("3", "3");
treeMap.put("2", "2");
treeMap.put("4", "4");
treeMap.put("5", "5");
System.out.print("TreeMap        ");
for (Stringkey : treeMap.keySet()) {
System.out.print(key+" : "+treeMap.get(key) +"     ");
}
System.out.println();
}
}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
List与Set具有相似性,它们都是单列元素的集合,所以,它们有一个共同的父接口,叫Collection。 Set是无序且不可重复的。Set取元素时,不能通过索引访问元素,只能通过for-each循环或者迭代器逐 一遍历各个元素。 List表示有先后顺序的集合,可重复。注意,不是那种按年龄、按大小、按价格之类的排序。当我们多 次调用add(Object e)方法时,每次加入的对象就像火车站买票有排队顺序一样,按先来后到的顺序排 序。有时候,也可以插队,即调用add(int index,Object e)方法,就可以指定当前对象在集合中的存放位 置。一个对象可以被反复存储进List中,每调用一次add方法,这个对象就被插入进集合中一次,其实, 并不是把这个对象本身存储进了集合中,而是在集合中用一个索引变量指向这个对象,当这个对象被 add多次时,即相当于集合中有多个索引指向了这个对象。List除了通过迭代器逐一遍历各个元素,还可 以调用get(index i)来明确说明取第几个。 Map与List和Set不同,它是双列的集合,用put方法存储一对key/value,不能存储重复的key。取则可 以根据key获得相应的value,即get(Object key)返回值为key 所对应的value。另外,也可以获得所有的 key的集合(map.keySet()),还可以获得所有的value的集合(map.values()),还可以获得key和value组合 成的Map.Entry对象的集合(map.entrySet())。
56. 为什么Map接口不继承Collection接口?
首先Map提供的是键值对映射(即Key和value的映射),而collection提供的是一组数据(并不是键值 对映射)。 其次如果map继承了collection接口,那么所有实现了map接口的类到底是用map的键值对映射数据还 是用collection的一组数据呢(就我们平常所用的hashMap、hashTable、treeMap等都是键值对,所以 它继承collection完全没意义),而且map如果继承了collection接口的话还违反了面向对象的接口分离 原则。
57. ArrayList和LinkedList的区别
ArrayList和LinkedList底层结构都是数据结构中的线性表,实现了List接口,所以都具有有序(索引顺 序)、不唯一的特点。但是由于底层数据结构不同,导致特点恰恰相反。 ArrayList:基于动态数组,连续内存存储,适合下标访问(随机访问),扩容机制:因为数组长度固 定,超出长度存数据时需要新建数组,然后将老数组的数据拷贝到新数组,如果不是尾部插入数据还会 涉及到元素的移动(往后复制一份,插入新元素),使用尾插法并指定初始容量可以极大提升性能、甚 至超过相同元素数量的LinkedList。 LinkedList:基于链表,可以存储在分散的内存中,适合做数据插入及删除操作,不适合查询:需要逐 一遍历。遍历LinkedList必须使用iterator不能使用for循环,因为每次for循环体内通get(i)取得某一元素 时都需要对list重新进行遍历,性能消耗极大。另外不要试图使用indexOf等返回元素索引,并利用其进 行遍历,使用indexlOf对list进行了遍历,当结果为空时会遍历整个列表。 备注:ArrayList和LinkedList哪种集合更浪费空间?角度1:LinkedList浪费空间:不仅存储数据,还要 存储地址,还是前后节点地址都存储;角度2: ArrayList浪费空间:事先分配固定数量的空间,可能导 致闲置;而LinkedList不存在闲置的节点。
58. ArrayList源码的关键点
Object[] elementData,是一个数组引用,用来指向底层数组; private int size;用来表示真实元素的个数,每次增加和删除元素size的值都要变化。 public class ArrayList extends AbstractList implements List, RandomAccess, Cloneable, java.io.Serializable{} 这三个接口都没有方法。 数组的默认长度;JDK1.7中中默认是10,new ArryList() ->this(10);JDK1.8中,new ArrayList() 数组的长度是0.第一次添加元素的时候进行扩容。 当数组已经满时,要扩容,默认每次扩容为原来长度的50%;使用了位运算。如果扩容50%的空间 还是不足时,就扩容为能够容纳所添加元素的最小容量。 int newCapacity = oldCapacity + (oldCapacity >> 1); if (newCapacity - minCapacity < 0) newCapacity = minCapacity; iterator(); ArrayList中提供了一个内部类 Itr implements Iterator,实现了其中的hasNext()、 next()等方法。基本思路:有一个索引/ 指针,初始执行第一个元素。next()时指向一个元素, hasNext()判断是否等于size transient Object[] elementData 底层数组都已transient了,就不参与序列化了,怎么传输数据。 请查看ArrayList的writeObject()和readObject()方法。各个数组元素还是参与序列化的。(而 ArrayList的writeObject()方法的调用过程,经过跟踪发现是通过反射调用的) for (int i=0; i<size; i++) { s.writeObject(elementData[i]); }
59. Iterator和ListIterator之间有什么区别?
(1)我们可以使用Iterator来遍历Set和List集合,而ListIterator只能遍历List; (2)Iterator只可以向前遍历,而LIstIterator可以双向遍历; (3)ListIterator从Iterator接口继承,然后添加了一些额外的功能,比如添加一个元素、替换一个元素、 获取前面或后面元素的索引位置。
packagese.collect.list;
importjava.util.ArrayList;
importjava.util.ListIterator;
publicclassListIteratorDemo {
publicstaticvoidmain(String[] args) {
ArrayList<String>list=newArrayList<>();
list.add("1");
list.add("3");
list.add("2");
list.add("4");
list.add("5");
System.out.println("正向遍历结果:");
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
60. 两个List的交集元素?
首先,Java中就提供了一个API,让咱们可以直接使用的。 提供的方式叫retainAll方法。 可以直接 list1.retainAll(list2),他会将list1中的数据,只保留list1和list2的交集结果。 他内部采用的机制是双指针。 指针A:初始在0位置,如果有交集元素,赋值,然后向后移动一个位置 指针B:每次都会往后移动一个位置指向一个元素,同时利用contains判断元素是否存在,存在, 在指针A的位置赋值,然后指针A移动,指针B也移动。如果不存在交集情况,A不动,B动。
61. 集合框架中的泛型有什么优点?
类型安全:
// 正向遍历
ListIterator<String>listIterator=list.listIterator();
while (listIterator.hasNext()) {
System.out.println(listIterator.next());
}
System.out.println("反向遍历结果:");
// 反向遍历
while (listIterator.hasPrevious()) {
System.out.println(listIterator.previous());
}
System.out.println("插入元素:");
//插入元素
ListIterator<String>listIterator1=list.listIterator();
listIterator1.add("7");
while (listIterator1.hasPrevious()) {
System.out.println(listIterator1.previous());
}
System.out.println(list);
System.out.println();
ListIterator<String>listIterator2=list.listIterator();
System.out.println("替换元素:");
// 替换元素
while (listIterator2.hasNext()) {
Stringnext=listIterator2.next();
if ("5".equals(next)) {
listIterator2.set("155");
}
}
System.out.println(list);
}
}
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
通过知道使用泛型定义的变量的类型限制,编译器可以在非常高的层次上验证类型假设。没有泛型,这 些假设就只能在程序员编码时候去考虑了。
消除强制类型转换:
消除源代码中的许多强制类型转换。这使得代码更加可读,并且减少了出错机会。
更高的效率:
在非泛型编程中,将筒单类型作为引用类型传递时会引起(装箱)和(拆箱)操作,这两个过程都是具 有很大开销的。引入泛型后,就不必进行装箱和拆箱操作了,所以运行效率相对较高。
62. fail-fast和fail-safe的区别
简介: fail-fast(快速失败)是Java对java.util包下的所有集合类的是一种错误检测机制。 fail-safe(安全失败)采用安全失败机制的集合容器,在遍历时不是直接在集合内容上访问的,而是先 复制原有集合内容,在拷贝的集合上进行遍历。 区别: java.util包下面的所有的集合类都是快速失败的,而java.util.concurrent包下面的所有的类都是安全失败 的。fail-fast(快速失败)的迭代器会抛出ConcurrentModificationException异常,而因为安全失败 是基于对底层集合做拷贝,所以,它不受源集合上修改的影响,安全失败的迭代器永远不会抛出这样的 异常。
fail-fast 机制:
在遍历一个集合时,当集合结构被修改,以下两种情况会抛出ConcurrentModificationException。 如何解决: a、并发遍历集合时不要修改集合 b、调用fail-safe类集(CopyOnWriteArrayList,ConcurrentHashMap)
fail-safe机制:
任何对集合结构的修改都在一个复制的集合上进行修改,所以不会抛出异常,因为原来的集合根本就没 变 缺点: a、需要复制集合,产生大量无效对象,开销大。 b、无法保证读取的数据是目前原始数据结构中的数据。
63. HashSet 的去重原理
如果两个对象的hashCode值不同,直接插入成功. 如果两个对象的hashCode值相同,再比较两个对象的地址值。如果地址值相同,即同一个对象,插入 失败(无需继续判断)反之,则会继续调用equals方法比较,如果equals方法返回true,插入失败;如 果equals方法返回false,插入成功。
64. TreeSet和HashSet的区别
1、速度和内部实现: HashSet 内部使用哈希表来存储元素,因此它的查找、插入和删除操作的时间复杂度都是 O(1)。 TreeSet 内部使用的是红黑树,因此它的时间复杂度为 O(log n)。
65. 排序方式:
HashSet 不保证元素的顺序,因为它是根据哈希值来存储和检索元素的。 TreeSet 则可以保证元素的顺序,因为它是根据元素的自然顺序或者比较器来进行排序的
66. 接口:
HashSet 实现了 Set 接口。 TreeSet 实现了 SortedSet 接口(继承自Set接口)。 4 使用场景: 如果需要快速地插入、删除和查找元素,并且不关心它们的顺序,那么可以使用 HashSet。 如果需要对元素进行比较、排序,那么可以使用 TreeSet。
67. Comparator与Comparable有什么区别
Comparator和Comparable都是Java中用于对象排序的接口,它们之间有一些关键的区别。 Comparable接口是在对象自身的类中实现的,它定义了对象的自然排序方式。一个类实现了 Comparable接口后,可以使用compareTo方法来比较当前对象和其他对象的大小关系。这个接口只能 在对象自身的类中实现,不需要额外的比较器。 Comparator接口是一个独立的比较器,它可以用于对不同类的对象进行排序。Comparator接口允许 在对象类之外创建一个单独的比较器类或匿名类,并使用它来定义对象的排序规则。比较器通过实现 compare方法来比较两个对象的大小关系。 因此,主要区别如下: Comparable接口是在对象自身的类中实现,定义了对象的自然排序方式。 Comparator接口是一个单独的比较器,定义了用于排序的规则,可以用于不同类的对象排序。 Comparable是内部排序,对象的类必须实现Comparable接口才能进行排序。 Comparator是外部排序,可以独立定义排序规则,并与任何类的对象一起使用。 在使用时,如果需要对对象的默认排序进行操作,可以实现Comparable接口。如果需要对不同类的对 象进行排序,或者需要定义多种不同的排序规则,可以使用Comparator接口。 备注:实现Comparable接口只能指定一种比较的规则,如果还希望按照其他的规则在指定比较的规 则,怎么办?此时就可以通过外部比较器Comparator的实现类来指定规则,并且可以定义多个实现类 来指定多个比较规则。
68. Map接口提供了哪些不同的集合视图?
Map接口提供三个集合视图: (1)Set keyset():返回map中包含的所有key的一个Set视图。此Set集合是受map支持的,map的变化会 在集合中反映出来,反之亦然。当一个迭代器正在遍历一个此Set集合时,若map被修改了(除迭代器自 身的移除操作以外),迭代器的结果会变为不确定。此Set集合支持元素查找和删除,从此Set中删除元素 会从map中移除对应的映射,它不支持add和addAll添加操作。 (2)Collection values():返回一个map中包含的所有value的一个Collection视图。这个collection受map 支持,map的变化会在collection中反映出来,反之亦然。当一个迭代器正在遍历此collection时,若 map被修改了(除迭代器自身的移除操作以外),迭代器的结果会变为不确定。此Collection集合支持元素 查找和删除,从此Collection中删除元素会从map中移除对应的映射,它不支持add和addAll添加操作。 (3)Set entrySet():返回一个map中包含的所有映射的一个Set集合视图。这个Set集合受map支持,map 的变化会在Set中反映出来,反之亦然。当一个迭代器遍历此Set集合时,若map被修改了(除迭代器自身 的移除操作,以及对迭代器返回的entry进行setValue外),迭代器的结果会变为未定义。此Set集合支持 元素查找和删除,从此Set中删除元素会从map中移除对应的映射,它不支持add和addAll操作。
69. map的三种遍历方式
方式一:增强for 方式二:EntrySet迭代 方式三:KeySet迭代
例子(example):
packagese.collect.map;
importjava.util.HashMap;
importjava.util.Iterator;
importjava.util.Map;
1
2
3
4
70. HashMap与HashTable 的区别
(1)线程安全性不同 HashMap是线程不安全的,HashTable是线程安全的,其中的方法大多数是Synchronize的,在多线程 并发的情况下,可以直接使用HashTable,但是使用HashMap时必须自己增加同步处理。
HashMap:
HashTable:
importjava.util.Set;
publicclassMapForDemo {
publicstaticvoidmain(String[] args) {
HashMap<String, String>map=newHashMap<>();
map.put("name", "zs");
map.put("age", "18");
map.put("sex", "男");
map.put("address", "武汉市");
// 方式一:增强for
//for (Map.Entry<String, String> entry : map.entrySet()) {
//System.out.println("map的key:"+entry.getKey()
//   +",map的value:"+entry.getValue());
//}
// 方式二:EntrySet迭代
//Set<Map.Entry<String, String>> entries = map.entrySet();
//Iterator<Map.Entry<String, String>> iterator = entries.iterator();
//while (iterator.hasNext()) {
//    Map.Entry<String, String> next = iterator.next();
//    System.out.println("map的key:" + next.getKey()
//   + ",map的value:" + next.getValue());
//}
//方式三:keySet迭代
Iterator<String>keySetIterator=map.keySet().iterator();
while (keySetIterator.hasNext()) {
Stringkey=keySetIterator.next();
Stringvalue=map.get(key);
System.out.println("map的key:"+key+",map的value:"+value);
}
}
}
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
(2)是否提供contains方法 HashMap只有containsValue和containsKey方法;HashTable有contains、containsKey和 containsValue三个方法,其中contains和containsValue方法功能相同。
HashMap:
HashTable:
(3)key和value是否允许null值 Hashtable中,key和value都不允许出现null值。HashMap中,null可以作为键,这样的键只有一个; 可以有一个或多个键所对应的值为null。
HashMap:
HashTable:
(4)数组初始化和扩容机制 初始化:HashTable在不指定容量的情况下的默认容量为11;而HashMap在不指定容量的时候,并不会 提前构建指定长度大小的数组。而是当第一次put元素的时候才会去创建一个容量大小为16的数组,这 点一定要注意!!!
HashTable:
HashMap:
扩容:Hashtable扩容时,将容量变为原来的2倍加1,而HashMap扩容时,将容量变为原来的2倍。
HashMap:
HashTable:
71. JDK 1.7HashMap
数据结构:数组+链表
put方法的流程
72. JDK 1.8HashMap
1)、HashMap 的底层数据结构
在JDK 1.7 中 HashMap 是以「数组加链表」的形式组成的,JDK 1.8之后新增了「红黑树」的组成结 构,「当链表长度大于 8 并且 hash 桶的容量大于 64 时,链表结构会转换成红黑树结构」。所以,它 的组成结构如下图所示: 底层数据结构 HashMap 中数组的每一个元素又称为哈希桶,也就是 key-value 这样的实例。在Java7** 中叫 Entry, Java8中叫 Node。 因为它本身所有的位置都为 null,在 put 插入的时候会根据 key 的 hash 去计算一个 index 值。比如, 我 put (“徐庶”,666),在 HashMap 中插入 “徐庶” 这个元素,通过 hash 算法算出 index 位置是 3。 这时的结构如下所示,还是个数组。 初次 put 以上没 hash 冲突时,若发生 hash 冲突就得引入链表啦。假设我再次 put (“元直”,666),在 HashMap 中插入 “元直” 这个元素,通过 hash 算法算出 index 位置也是 3。这时的结构如下所示:形 成了链表。 再次 put,发生 hash 冲突 它的源码如下所示:「可以看出每个哈希桶中包含了四个字段:hash、key、value、next,其中 next 表示链表的下一个节点」。 JDK 1.8 之所以添加红黑树是因为一旦链表过长,会严重影响 HashMap 的性能,而红黑树具有快速增删 改查的特点,这样就可以有效的解决链表过长时操作比较慢的问题。
2)、HashMap 的重要方法
PS:以下源码分析全部基于 JDK1.8 版本。
查询(get 方法)
staticclassNode<K, V>implementsMap.Entry<K, V> {
finalinthash;
finalKkey;
Vvalue;
Node<K,
V>next;
...
}
1
2
3
4
5
6
7
8
publicVget(Objectkey) {
Node<K, V>e;
// 对 key 进行哈希操作
return (e=getNode(hash(key), key)) ==null?null : e.value;
}
finalNode<K, V>getNode(inthash, Objectkey) {
Node<K, V> [] tab;
Node<K, V>first, e;
intn;
Kk;
// 非空判断
if ((tab=table) !=null&& (n=tab.length) >0&&
(first=tab[(n-1) &hash]) !=null) {
// 判断第一个元素是否是要查询的元素
// always check first node
if (first.hash==hash&&
((k=first.key) ==key|| (key!=null&&key.equals(k))))
returnfirst;
// 下一个节点非空判断
if ((e=first.next) !=null) {
// 如果第一节点是树结构,则使用 getTreeNode 直接获取相应的数据
if (firstinstanceofTreeNode)
return ((TreeNode<K, V> ) first).getTreeNode(hash, key);
do { // 非树结构,循环节点判断
// hash 相等并且 key 相同,则返回此节点
if (e.hash==hash&&
((k=e.key) ==key|| (key!=null&&key.equals(k))))
returne;
} while ((e=e.next) !=null);
}
}
returnnull;
}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
代码注释已经很详细,强调一点:当哈希冲突时我们不仅需要判断 hash 值,还需要通过判断 key 值是 否相等,才能确认此元素是不是我们想要的元素。
新增(put 方法)
publicVput(Kkey, Vvalue) {
// 对 key 进行哈希操作
returnputVal(hash(key), key, value, false, true);
}
finalVputVal(inthash, Kkey, Vvalue, booleanonlyIfAbsent,
booleanevict) {
Node<K, V> [] tab;
Node<K, V>p;
intn, i;
// 哈希表为空则创建表
if ((tab=table) ==null|| (n=tab.length) ==0)
n= (tab=resize()).length;
// 根据 key 的哈希值计算出要插入的数组索引 i
if ((p=tab[i= (n-1) &hash]) ==null)
// 如果 table[i] 等于 null,则直接插入
tab[i] =newNode(hash, key, value, null);
else {
Node<K, V>e;
Kk;
// 如果 key 已经存在了,直接覆盖 value
if (p.hash==hash&&
((k=p.key) ==key|| (key!=null&&key.equals(k))))
e=p;
// 如果 key 不存在,判断是否为红黑树
elseif (pinstanceofTreeNode)
// 红黑树直接插入键值对
e= ((TreeNode<K, V> ) p).putTreeVal(this, tab, hash, key,
value);
else {
// 为链表结构,循环准备插入
for (intbinCount=0;; ++binCount) {
// 下一个元素为空时
if ((e=p.next) ==null) {
p.next=newNode(hash, key, value, null);
// 转换为红黑树进行处理
if (binCount>=TREEIFY_THRESHOLD-1) // -1 for 1st
treeifyBin(tab, hash);
break;
}
//  key 已经存在直接覆盖 value
if (e.hash==hash&&
((k=e.key) ==key|| (key!=null&&key.equals(k))))
break;
p=e;
}
}
// existing mapping for key
if (e!=null) {
VoldValue=e.value;
if (!onlyIfAbsent||oldValue==null)
e.value=value;
afterNodeAccess(e);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
注释已经很详细了。但新增的方法比较复杂,画个流程图方便方便各位理解:
returnoldValue;
}
}
++modCount;
// 超过最大容量,扩容
if (++size>threshold)
resize();
afterNodeInsertion(evict);
returnnull;
}
52
53
54
55
56
57
58
59
60
61
扩容(resize 方法)
源码如下:
finalNode<K, V> [] resize() {
// 扩容前的数组
Node<K, V> [] oldTab=table;
// 扩容前的数组的大小和阈值
intoldCap= (oldTab==null) ?0 : oldTab.length;
intoldThr=threshold;
// 预定义新数组的大小和阈值
intnewCap, newThr=0;
if (oldCap>0) {
// 超过最大值就不再扩容了
if (oldCap>=MAXIMUM_CAPACITY) {
threshold=Integer.MAX_VALUE;
returnoldTab;
}
// 扩大容量为当前容量的两倍,但不能超过 MAXIMUM_CAPACITY
elseif ((newCap=oldCap<<1) <MAXIMUM_CAPACITY&&
oldCap>=DEFAULT_INITIAL_CAPACITY)
newThr=oldThr<<1; // double threshold
}
// 当前数组没有数据,使用初始化的值
elseif (oldThr>0) // initial capacity was placed in threshold
newCap=oldThr;
else { // zero initial threshold signifies using defaults
// 如果初始化的值为 0,则使用默认的初始化容量
newCap=DEFAULT_INITIAL_CAPACITY;
newThr= (int)(DEFAULT_LOAD_FACTOR*DEFAULT_INITIAL_CAPACITY);
}
// 如果新的容量等于 0
if (newThr==0) {
floatft= (float) newCap*loadFactor;
newThr= (newCap<MAXIMUM_CAPACITY&&ft< (float) MAXIMUM_CAPACITY
?
(int) ft : Integer.MAX_VALUE);
}
threshold=newThr;
@SuppressWarnings({
"rawtypes",
"unchecked"
})
Node<K, V> [] newTab= (Node<K, V> []) newNode[newCap];
// 开始扩容,将新的容量赋值给 table
table=newTab;
// 原数据不为空,将原数据复制到新 table 中
if (oldTab!=null) {
// 根据容量循环数组,复制非空元素到新 table
for (intj=0; j<oldCap; ++j) {
Node<K, V>e;
if ((e=oldTab[j]) !=null) {
oldTab[j] =null;
// 如果链表只有一个,则进行直接赋值
if (e.next==null)
newTab[e.hash& (newCap-1)] =e;
elseif (einstanceofTreeNode)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
从以上源码可以看出,扩容主要分两步: 扩容:创建一个新的 Entry 空数组,长度是原数组的 2 倍。 位运算:原来的元素哈希值和原数组长度进行 & 运算。 JDK 1.8 在扩容时并没有像 JDK 1.7 那样,重新计算每个元素的哈希值,而是通过高位运算(e.hash & oldCap)来确定元素是否需要移动,假设 key1 的信息如下: key1.hash = 10;二进制:0000 1010 oldCap = 16;二进制:0001 0000
// 红黑树相关的操作
((TreeNode<K, V> ) e).split(this, newTab, j, oldCap);
else { // preserve order
// 链表复制,JDK 1.8 扩容优化部分
// 如果节点不为空,且为单链表,则将原数组中单链表元素进行拆分
//保存在原有索引的链表
Node<K, V>loHead=null, loTail=null;
//保存在新索引的链表
Node<K, V>hiHead=null, hiTail=null;
Node<K, V>next;
do {
next=e.next;
// 哈希值和原数组长度进行 & 操作,为 0 则在原数组的索引位置
if ((e.hash&oldCap) ==0) {
if (loTail==null)
loHead=e;
else
loTail.next=e;
loTail=e;
}
// 原索引 + oldCap
else {
if (hiTail==null)
hiHead=e;
else
hiTail.next=e;
hiTail=e;
}
} while ((e=next) !=null);
// 将原索引放到哈希桶中
if (loTail!=null) {
loTail.next=null;
newTab[j] =loHead;
}
// 将原索引 + oldCap 放到哈希桶中
if (hiTail!=null) {
hiTail.next=null;
newTab[j+oldCap] =hiHead;
}
}
}
}
}
returnnewTab;
}
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
88
89
90
91
92
93
94
95
96
97
「使用 e.hash & oldCap 得到的结果,高一位为 0,当结果为 0 时表示元素在扩容时位置不会发生任何
变化」,而假设 key 2 信息如下: key2.hash = 17;二进制:0001 0001 oldCap = 16;二进制:0001 0000
「这时候得到的结果,高一位为 1,当结果为 1 时,表示元素在扩容时位置发生了变化,新的下标位置
等于原下标位置 + 原数组长度」,如下图所示:key2、kry4 虚线为移动的位置。
3)、HashMap 有哪些属性?
如下,看代码注释,写的很清楚了。
4)、为什么 HashMap 的初始化长度是 16 ?(必须是2的幂次方)
前面说过,从 Key 映射到 HashMap 数组的对应位置,会用到一个 Hash 函数,比如:index = Hash (“徐庶”) 注意到 HashMap 初始化长度用的是 1<<4,而不是直接写 16。这是为啥呢?其实这样是为了位运算的 方便,「位与运算比算数计算的效率高太多了,之所以选择 16,是为了服务将 Key 映射到 index 的算 法」。
// HashMap 初始化长度
staticfinalintDEFAULT_INITIAL_CAPACITY=1<<4; // aka 16
// HashMap 最大长度
staticfinalintMAXIMUM_CAPACITY=1<<30; // 1073741824
// 默认的加载因子 (扩容因子)
staticfinalfloatDEFAULT_LOAD_FACTOR=0.75f;// 当链表长度大于此值且数组长度大于 64 时,会从链表转成红黑树
staticfinalintTREEIFY_THRESHOLD=8;// 转换链表的临界值,当元素小于此值时,会将红黑树结构转换成链表结构
staticfinalintUNTREEIFY_THRESHOLD=6;// 最小树容量
staticfinalintMIN_TREEIFY_CAPACITY=64;
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
那如何实现一个尽量均匀分布的 Hash 函数呢?从而减少 HashMap 碰撞呢?没错,就是通过 Key 的 HashCode 值来做位运算。 有公式(Length 是 HashMap 的长度):「HashCode(Key) & (Length- 1)」 我举个例子,key 为 “book” 的十进制为 3029737 那二进制就是 101110001110101110 1001 HashMap 长度是默认的 16,length - 1 的结果。十进制 : 15;二进制 : 1111 把以上两个结果做与运算:101110001110101110 1001 & 1111 = 1001;1001 的十进制 = 9, 所以 index=9。 也就是说:「hash 算法最终得到的 index 结果,取决于 hashcode 值的最后几位」 你可以试试把长度指定为 10 以及其他非 2 次幂的数字,做位运算。发现 index 出现相同的概率大大升 高。而长度 16 或者其他 2 的幂,length - 1 的值是所有二进制位全为 1, 这种情况下,index 的结果等同 于 hashcode 后几位的值,只要输入的 hashcode 本身分布均匀,hash 算法的结果就是均匀的 「所以,HashMap 的默认长度为 16,是为了降低 hash 碰撞的几率」。
5)、为什么树化是 8,退树化是 6?
红黑树平均查找长度为 log (n),长度为 8 时,查找长度为 3,而链表平均查找长度为 n/2;也就是 8 除 以 2;查找长度链表大于树,转化为树,效率更高。 当为 6 时,树:2.6;链表:3。链表 > 树。这时理应也还是树化,但是树化需要时间,为了这点效率牺 牲时间是不划算的。
6)、什么是加载因子?加载因子为什么是 0.75 ?
前面说了扩容机制。那什么时候扩容呢?这就取决于原数组长度和加载因子两个因素了。 加载因子也叫扩容因子或负载因子,用来判断什么时候进行扩容的,假如加载因子是 0.5,HashMap 的 初始化容量是 16,那么当 HashMap 中有 16*0.5=8 个元素时,HashMap 就会进行扩容。 那加载因子为什么是 0.75 而不是 0.5 或者 1.0 呢?这其实是出于容量和性能之间平衡的结果: 上面说到,为了提升扩容效率,HashMap 的容量(capacity)有一个固定的要求,那就是一定是 2 的幂。所以,如果负载因子是 3/4 的话,那么和 capacity 的乘积结果就可以是一个整数 当加载因子设置较大时,扩容门槛提高,扩容发生频率低,占用的空间小,但此时发生 Hash 冲突 的几率就会提升,因此需要更复杂的数据结构来存储元素,这样对元素的操作时间就会增加,运行 效率也会降低; 当加载因子设置较小时,扩容门槛降低,会占用更多的空间,此时元素的存储就比较稀疏,发生哈 希冲突的可能性就比较小,因此操作性能会比较高。 「所以综合了以上情况就取了一个 0.5 到 1.0 的平均数 0.75 作为加载因子」。
7)、HashMap 是线程安全的么?
不是,因为 get 和 put 方法都没有上锁。「多线程操作无法保证:此刻 put 的值,片刻后 get 还是相同 的值,会造成线程安全问题」。 还有个 HashTable 是线程安全的,但是加锁的粒度太大。并发度很低,最多同时允许一个线程访问,性 能不高。一般我们使用 currentHashMap。
8)、为什么重写 equals 方法的时,需要重写 hashCode 方法呢?
Java 中,所有的对象都是继承于 Object 类。Ojbect 类中有两个方法 equals、hashCode,这两个方法 都是用来比较两个对象是否相等的。 先来看看 equals 方法: 在未重写 equals 方法,他其实就是 == 。有以下两个特点: 对于值对象,== 比较的是两个对象的值 对于引用对象,== 比较的是两个对象的地址 看回 put 方法的源码:「HashMap 是通过 key 的 hashcode 去寻找地址 index 的。如果 index 一样 就会形成链表」,也即是 “徐庶” 和 “元直” 是有可能在同一个位置上。 前面的 get 方法说过:「当哈希冲突时我们不仅需要判断 hash 值,还需要通过判断 key 值是否相等, 才能确认此元素是不是我们想要的元素」。我们去 get 首先是找到 hash 值一样的,那怎么知道你想要 的是那个对象呢?「没错,就是利用 equals 方法」,如果重写 hashCode 方法,不写 equals 方法,当 发生 hash 冲突,hashcode 一样时,就不知道取哪个对象了。
9)、HashMap 死循环分析
以下代码基于 JDK1.7 分析。这个问题,主要是 JDK1.7 的链表头插法造成的。假设 HashMap 默认大小 为 2,原本 HashMap 中没有一个元素。使用三个线程:t1、t2、t3 添加元素 key1,key2,key3。我在 扩容之前打了个断点,让三个线程都停在这里。源码如下: 假设 3 个元素 hash 冲突,放到同一个链表上。其中 key1→key2→key3 这样的顺序。没毛病,一切很 正常。 尾插法
publicbooleanequals(Objectobj) {
return (this==obj);
}
1
2
3
void transfer(Entry[] newTable, boolean rehash) {
int newCapacity = newTable.length;
for (Entry < K, V > e: table) {
while (null != e) {
Entry < K, V > next = e.next; // 此处加断点
if (rehash) {
e.hash = null == e.key ? 0 : hash(e.key);
}
int i = indexFor(e.hash, newCapacity);
e.next = newTable[i];
newTable[i] = e;
e = next;
}
}
}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
此时放开断点,HashMap 扩容。就有可能变成这样:原来是 key1→key2→key3。很不幸扩容之后, key1 和 key2 还是在同一个位置,这时形成链表,如果 key2 比 key1 后面插入,根据头插法。此时就变 成 key2→key1 链表反转 最终 3 个线程都调整完毕,就会出现下图所示的死循环:这个时候 get (key1) 就会出现 Infinite Loop 异 常。 循环引用 当然发生死循环的原因是 JDK 1.7 链表插入方式为首部倒序插入,这种方式在扩容时会改变链表节点之 间的顺序。「这个问题在 JDK 1.8 得到了改善,变成了尾部正序插入」,在扩容时会保持链表元素原本 的顺序,就不会出现链表成环的问题。
10)、JDK8中的HashMap为什么要使用红黑树?
当元素个数小于一个阈值时,链表整体的插入查询效率要高于红黑树,当元素个数大于此阈值时,链表 整体的插入查询效率要低于红黑树。此阈值在HashMap中为8。
11)、JDK8中的HashMap什么时候将链表转化为红黑树?
这个题很容易答错,大部分答案就是:当链表中的元素个数大于8时就会把链表转化为红黑树。但是其实 还有另外一个限制:当发现链表中的元素个数大于8之后,还会判断一下当前数组的长度,如果数组长度 小于64时,此时并不会转化为红黑树,而是进行扩容。只有当链表中的元素个数大于8,并且数组的长 度大于等于64时才会将链表转为红黑树。 上面扩容的原因是,如果数组长度还比较小,就先利用扩容来缩小链表的长度。
73. JDK7与JDK8中HashMap的不同点?
- JDK8中使用了红黑树
- JDK7中链表的插入使用的头插法(扩容转移元素的时候也是使用的头插法,头插法速度更快,无需 遍历链表,但是在多线程扩容的情况下使用头插法会出现循环链表的问题,导致CPU飙升),JDK8 中链表使用的尾插法(JDK8中反正要去计算链表当前结点的个数,反正要遍历的链表的,所以直接 使用尾插法)
- JDK7的Hash算法比JDK8中的更复杂,Hash算法越复杂,生成的hashcode则更散列,那么 hashmap中的元素则更散列,更散列则hashmap的查询性能更好,JDK7中没有红黑树,所以只能 优化Hash算法使得元素更散列,而JDK8中增加了红黑树,查询性能得到了保障,所以可以简化一 下Hash算法,毕竟Hash算法越复杂就越消耗CPU。
- 扩容的过程中JDK7中有可能会重新对key进行哈希(重新Hash跟哈希种子有关系),而JDK8中没 有这部分逻辑。
- JDK8中扩容的条件和JDK7中不一样,除开判断size是否大于阈值之外,JDK7中还判断了table[i]是 否为空,不为空的时候才会进行扩容,而JDK8中则没有该条件了。
- JDK8中还多了一个API:putIfAbsent(key,value)
- JDK7和JDK8扩容过程中转移元素的逻辑不一样,JDK7是每次转移一个元素,JDK8是先算出来当前 位置上哪些元素在新数组的低位上,哪些在新数组的高位上,然后在一次性转移。
74. 常见线程安全的并发容器有哪些?
CopyOnWriteArrayList、CopyOnWriteArraySet、ConcurrentHashMap。 CopyOnWriteArrayList:采用写时复制实现线程安全,可以有重复元素 CopyOnWriteArraySet:底层是CopyOnWriteArrayList,基于addIfAbsent保证元素唯一 ConcurrentHashMap:核心是分段锁(JDK1.7)/CAS+Synchronized(JDK1.8),通过减小锁 粒度来提升并发性能:
75. JDK7与JDK8中ConcurrentHashMap的不同点?
1) JDK1.7ConcurrentHashMap
JDK 1.7ConcurrentHashMap底层是由两层嵌套数组来实现的:
- ConcurrentHashMap对象中有一个属性segments,类型为Segment[];
- Segment对象中有一个属性table,类型为HashEntry[];
put流程:
1、当调用ConcurrentHashMap的put方法时,先根据key计算出对应的Segment[]的数组下标j,确定好 当前key,value应该插入到哪个Segment对象中,如果segments[j]为空,则利用自旋锁的方式在j位置生 成一个Segment对象。 2、然后调用Segment对象的put方法。 2.1 Segment对象的put方法会先加锁,然后也根据key计算出对应的HashEntry[]的数组下标i,然后 将key,value封装为HashEntry对象放入该位置,此过程和JDK7的HashMap的put方法一样,然后解锁。 2.2 在加锁的过程中逻辑比较复杂,先通过自旋加锁,如果超过一定次数就会直接阻塞等等加锁。
2).JDK 1.8ConcurrentHashMap
put流程:
1、当向ConcurrentHashMap中put一个key,value时,首先根据key计算对应的数组下标i,如果该位置 没有元素,则通过自旋的方法去向该位置赋值。如果该位置有元素,则synchronized会加锁 2、加锁成功之后,在判断该元素的类型。 2.1 如果是链表节点则进行添加节点到链表中 2.2 如果是红黑树则添加节点到红黑树 3、添加成功后,判断是否需要进行树化 4、addCount,这个方法的意思是ConcurrentHashMap的元素个数加1,但是这个操作也是需要并发安 全的,并且元素个数加1成功后,会继续判断是否要进行扩容,如果需要,则会进行扩容,所以这个方法 很重要。 5、同时一个线程在put时如果发现当前ConcurrentHashMap正在进行扩容则会去帮助扩容。
3).JDK 1.7ConcurrentHashMap如何保证并发
主要利用Unsafe操作+ReentrantLock+分段思想。 主要使用了Unsafe操作中的:
- compareAndSwapObject:通过cas的方式修改对象的属性
- putOrderedObject:并发安全的给数组的某个位置赋值
- getObjectVolatile:并发安全的获取数组某个位置的元素 分段思想是为了提高ConcurrentHashMap的并发量,分段数越高则支持的最大并发量越高,程序员可 以通过concurrencyLevel参数来指定并发量。ConcurrentHashMap的内部类Segment就是用来表示某 一个段的。 每个Segment就是一个小型的HashMap的,当调用ConcurrentHashMap的put方法时,最终会调用到 Segment的put方法,而Segment类继承了ReentrantLock,所以Segment自带可重入锁,当调用到 Segment的put方法时,会先利用可重入锁加锁,加锁成功后再将待插入的key,value插入到小型 HashMap中,插入完成后解锁。
4).JDK 1.8ConcurrentHashMap如何保证并发
主要利用Unsafe操作+synchronized关键字。Unsafe操作的使用仍然和JDK7中的类似,主要负责并发安 全的修改对象的属性或数组某个位置的值。synchronized主要负责在需要操作某个位置时进行加锁(该 位置不为空),比如向某个位置的链表进行插入结点,向某个位置的红黑树插入结点。JDK8中其实仍然 有分段锁的思想,只不过JDK7中段数是可以控制的,而JDK8中是数组的每一个位置都有一把锁。
76. 什么是 CopyOnWriteArrayList
1).Copy-On-Write 是什么?
Copy-On-Write它是一种在计算机科学中常见的优化技术,主要应用于需要频繁读取但很少修改的数据 结构上。 简单的说就是在计算机中就是当你想要对一块内存进行修改时,我们不在原有内存块中进行写操作,而 是将内存拷贝一份,在新的内存中进行写操作,写完之后呢,就将指向原来内存指针指向新的内存,原 来的内存就可以被回收掉了! 既然是一种优化策略,我们看一段代码:
importjava.util.ArrayList;
importjava.util.Arrays;
importjava.util.Iterator;
importjava.util.List;
/**
* @author 百里
*/
publicclassBaiLiIteratorTest {
privatestaticList<String>list=newArrayList<>();
publicstaticvoidmain(String[] args) {
list.add("1");
list.add("2");
list.add("3");
Iterator<String>iter=list.iterator();
while (iter.hasNext()) {
System.err.println(iter.next());
}
System.err.println(Arrays.toString(list.toArray()));
}
}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
上面的Demo在单线程下执行时没什么毛病,但是在多线程的环境中,就可能出异常,为什么呢? 因为多线程迭代时如果有其他线程对这个集合list进行增减元素,会抛出 java.util.ConcurrentModificationException的异常。 我们以增加元素为例子,运行下面这Demo:
这里暴露的问题是什么呢?
多线程场景下迭代器遍历集合的读取操作和其他线程对集合进行写入操作会导致出现并发修改异常
importjava.util.ArrayList;
importjava.util.Iterator;
importjava.util.List;
importjava.util.concurrent.ExecutorService;
importjava.util.concurrent.Executors;
/**- 并发迭代器问题示例代码
* @author 百里
*/
publicclassBaiLiConcurrentIteratorTest {
// 创建一个ArrayList对象
privatestaticList<String>list=newArrayList<>();
publicstaticvoidmain(String[] args) throwsInterruptedException {
// 给ArrayList添加三个元素:"1"、"2"和"3"
list.add("1");
list.add("2");
list.add("3");
// 开启线程池,提交10个线程用于在list尾部添加5个元素"121"
ExecutorServiceservice=Executors.newFixedThreadPool(10);
for (inti=0; i<10; i++) {
service.execute(() -> {
for (intj=0; j<5; j++) {
list.add("121");
}
});
}
// 使用Iterator迭代器遍历list并输出元素值
Iterator<String>iter=list.iterator();
for (inti=0; i<10; i++) {
service.execute(() -> {
while (iter.hasNext()) {
System.err.println(iter.next());
try {
Thread.sleep(10);
} catch (InterruptedExceptione) {
e.printStackTrace();
}
}
});
}
service.shutdown();
}
}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
解决方案: CopyOnWriteArrayList避免了多线程操作List线程不安全的问题
2).CopyOnWriteArrayList介绍
从JDK1.5开始Java并发包里提供了两个使用CopyOnWrite机制实现的并发容器,它们是 CopyOnWriteArrayList和CopyOnWriteArraySet。CopyOnWrite容器非常有用,可以在非常多的并发 场景中使用到。
CopyOnWriteArrayList原理:
在写操作(add、remove等)时,不直接对原数据进行修改,而是先将原数据复制一份,然后在新复制的 数据上执行写操作,最后将原数据引用指向新数据。这样做的好处是读操作(get、iterator等)可以不加 锁,因为读取的数据始终是不变的。 接下来我们就看下源码怎么实现的。
3).CopyOnWriteArrayList简单源码解读
add()方法源码: 可以看到,CopyOnWriteArrayList中的写操作都需要先获取锁,然后再将当前的元素数组复制一份,并 在新复制的元素数组上执行写操作,最后将数组引用指向新数组。
/**
* Appends the specified element to the end of this list.
*
* @param e element to be appended to this list
* @return {@code true} (as specified by {@link Collection#add})
*/
publicbooleanadd(Ee) {
finalReentrantLocklock=this.lock;//重入锁
lock.lock();//加锁啦
try {
Object[] elements=getArray();
intlen=elements.length;
Object[] newElements=Arrays.copyOf(elements, len+1);//拷贝新数组
newElements[len] =e;
setArray(newElements);//将引用指向新数组  1
returntrue;
} finally {
lock.unlock();//解锁啦
}
}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
@SuppressWarnings("unchecked")
publicEnext() {
if (!hasNext()) //是否存在下一个元素
thrownewNoSuchElementException(); //没有下一个元素,则会抛出
NoSuchElementException异常
//snapshot是一个类成员变量,它是在创建迭代器时通过复制集合内容而获得的一个数组。 //cursor是另一个类成员变量,初始值为0,并在每次调用next()时自增1,表示当前返回元素的 位置。
return (E) snapshot[cursor++];
}
1
2
3
4
5
6
7
8
而读操作不需要加锁,直接返回当前的元素数组即可。 这种写时复制的机制保证了读操作的线程安全性,但是会牺牲一些写操作的性能,因为每次修改都需要 复制一份数组。因此,适合读远多于写的场合。 所以我们将多线程Demo中的ArrayList改为CopyOnWriteArrayList,执行就不会报错啦!
importjava.util.Iterator;
importjava.util.concurrent.CopyOnWriteArrayList;
importjava.util.concurrent.ExecutorService;
importjava.util.concurrent.Executors;
/**- 并发迭代器问题示例代码
* @author 百里
*/
publicclassBaiLiConcurrentIteratorTest {
// 创建一个ArrayList对象
privatestaticCopyOnWriteArrayList<String>list=new
CopyOnWriteArrayList<>();
publicstaticvoidmain(String[] args) throwsInterruptedException {
// 给ArrayList添加三个元素:"1"、"2"和"3"
list.add("1");
list.add("2");
list.add("3");
// 开启线程池,提交10个线程用于在list尾部添加5个元素"121"
ExecutorServiceservice=Executors.newFixedThreadPool(10);
for (inti=0; i<10; i++) {
service.execute(() -> {
for (intj=0; j<5; j++) {
list.add("121");
}
});
}
// 使用Iterator迭代器遍历list并输出元素值
Iterator<String>iter=list.iterator();
for (inti=0; i<10; i++) {
service.execute(() -> {
while (iter.hasNext()) {
System.err.println(iter.next());
try {
Thread.sleep(10);
} catch (InterruptedExceptione) {
e.printStackTrace();
}
}
});
}
service.shutdown();
}
}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
4).CopyOnWriteArrayList优缺点
优点:
- 线程安全。CopyOnWriteArrayList是线程安全的,由于写操作对原数据进行复制,因此写操作不 会影响读操作,读操作可以不加锁,降低了并发冲突的概率。
- 不会抛出ConcurrentModificationException异常。由于读操作遍历的是不变的数组副本,因此 不会抛出ConcurrentModificationException异常。 缺点:
- 写操作性能较低。由于每一次写操作都需要将元素复制一份,因此写操作的性能较低。
- 内存占用增加。由于每次写操作都需要创建一个新的数组副本,因此内存占用会增加,特别是当集 合中有大量数据时,内存占用较高。
- 数据一致性问题。由于读操作遍历的是不变的数组副本,因此在对数组执行写操作期间,读操作可 能读取到旧的数组数据,这就涉及到数据一致性问题。
5).CopyOnWriteArrayList使用场景
读多写少。为什么?因为写的时候会复制新集合 集合不大。为什么?因为写的时候会复制新集合 实时性要求不高。为什么,因为有可能会读取到旧的集合数据
77. 各种集合类型特征对比
78. 说说你对lambda表达式的理解
1). 什么是 Lambda 表达式?
Lambda表达式是Java 8引入的一种简洁的语法形式,用于表示匿名函数。它可以作为参数传递给方法或 函数接口,并且可以在需要函数式编程特性的地方使用。 Lambda表达式的语法类似于(参数列表) -> 表达式或代码块。参数列表描述了输入参数,可以省略类 型,甚至括号。箭头符号将参数列表与表达式或代码块分隔开来。
Lambda表达式具有以下特点:
- 简洁:相较于传统的匿名内部类,Lambda表达式更加简洁,能用更少的代码实现相同功能。
- 函数式编程:支持函数作为一等公民进行传递和操作。
- 闭包:可以访问周围的变量和参数。
- 方法引用:可以通过引用已存在的方法进一步简化。
Lambda表达式的应用场景包括:
集合操作:对集合元素进行筛选、映射、排序等操作,使代码简洁和可读。 并行编程:利用Lambda表达式简化并发编程的复杂性。 事件驱动模型:作为回调函数响应用户输入或系统事件。 需要注意,Lambda表达式仅适用于函数式接口(只有一个抽象方法的接口),可直接实现该接口的实 例,避免编写传统匿名内部类。Lambda表达式在Java编程中提供了更为灵活和简洁的语法,促进了函 数式编程的应用。 Lambda 表达式是 Java 8 引入的一个重要特性,它允许以更简洁的方式编写匿名类和函数式接口的实 现。Lambda 表达式的核心思想是将代码块作为方法参数传递,从而简化代码并提高可读性。以下是一 些常见的面试问题和答案,帮助你深入理解 Lambda 表达式。 Lambda 表达式是一种匿名函数,可以用来表示一个函数式接口的实现。它允许将代码块作为方法参数 传递,从而简化代码。
2). Lambda 表达式的语法是什么?
Lambda 表达式的语法包括三部分: 参数列表:可以显式或隐式指定参数类型。 箭头符号:-> ,表示参数和函数体之间的分隔符。 函数体:可以是一个表达式或代码块。 // 使用匿名类
/**
* @Auth:TianMing
* @Description:基本应用
*/
newThread(newRunnable() {
@Override
publicvoidrun() {
System.out.println("Hello, Anonymous Class!");
}
}).start();
// 使用 Lambda 表达式
newThread(() ->System.out.println("Hello, Lambda!")).start();
1
2
3
4
5
6
7
8
9
10
11
12
13
14
// 参数类型显式指定
(inta, intb) ->a+b;// 参数类型隐式推断
(a, b) ->a+b;// 单个参数时可以省略括号
x->x*x;
1
2
3
4
5
6
7
8
3). Lambda 表达式和函数式接口的关系是什么?
Lambda 表达式必须与函数式接口结合使用。函数式接口是一个只包含一个抽象方法的接口,可以用
@FunctionalInterface注解标记。4). Lambda 表达式的作用是什么?
Lambda 表达式的主要作用是简化代码,提高代码的可读性和可维护性。它特别适合用于以下场景: 事件处理:简化事件监听器的实现。 Stream API:简化集合操作。 函数式编程:支持函数式编程风格。 // 函数体为代码块
(x, y) -> {
intresult=x+y;
returnresult;
};
9
10
11
12
13
14
@FunctionalInterface
interfaceCalculator {
intcalculate(inta, intb);
}
/**
* @Auth:TianMing
* @Description:和函数式接口的关系
*/
publicclassLambdaExample {
publicstaticvoidmain(String[] args) {
Calculatoradd= (a, b) ->a+b;
System.out.println("Addition: "+add.calculate(5, 3)); // 8
Calculatormultiply= (a, b) ->a*b;
System.out.println("Multiplication: "+multiply.calculate(5, 3));
// 15
}
}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
/**
* @Auth:TianMing
* @Description:作用
*/
List<String>names=Arrays.asList("Alice", "Bob", "Charlie", "David");
// 使用 Lambda 表达式过滤和打印名字
names.stream()
.filter(name->name.length() >4)
.forEach(System.out::println);
1
2
3
4
5
6
7
8
9
10
5). Lambda 表达式如何捕获变量?
Lambda 表达式可以捕获外部变量,但这些变量必须是有效最终变量(Effectively Final),即它们的 值在 Lambda 表达式中不能被修改。
6). Lambda 表达式的性能如何?
Lambda 表达式在运行时通过动态代理实现,性能开销较小。它通常比匿名类更高效,因为 Lambda 表 达式会编译为方法而不是类。
7). Lambda 表达式有哪些限制?
单方法接口:Lambda 表达式只能用于实现一个抽象方法的接口。 捕获变量:只能捕获有效最终变量。 可读性:如果逻辑复杂,Lambda 表达式可能会降低代码的可读性。
8). Lambda 表达式在实际开发中的应用
Lambda 表达式在实际开发中非常常用,尤其是在以下场景: Stream API:简化集合操作。 事件处理:简化事件监听器的实现。 函数式接口:实现自定义的函数式接口。 示例(事件处理):
79. 什么是泛型,怎么使用?
比如List集合啥的,都定义了一个泛型,咱们可以在new的时候,将泛型具体化。 Java中的泛型就是一种规避类型错误的一种安全机制。 ClassCastException 当你在声明一个集合并且指定泛型的类型后,你存储的数据类型就会有限制了,存储的不允许的类型, 在编译时期就会直接报错了。
/**
* @Auth:TianMing
* @Description:捕获变量
*/
publicclassLambdaExample {
publicstaticvoidmain(String[] args) {
intfactor=2;
Function<Integer, Integer>multiply=x->x*factor;
System.out.println(multiply.apply(5)); // 10
// 如果 factor 被修改,会导致编译错误
// factor = 3;
}
}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
JButtonbutton=newJButton("Click Me");
button.addActionListener(event->System.out.println("Button clicked!"));
1
2
类型的安全,前面可以看出来。 减少强制类型转换的操作 后面一半会衍生出来泛型擦除的问题。 泛型擦出去是编译器在编译是的一种机制,你编写的Java代码变为class文件后,他就没有泛型这个东西 了,底层都是最顶级的Object。所以泛型只是在编写时加上,其次底层运行时,压根就没泛型这个东 西。 就比如List运行后,他就是List。
泛型擦除有什么影响嘛?
反射的时候,获取一些实例的时候,需要手动强转一下
80. 谈谈自定义注解的场景及实现
自定义注解是Java语言的一个强大特性,可以为代码添加元数据信息,提供额外配置或标记。它适用于 多种场景。
- 配置和扩展框架:通过自定义注解,可以为框架提供配置参数或进行扩展。例如,Spring框架中的 @Autowired注解用于自动装配依赖项,@RequestMapping注解用于映射请求到控制器方法。
- 运行时检查:自定义注解可在运行时对代码进行检查,并进行相应处理。例如,JUnit框架的@Test 注解标记测试方法,在运行测试时会自动识别并执行这些方法。
- 规范约束:自定义注解用于规范代码风格和约束。例如,Java代码规范检查工具Checkstyle可使用 自定义注解标记违规行为。 实现自定义注解的步骤如下:
- 使用@interface关键字定义注解。
- 可在注解中定义属性,并指定默认值。
- 根据需求,可添加元注解来控制注解的使用方式。
- 在代码中使用自定义注解。
- 使用反射机制解析注解信息。 通过合理运用自定义注解,可提高代码的可读性、可维护性和可扩展性。
81. String的常用方法
82. String, StringBuffer,StringBuilder区别
不修改用 String,修改且多线程用 StringBuffer,修改且单线程用 StringBuilder。 JDK5 + 后,String 的 + 拼接会被编译器优化为 StringBuilder,循环内拼接仍建议手动用 StringBuilder(避免每次循环 new 对象)
83. HashMap的原理(jdk1.7, jdk1.8实现区别)
1.7 是数组 + 链表,1.8 新增红黑树(链表≥8 且数组≥64 时转换),解决查询性能退化;
"abc".length();   // 返回字符串长度 → 3
"abc".charAt(1);  // 获取指定索引的字符  → 'b'
"".isEmpty()      // 判断字符串是否为空(长度 0)→ true
"  ".isBlank()    // 判断是否为空 / 仅含空白字符 → true
"abc".getBytes("UTF-8")  // 将字符串转字节数组(可指定字符编码,也可不指定使用默认)
"abc".contains("bc")     // 判断是否包含指定子串  → true
"abc".indexOf("c")       // 返回子串首次出现的索引,无则返回-1    → 2
"abac".lastIndexOf("a")  // 返回子串最后出现的索引  → 2
"abc".startsWith("ab")   // 判断是否以指定前缀开头  → true
"abc".endsWith("c")      // 判断是否以指定后缀结尾 → true
"123".matches("\\d+")    // 判断是否匹配正则表达式  → true
"abc".substring(1)       // 从指定索引截取到末尾    → "bc"
"abc".substring(0,2)     // 截取 [begin,end) 区间 → "ab"
"a".concat("b")          // 拼接字符串   → "ab"(等价于 +,但效率略高)
String.join(",", "a","b")      // 静态方法,按分隔符拼接 → "a,b"
"  abc  ".trim()         // 去除首尾空白字符(不含全角空格) → "abc"
" abc ".strip()         // (jdk11+)去除首尾所有空白(含全角) → "abc"
"abc".toUpperCase()      // 转大写 → "ABC"
"ABC".toLowerCase()      // 转小写 → "abc"
"abac".replace("a","x")  // 替换所有指定子串 → "xbxc"
"a1b2".replaceAll("\\d","")    // 按正则替换 → "ab"
"a,b,c".split(",")       // 按正则分割成数组 → ["a","b","c"]
"abc".equals("ABC")      // 判断内容是否相等(区分大小写) → false
"abc".equalsIgnoreCase("ABC")  // 忽略大小写判断相等 → true
1.8 哈希计算简化、链表插入改为尾插法、扩容无需重新计算 hash,性能和稳定性提升; 两者均非线程安全,1.7 头插法扩容易出环形链表,1.8 尾插法规避该问题,但仍不建议多线程使 用。
84. ConcurrentHashMap的底层实现(jdk1.7, jdk1.8实现区别)
1.7 用分段锁(Segment+ReentrantLock),粒度粗;1.8 用 Node+CAS+synchronized 节点锁, 粒度极细,并发性能大幅提升; 1.7 是 Segment 数组嵌套 HashMap,1.8 直接复用 HashMap1.8 的数组 + 链表 / 红黑树,结构 更简洁; 1.7 分段扩容,1.8 多线程协助整体扩容,效率更高。 1.7 支持并发最大Segment数(默认16),理论上无上限(节点级锁)
85. 什么是CopyOnWriteArrayList
CopyOnWriteArrayList 是并发包下线程安全的 ArrayList,核心是「写时复制」 写操作加锁复制新数组,读操作无锁访问原数组; 优点:读操作高性能、线程安全、迭代器不抛并发修改异常; 缺点:写操作性能低、内存开销大、仅保证最终一致性; 适用场景:读多写少的并发场景,不适合写频繁或强一致性要求的场景
86. 集合应该如何遍历,在遍历过程中操作元素有没有安全问题,如何解决安全问
题
遍历方式: 普通 for 循环: 通过索引遍历 增强 for 循环(for-each):语法糖,底层基于迭代器实现 迭代器遍历(Iterator)通过集合的iterator() 获取迭代器,支持手动控制遍历、删除 forEach 方法(JDK8+,函数式):基于 Lambda 表达式,底层仍依赖迭代器 Stream 流遍历(JDK8+): 需要结合过滤、转换等操作的遍历,支持并行遍历 (parallelStream) 安全问题:ConcurrentModificationException(并发修改异常)
类加载器
加载范围
特点
启动类加载器 JRE/lib/rt.jar(核心类库) 由 C++ 实现,无 Java 对象 扩展类加载器/平台类加载 器 JRE/lib/ext/*.jar(扩展类库) Java 实现,父类是 Bootstrap 应用程序类加载器 类路径(classpath)下的类 Java 实现,父类是 Extension 自定义类加载器 自定义路径的类(如加密字节 码) 继承 ClassLoader,按需加 载 快速失败(fail-fast):遍历前记录修改次数(modCount),遍历中检测到 modCount 变化 则抛异常 非线程安全集合在多线程下遍历 + 修改,除了抛异常,还可能导致数据错乱、数组越界 普通 for 循环删除的坑:下标遍历删除元素会导致后续元素前移,漏遍历 解决: 迭代器的 remove 使用线程安全集合:CopyOnWriteArrayList / CopyOnWriteArraySet / ConcurrentHashMap 加锁访问
87. List
实现了list接口的对象是list集合 List集合所有的元素是线性方式存储的 有序、可重复、有索引、可以设空值
88. Set
一、Set集合的特点
- 无序性:Set 集合中的元素不按任何特定顺序排列,无法通过索引访问元素,即集合内部的元素顺序可能随时间和操作发生变化。
- 唯一性:Set 集合不允许包含重复的元素。判断元素是否重复的标准是基于元素的
.equals()方法。如果两个对象在.equals()方法下判断为相等,则 Set 集合中只会存储其中一个。 - 最大容量:理论上,Set 集合可以无限增长,直到受到可用内存限制为止。
二、Set集合的主要实现类
HashSet:基于哈希表实现,具有良好的插入、删除和查找性能,但不保证元素的迭代顺序。TreeSet:基于红黑树实现,元素自动排序(要么基于元素自身的自然排序,要么通过自定义 Comparator),插入、删除和查找性能为O(logn),确保了集合内元素的排序顺序。LinkedHashSet:结合了 HashSet 和 LinkedList 的特性,它维护元素插入的顺序,同时仍然保证元素的唯一性。
| 实现类 | 底层结构 | 有序性 | 重复判断 | 允许 null | 线程安全 | 查询 / 增删效率 |
|---|---|---|---|---|---|---|
| HashSet | HashMap(数组 + 链表 + 红黑树) | 完全无序 | hashCode + equals | 1 个 null | 不安全 | 极高 O(1) |
| LinkedHashSet | LinkedHashMap | 插入有序 | hashCode + equals | 1 个 null | 不安全 | 略低于 HashSet,维护双向链表 |
| TreeSet | TreeMap(红黑树) | 自然排序 / 自定义排序 | compareTo / Comparator | 不允许 | 不安全 | O(logn) |
89. Map
Map: Map 是 Java 中双列集合(键值对存储)的顶级接口
| 特性 | Key(键) | Value(值) |
|---|---|---|
| 是否可重复 | ❌ 不可重复 | ✅ 可重复 |
| 是否有序 | ❌ 无序(部分实现类有序) | 跟随 Key 的顺序 |
| 是否有下标 | ❌ 无下标 | ❌ 无下标 |
| 是否允许 null | ✅ 最多一个 null key | ✅ 允许多个 null value |
| 关系 | 唯一标识 | 可共享 |
90. 工具类
91. Collection
92. ArrayList和LinkedList的区别
ArrayList LinkedList 基于动态数组,数据连续存储 基于双向链表,节点包含数据和指针
快,可以通过索引直接访问 慢,需要遍历节点
末尾操作快,但在中间插入/删除时 头尾操作快,尤其是插入/删除时效率高 需要移动大量数据
占用内存较少,只存储数据本身 占用内存较多,因为每个节点都有两个额外的指针
适合需要快速访问数据的场景, 适合需要频繁插入/删除的场景,如队列 如商品列表
底层是数组,查询快,增删慢 底层是链表,查询慢,增删快
93. 泛型
编译器的语法糖,运行期全靠类型擦除硬撑
优点:
1.数据类型可以像参数一样由外部传入
2.当变量与泛型不匹配时编译器会拦截
3.提高代码可读性
三种使用方法:泛型类,泛型接口,泛型方法
94. Collections常用方法
Collections 是一个操作 Set、List 和 Map 等集合的工具类。Collections 中提供了一系列静态的方法对集合元素进行排序、查询和修改等操作,还提供了对集合对象设置不可变、对集合对象实现同步控制等方法
- 排序相关方法(仅 List 可用) sort () 排序、reverse () 反转、shuffle () 乱序、swap () 交换元素
2.查询统计:max、min、frequency、binarySearch、replaceAll
3.复制:copy
4.线程安全:synchronizedList/Set/Map 坑: synchronizedList/Set/Map底层实现并不是Collection的list而是返回Collections静态内部类的SynchronizedRandomAccessList,里面实现的方法不是同步的,而是方法体中的使用同步块(mutex)来实现
5只读集合:emptyXXX、singletonXXX、unmodifiableXXX
95. Arrays常用方法
一、toString () 打印数组(最常用)
二、sort () 数组排序
三、binarySearch () 二分查找 注意:前提:数组必须提前升序排序
四、copyOf /copyOfRange 数组复制 copyOf:从头复制,可扩容 / 缩容 copyOfRange:区间复制 [from,to) 左闭右开
五、fill () 数组填充赋值
六、equals () /deepEquals () 比较数组是否相等 equals:一维数组,判断每个元素值是否相同 deepEquals:多维数组专用
七、asList () 数组转 List(高频面试坑)
1.Arrays.asList() 返回的是 Arrays 内部静态 ArrayList,固定长度,不能增删;
2.底层共享原数组,数组和 List 修改互相影响;
3.基本数据类型数组转换会把整个数组作为单个元素;
4.业务开发标准写法:new ArrayList<>(Arrays.asList(array));
5基本类型数组用 Stream.boxed () 转包装类 List。
96. 迭代器
97. fail-fast和fail-safe的区别(面试重点)
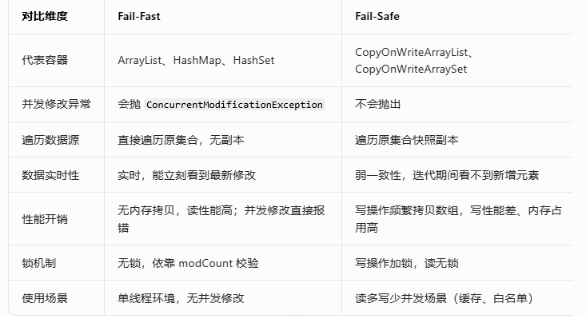
Fail-Fast(快速失败) 迭代集合过程中,检测到集合结构发生修改立刻抛出 ConcurrentModificationException,不允许并发修改。
Fail-Fast:遍历原集合,无锁依靠 modCount(修改计数器) 校验,结构修改立刻抛并发修改异常,适用于单线程,读写无拷贝效率高;必须使用迭代器自带的 iterator.remove() 方法,它会同步更新 expectedModCount。
Fail-Safe(安全失败)
迭代时不操作原集合,拷贝一份底层数据副本遍历;原集合修改不影响迭代器,不会抛并发修改异常。 使用CopyOnWriteArrayList
Fail-Safe:写时复制快照遍历,不抛异常,读多写少并发使用,但写操作开销大、数据非实时;
98. Comparator与Comparable有什么区别(开发是否考虑排序了解)
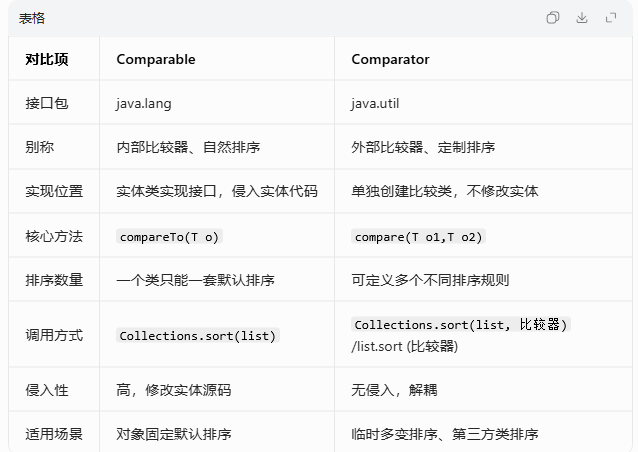
Comparable:实体类自己实现该接口,重写 compareTo(),对象减参数从小到大排序,参数减对象从大到小排序,定义对象默认排序规则,一个类只能有一套默认排序逻辑。
Comparator:外部比较器,不修改实体类代码,单独创建比较器,灵活自定义多种排序规则,一个类可以创建多个不同 Comparator。参数前减后从小到大,后减前从大到小。
高频问答
- 什么时候用哪个? 实体有固定默认排序 → Comparable
需要多种排序规则、临时排序、不能修改实体源码 → Comparator
- sort 同时传 Comparable 和 Comparator,以谁为准?
以Comparator 外部比较器优先,忽略元素自身的 compareTo。 3. 优缺点总结 Comparable 优点:调用简单,直接 sort;缺点:只能一套规则,改排序要改实体
Comparator 优点:多套规则、解耦、灵活;缺点:调用时多传一个参数
99. 函数接口
1.Consumer
2.Supplier
3.Function<T,R> R apply(T) 有参有返 stream.map(Function<T,R>)
4.Predicate
100. 方法引用
1.静态方法引用 接口 引用 = 类名::静态方法名
2.对象方法引用 接口 引用 = 对象::对象方法名
3.构造方法引用 接口 引用 = 类名::new
4.特殊方法引用 接口 引用 = 类名::对象方法名 类名帮对象占位,抽象方法的第一个参数就是调用方法的对象,第二个参数是方法中的第一个参数。
101. Iterator
ListIterator
概念 迭代:一句话总结:就是把集合中的元素 一个一个的拿出来。
Iterator接口的常用方法如下: list,set都可以使用
public E next():返回迭代的下一个元素。注意,在进行集合元素取出时,如果集合中已经没有元素了,还继续使用迭代器的next方法,将会发生java.util.NoSuchElementException没有元素的错误。
public boolean hasNext():如果仍有元素可以迭代,则返回 true。
void remove() ; 根据条件删除元素
List 集合额外提供了一个 listIterator() 方法,该方法返回一个 ListIterator 列表迭代器对象, ListIterator 接口继承了 Iterator 接口 提供了专门操作 List 的方法: void add():通过迭代器添加元素到对应集合 void set(Object obj):通过迭代器替换正迭代的元素 void remove(): 通过迭代器删除刚迭代的元素 boolean hasPrevious():如果以逆向遍历列表,往前是否还有元素。 Object previous(): 返回列表中的前一个元素。 int previousIndex():返回列表中的前一个元素的索引 boolean hasNext() 如果仍有元素可以迭代则返回 true。 Object next() 返回列表中的下一个元素。 int nextIndex() 返回列表中的下一个元素的索引
102. map的三种遍历方式
①: Collection
②:Set
③:Set<Map.Entry<K,V>> entrySet<> 把Map集合中的所有key和value按组一起取出来,并封装成Entry对象,在使用entry.getKey(),与entry.getValue()获取key跟value 最推荐,一次遍历拿到 key 和 value,效率最高
103. TreeSet和HashSet的区别
| 对比维度 | HashSet | TreeSet |
|---|---|---|
| 底层结构 | 哈希表(HashMap) | 红黑树(TreeMap) |
| 元素顺序 | 完全无序 | 自然排序或定制排序(有序) |
| 重复判断 | hashCode() + equals() | compareTo() 或 compare() 返回 0 |
| 是否允许 null | 允许(仅 1 个) | 不允许(比较时无法处理 null) |
| 性能 | 增删查 O(1),效率极高 | 增删查 O(log n),相对较慢 |
| 适用场景 | 快速存取,不关心顺序 | 需要有序输出,或需要范围查找 |
| 内存占用 | 较少(仅存元素) | 较多(红黑树额外维护指针) |
| 线程安全 | 均不安全 | 均不安全 |
104. HashSet
1. 核心特点
- 无序:迭代顺序不保证,且随时间可能改变。
- 允许 null:只能存 1 个。
- 非线程安全:多线程需手动包装(
Collections.synchronizedSet)。 - fail-fast:遍历时并发修改会抛
ConcurrentModificationException。
2. 构造函数关键参数
- 默认容量:16,负载因子:0.75。
- 扩容临界值:
容量 * 0.75。
3. 去重原理
- 先 hashCode,后 equals:
- 调用
hashCode()定位桶位置。 - 若桶空,直接插入。
- 若桶不空,调用
equals()逐一比对,若返回true则拒绝添加。
- 调用
- 铁律:重写
equals()必须重写hashCode(),保证相等对象哈希值一致。
4. 时间复杂度
- 增删查平均:O(1)(哈希分布良好)。
5. 注意事项
- 自定义对象存入必须重写
hashCode()和equals(),否则去重失效。
6. 常用方法
- add:添加元素
- remove:删除元素
- contains:判断是否包含某个元素
- clear:清空
- Iterator:使用迭代器遍历集合
- foreach:遍历集合
105. HashMap与HashTable 的区别
| HashMap | Hashtable | |
|---|---|---|
| 线程安全 | 不安全 | 安全(synchronized) |
| 底层结构 | 数组+链表+红黑树 | 数组+链表 |
| 索引定位 | 位运算与(极快) | 除法取模(较慢) |
| null key | 允许一个 | 不允许 |
| null value | 允许 | 不允许 |
| 性能 | 高 | 低(同步开销) |
| 初始容量 | 16 | 11 |
| 扩容方式 | 2 倍 | 2 倍 + 1 |
| 迭代器 | fail-fast | fail-fast,Enumeration |
| 诞生时间 | JDK 1.2 | JDK 1.0(基本被取代) |
106. ArrayList源码的关键点
ArrayList底层实现:可变长的数组,有索引,查询效率高,增删效率低
构造方法:
new ArrayList():
jdk6中,空参构造直接创建10长度的数组。
jdk7(新版)、jdk8中,默认初始容量0,在添加第一元素时初始化容量为10
new ArrayList(int initialCapacity):
指定初始化容量
添加元素:add(E e);
首次添加元素,初始化容量为10
每次添加修改modCount属性值
每次添加检查容量是否足够,容量不足时需要扩容,扩容大小为原容量的1.5倍
11 ==> 15
移除元素:remove(E e);
每次成功移除元素,修改modCount值
每次成功移除需要需要移动元素,以保证所以元素是连续存储的(删除操作效率低的原因)
107. 求两个List的交集元素?
第一种是双层 for 循环,外层遍历第一个集合、内层遍历第二个,判断相等加入结果。但时间复杂度是 O (M*N),数据量稍微大一点性能很差
第二种是 HashSet 优化方案,先把长度更短的 List 转为 HashSet,利用 HashSet O (1) 的 contains 查询降低复杂度,整体时间复杂度 O (M+N)。遍历长集合,判断元素在 Set 中存在就加入交集,同时可以删除 Set 中已匹配的元素,自动给交集去重
第三种是 Java8 Stream 流式写法,代码最简洁。但直接用 list.contains 会有性能问题,所以先把第二个 List 转 HashSet 再过滤,搭配 distinct 去重,适合 JDK8 以上新项目。
108. 常用方法
1、添加元素
(1)add();添加元素对象到当前集合中,把传入内容当成一整个对象添加,只 + 1 个元素;
(2)addAll():添加other集合中的所有元素对象到当前集合中
2、删除元素
(1) boolean remove(Object obj) :从当前集合中删除第一个找到的与obj对象equals返回true的元素。
(2)boolean removeAll(Collection<?> coll):从当前集合中删除所有与coll集合中相同的元素。即this = this - this ∩ coll
(3)boolean retainAll(Collection<?> coll):从当前集合中删除两个集合中不同的元素,使得当前集合仅保留与c集合中的元素相同的元素,即当前集合中仅保留两个集合的交集;
(4) void clear(); 清空集合
(5)boolean removeIf(Predicate<? super E> filter) :删除满足给定条件的此集合的所有元素。removeIf方法是Java8引入的。
3、查询与获取元素
(1)boolean isEmpty():判断当前集合是否为空集合。
(2)boolean contains(Object obj):判断当前集合中是否存在一个与obj对象equals返回true的元素。
(3)boolean containsAll(Collection<?> c):判断c集合中的元素是否在当前集合中都存在。即c集合是否是当前集合的“子集”。
(4)int size():获取当前集合中实际存储的元素个数
(5)Object[] toArray():返回包含当前集合中所有元素的数组
109. 常用方法
1、添加元素
void add(int index, E ele):把元素添加到指定位置
boolean addAll(int index, Collection<? extends E> eles):把一组元素添加到指定位置
2、删除元素
E remove(int index):删除指定位置的元素
3、修改元素
E set(int index, E ele):替换[index]位置的元素
default void replaceAll(UnaryOperator
4、获取元素
E get(int index):返回[index]位置的元素
List subList(int fromIndex, int toIndex):返回[fromIndex, toIndex)范围的元素
int indexOf(Object obj):查询obj在列表中的位置,如果有重复,返回第1个
int lastIndexOf(Object obj):查询obj在列表中的位置,如果有重复,返回最后1个
boolean contains(E ele) 判断某个元素是否存在
clear()
boolean isEmpty()
110. 常用方法
| 方法 | 说明 |
|---|---|
add(E e) | 添加元素,若已存在则返回 false |
remove(Object o) | 删除指定元素 |
contains(Object o) | 判断是否包含某元素 |
size() | 返回元素个数 |
isEmpty() | 判断集合是否为空 |
clear() | 清空集合 |
iterator() | 返回迭代器 |
toArray() | 转为数组 |
注意:TreeSet 还额外提供 first()、last()、headSet()、tailSet()、subSet() 等范围相关方法。 |
111. 底层实现
1. 本质
- 内部持有
HashMap<E, Object> - 元素作为 Key,Value 统一为静态占位对象
PRESENT
private transient HashMap<E,Object> map;
private static final Object PRESENT = new Object();
2. 核心方法映射
| 方法 | 实际调用 | 结果判断 |
|---|---|---|
add(e) | map.put(e, PRESENT) | 返回 null → 添加成功 |
remove(o) | map.remove(o) | 返回 PRESENT → 删除成功 |
contains(o) | map.containsKey(o) | Key 存在 → true |
3. 底层数据结构(JDK 1.8+)
- 数组 + 链表 + 红黑树
| 转换 | 条件 |
|---|---|
| 链表 → 红黑树 | 链表长度 ≥ 8 且数组容量 ≥ 64 |
| 红黑树 → 链表 | 节点数 ≤ 6 |
4. 添加流程(去重原理)
- 计算
hashCode()→(n-1) & hash定位桶 - 桶空 → 直接插入
- 桶不空 → 遍历链表/红黑树,用
equals()比较- 相等 → 不添加,返回
false - 全部不等 → 挂载尾部,返回
true
- 相等 → 不添加,返回
5. 哈希计算
hash = (key == null) ? 0 : (h = key.hashCode()) ^ (h >>> 16)- 解释:高 16 位与低 16 位异或混合,减少冲突
6. 扩容机制
- 触发条件:元素数 > 容量 × 负载因子(默认 16 × 0.75 = 12)
- 新容量 = 旧容量 << 1(2 倍)
- 元素重新计算索引(rehash)
7. 核心特点
- 非线程安全 → 用
Collections.synchronizedSet()包装 - fail-fast → 遍历时并发修改抛异常
- 允许 1 个
null
8. 性能
- 增删查平均:O(1)
- 最坏(严重哈希冲突):O(log n)(红黑树优化)
9. 一句话总结
HashSet 本质就是 HashMap 的 Key 集合,所有操作都委托给 HashMap。
112. 去重原理
1. HashSet / LinkedHashSet
- 先调用元素的
hashCode()计算哈希值,定位到桶位置(槽位)。 - 若桶内无元素,直接存入;若有元素,再通过
equals()比较:- 若
equals()返回true,则视为重复元素,不添加; - 若
equals()返回false,则以链表/红黑树形式挂载。
- 若
- 要求:重写
equals()时必须重写hashCode(),保证相等对象哈希值一致。
2. TreeSet
- 不依赖
hashCode()和equals(),而是通过 比较器(Comparator或元素的compareTo)判断重复。 - 当
compareTo()或compare()返回0时,认为两个元素相等,不添加。 - 因此,元素的 比较逻辑 决定了去重行为。
113. List 去重
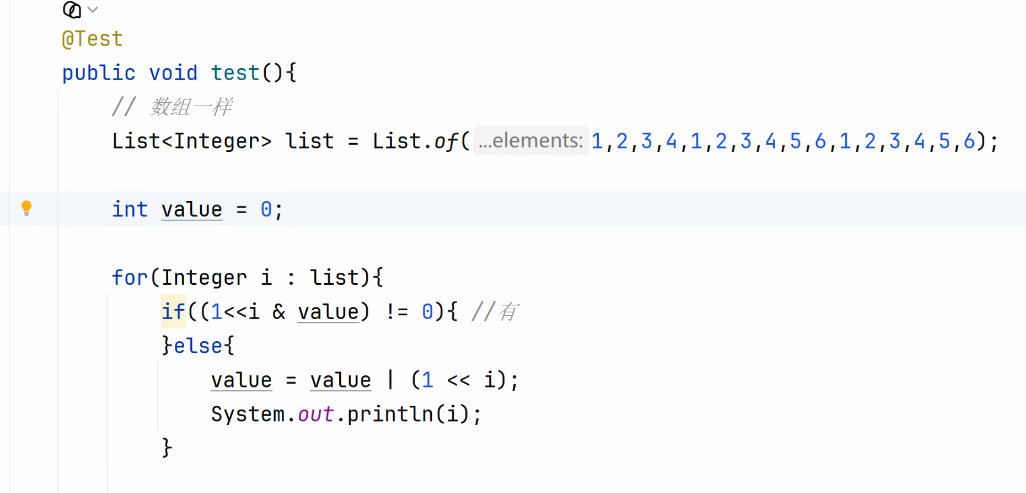
- new HashSet(list)
- list.stream().distinct() 3如果要问要求不使用这些工具类跟方法如何实现(如图)
int 有 32 个二进制位,每一位对应一个数字,第 i 位为 1 就代表数字 i 已经出现过,初始是 0,全部未标记。 遍历每个数字 i 的时候,先用 1 左移 i 位,生成只有第 i 位为 1 的二进制掩码;再和 value 做按位与,如果结果不为 0,说明这个数字之前出现过,直接跳过;如果等于 0 就是第一次出现,用按位或把 value 的第 i 位设为 1 做标记,同时打印这个数字。
对比 HashSet 去重,各自适用场景? 数字集中、量小用位运算,极致性能省内存;数字分散、有负数、业务通用场景用 HashSet,可读性和兼容性更强。
114. Map常用方法
添加操作: ①V put(K key, V value) 添加键值对。若key已存在,替换旧值并返回旧值;若 key 不存在,返回 null ②void putAll(Map<? extends K, ? extends V> m) 将另一个 Map 中的所有键值对添加到当前 Map
删除操作: ①V remove(Object key) 根据 key 删除键值对,返回被删除的 value;若 key 不存在,返回 null ②void clear() 清空所有键值对
查询操作:
①V get(Object key) 根据key获取value。key不存在则返回 null
②V getOrDefault(Object key, V defaultValue) 获取 key 对应的 value,若不存在则返回默认值 defaultValue
③boolean containsKey(Object key) 判断是否包含指定的 key
④boolean containsValue(Object value) 判断是否包含指定的 value ⑤boolean isEmpty() 判断 Map 是否为空
修改操作: ①V replace(K key, V newValue) 替换指定 key 的值为 newValue。key 不存在则不操作,返回 null
其他常用方法:
| 方法 | 说明 |
|---|---|
int size() | 返回键值对的数量 |
Set<K> keySet() | 获取所有 key 组成的 Set 集合 |
Collection<V> values() | 获取所有 value 组成的 Collection |
Set<Map.Entry<K,V>> entrySet() | 获取所有键值对(Entry)组成的 Set |
115. HashMap
HashMap —— 最常用、默认选择
特点
- 键无序(不保证存入和取出的顺序一致)
- 键不重复
- 键无索引
- 允许 key 和 value 为 null(key 最多一个 null)
- 线程不安全
底层原理
HashMap 的底层是 哈希表,在 JDK 8 之后是 数组 + 链表 + 红黑树 的结构。
核心流程:
- 创建 HashMap → 默认初始化一个长度为 16 的数组(Node[])
- 调用 put(key, value) →
a. 计算 key 的 hashCode(),得到哈希值
b. 通过哈希值计算在数组中的索引位置
c. 如果该位置为空 → 直接存入
d. 如果该位置不为空 → 调用 equals() 比较
- equals 返回 true → 替换旧值(key 已存在)
- equals 返回 false → 发生哈希冲突,以链表形式挂在后面
在 JDK 8 及以后,当你执行 new HashMap() 时,底层其实并没有立刻创建这个长度为 16 的数组。数组是在你第一次调用 put() 方法时才被真正创建出来的。为了节省内存使用懒加载
扩容机制
重要参数:
- 初始容量(capacity):默认 16
- 加载因子(load factor):默认 0.75
- 阈值(threshold):capacity × load factor = 16 × 0.75 = 12
当元素个数超过阈值(12)时 → 扩容为原来的 2 倍(16 → 32)
红黑树转换条件: 当链表长度 > 8 且 数组长度 ≥ 64 → 链表转红黑树(提高查询效率) 当链表长度 > 8 但 数组长度 < 64 → 先扩容数组(不转红黑树) 当红黑树节点数 < 6 → 红黑树退化为链表
面试题:为什么自定义对象做 Key 要重写 hashCode 和 equals
因为 HashMap 依赖这两个方法来判断 key 的唯一性: put(key, value) 的过程:
- hashCode() → 确定存储位置(数组索引)
- equals() → 判断该位置上是否有相同的 key
如果只重写 equals 不重写 hashCode: → 两个对象 equals 相等,但 hashCode 不同 → 被存到不同的位置 → 导致 Map 中出现了”重复的 key”
如果只重写 hashCode 不重写 equals: → hashCode 相同,但 equals 不相等 → 能定位到正确位置,但无法区分 key 是否重复 → 会一直在同一个位置追加链表(性能下降)
116. LinkedHashMap
LinkedHashMap —— 要顺序就用它
特点
- 键有序(保证存储和取出的顺序一致 —— 插入顺序)
- 键不重复
- 键无索引
- 是 HashMap 的子类
底层原理
哈希表 + 双向链表
在 HashMap 的基础上,额外维护了一个双向链表, 记录了每个 Entry 的插入顺序(或访问顺序), 所以遍历时能保持顺序。
特殊构造函数 public LinkedHashMap(int initialCapacity, float loadFactor, boolean accessOrder) { super(initialCapacity, loadFactor); this.accessOrder = accessOrder; } accessOrder = false(默认值:按插入顺序排序) accessOrder = true(按访问顺序排序)
- 链表头部(Head):存放的是最久没有被访问过的元素(最老、最该被淘汰)。
- 链表尾部(Tail):存放的是最近刚刚被访问过的元素(最热、最应该保留)
适用场景
- 需要一个 Map,又希望元素按插入顺序排列
- 如果要实现 LRU 缓存(最近最少使用淘汰),可以设置
accessOrder=true
117. TreeMap
TreeMap —— 要排序就用它
特点
- 键可排序(默认按 key 的自然顺序升序)
- 键不重复
- 键无索引
- 不允许 key 为 null(会抛 NullPointerException)
底层原理
红黑树(Red-Black Tree)
特点:插入时自动排序,查找、插入、删除的时间复杂度都是 O(log n)
排序规则
| 方式 | 说明 | 示例 |
|---|---|---|
| ① 自然排序 | Key 实现 Comparable 接口,重写 compareTo() | String、Integer 等已实现 |
| ② 比较器排序 | 创建 TreeMap 时传入 Comparator 比较器对象 | 灵活,不修改原类 |
优先级: 如果同时存在,以构造时传入的 Comparator 为准。
适用场景
- 需要对 key 进行排序的场景
- 需要范围查询(比如找出所有大于某个 key 的元素)
118. HasTable
Hashtable —— 古老、线程安全
特点
- 线程安全(方法用 synchronized 修饰)
- 不允许 key 或 value 为 null
- 比 HashMap 更早出现(JDK 1.0),现在基本被 HashMap + ConcurrentHashMap 取代
- 性能比 HashMap 差(全表锁)
119. 主要实现类
120. 集合跟数组的区别
数组:
- 优点:访问速度快,因为可通过索引直接访问元素。
- 缺点:大小固定,不适合在不知道数据量的情况下使用。
- 使用场景:当确定数据大小时,或者需要快速随机访问时。
集合:
- 优点:大小可动态变化,提供了更为广泛的功能,如添加、删除元素。
- 缺点:访问元素时通常需要迭代,速度相对较慢。
- 使用场景:当数据大小未知或需要方便的添加、删除操作时。
121. lambda
接口里只有一个抽象方法,可以使用lambda表达式
122. 泛型类
一.泛型类: 1.定义:类型参数在类的定义中
泛型标识: T:任意类 type E:元素/异常 K:key V:value S:subtype 子类 R: return 返回值类型 不固定,本身算是一种参数名,随意起名
泛型的定义位置: 1)非静态的成员属性类型 2)非静态方法的形参类型和返回值类型
2.泛型类中的静态方法和静态变量不能用泛型类定义的泛型 静态在类加载时完成初始化,静态就不知道泛型的类型,报错.非静态在调用时加载,已经知道类型
3.可以接受多个参数类型 4.创建泛型类的对象时一定要指定泛型的具体数据类型,<>中不写就是Object
123. 泛型接口
泛型接口 1.泛型接口中的类型参数,在该接口被继承或实现时确定 2.同泛型类 ,接口中的属性默认静态,静态变量和静态方法也不能用接口声明的泛型 3.在实现泛型接口时泛型不指定就为Object
124. 泛型方法
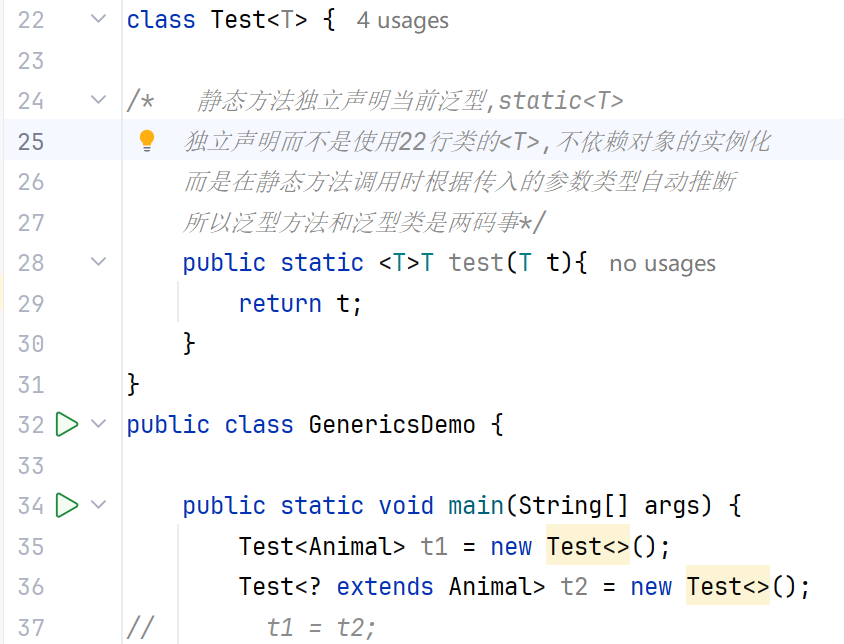
三.泛型方法 1.返回值前面声明了一个泛型,就是泛型方法,这个泛型只能在该方法中使用 2.泛型方法可以使用泛型类定义的泛型参数 3.仅使用泛型类定义的泛型参数的方法不是泛型方法 4.泛型方法可以声明多个参数类型 5.泛型方法中也可以使用泛型类定义的泛型参数,只要不是静态,就可以使用泛型类的泛型 6.特别注意,泛型类定义的泛型和泛型方法定义的泛型是相互独立的 7.使用:泛型方法在调用方法时确定具体参数类型. 泛型方法声明的泛型只能在方法里用 使用泛型类定义的泛型的静态方法报错,但使用自己定义的泛型的静态方法可以运行,因为调用才确定参数 8.调用泛型方法时,可以显示指定类型参数,也可以不指定 不指定&多个参数:类型参数为两个的最小共同父类,直到Object
125. 类型擦除
四.类型擦除 1.定义:编译器在编译期间擦除代码中的泛型语法并做出相应的类型转换.泛型信息只存在于编译阶段,不会进入运行阶段,class文件里没有泛型信息 2.泛型擦除后默认Object替换,使用了泛型通配符的例外 3.擦除原理:编译器先检查代码传入的T的数据类型并记录,编译的同时进行擦除,之后在操作编译器就会自动将对象进行类型转换.
126. 泛型通配符
非限定通配符
无限定通配符只能读不能写(null除外),读出来只能是object
不关心类型,只做与类型无关的事
大多数情况下
限定通配符 1.<? extend T>上界通配符 T代表类型的上界,这个表示的参数类型是T和T的子类 作用:不关心具体类型从集合里读取数据 限制:只能读不能写(null除外) 只能读不能写
2.<? super T>下界通配符 T代表类型的下界,表示参数类型是T和T的父类 作用:不关心具体数据类型往集合内写数据 限制:能写入 T 及子类,但读出只能到 Object 只能写不能读,读出来的只当做Object类型
PECS原则: 怎么选择泛式通配符
需要返回T,是生产者,用extend 需要写入T,是消费者,使用super
127. 常见集合的线程安全
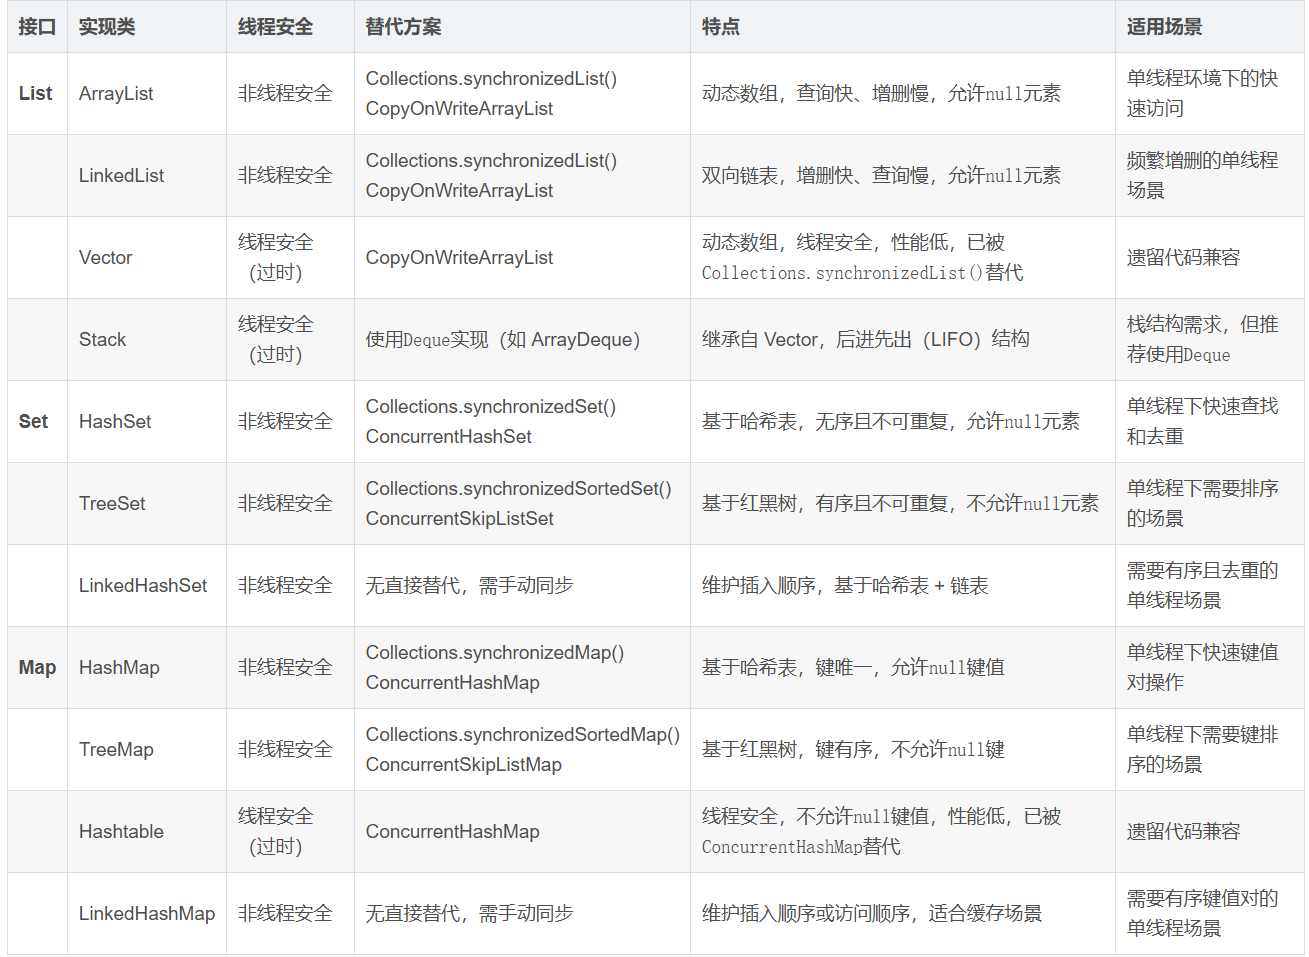
128. 集合遍历过程中如何正确删除元素
1.Iterator迭代器的remove方法 2.反着删 3.removeif(jdk8)
三、多线程与 JUC
129. 线程与进程及其关系?
进程是指一种正在运行的程序,有自己的地址空间;进程内部的一个执行单元,它是程序中一个单一的 顺序控制流程。 一个进程中可以有多个线程,多个线程共享进程的堆叠和方法区 (JDK1.8 之后的元空间)资源,但每个线 程都有自己的程序计数器、虚拟机栈和本地方法栈。 备注:进程和线程可以理解为公路和车道的关系,迅雷软件和迅雷下载任务的关系
130. 并发和并行有什么区别?
并发和并行是一个很容易混淆的概念。并发是指多个任务的交替,而并行是指真正意义上的“同时进 行”。事实上,如果系统中只有一个CPU,在实际系统环境中不能并行使用多线程,则只能通过切换时间 片来交替执行任务。真正的并行只能出现在拥有多个CPU的系统中。 并行(parallel):指在同一时刻,有多条指令在多个处理器上同时执行。所以无论从微观还是从宏观 来看,二者都是一起执行的。 并发(concurrency):指在同一时刻只能有一条指令执行,但多个进程指令被快速的轮换执行,使 得在宏观上具有多个进程同时执行的效果,但在微观上并不是同时执行的,只是把时间分成若干 段,使多个进程快速交替的执行
131. 为什么要使用并发?
并发编程在一定程度上离不开多核CPU的发展。 随着单核CPU的研发,无法遵循“摩尔定律,为了进一步提高计算速度,硬件工程师不再追求单独的计算 单元,而是将多个计算单元集成在一起,即形成多核CPU。短短十几年,Intel等家用CPU i7可以达到4 个甚至8个核心。短短十几年,Intel等家用CPU i7可以达到4个甚至8个核心。专业服务器通常可以达到 几个独立的CPU,每个CPU甚至有8个以上的核心。因此,“摩尔定律”它似乎继续体验CPU的核心扩展。” (摩尔定律是基于硬件开发的观测定律,也是基于“摩尔定律”的“反摩尔定律”,不过“反摩尔定律”是软件领 域的定律,有兴趣的可以自己理解) 在多核CPU的背景下,并发编程的趋势应运而生。通过并发编程,可以充分发挥多核CPU的计算能力, 提高其性能。
132. 并发编程有哪些缺点?
(1)上下文切换频繁 时间片是CPU分配给每个线程的时间,因为时间很短,所以CPU不断切换线程,让我们觉得多个线程是 同时执行的,时间片通常是几十毫秒。每次切换时,都需要保存当前状态,以恢复以前的状态。这种切 换行为非常失去性能。过于频繁的切换不能充分发挥多线程编程的优势。无锁并发编程可用于通常减少 上下文切换。 CAS算法,使用最少的线程和使用协程。 (2)线程的安全问题 多线程编程中最难把握的是临界区域的线程安全(如果多个人购买了同一张火车票,火车票数出现负数 等)。严重的甚至出现死锁。一旦产生死锁,系统功能将不可用。
133. 上下文切换是什么?
多线程编程中一般线程的数量大于 CPU 核心数,而一个 CPU 为了有效地执行这些线程,核心只能在任 何时候使用一个线程,CPU 策略是将时间片分配到每个线程并旋转。当一个线程的时间片用完时,它将 重新处于就绪状态,供其他线程使用。这个过程属于上下文切换。 上下文切换通常是计算密集型的。换句话说,它需要相当可观的处理器时间。在每秒几十次或数百次的 切换中,每次切换都需要纳秒量级时间。因此,上下文切换意味着系统消耗了大量事实上,CPU时间可 能是操作系统中时间消耗最大的操作。Linux与其他操作系统相比(包括其他类别)Unix系统有很多优点, 其中之一就是上下文切换和模式切换的时间消耗很少。
134. Thread和Runnable的区别
Thread和Runnable的实质是继承关系,没有可比性。无论使用Runnable还是Thread,都会 newThread,然后执行run方法。用法上,如果有复杂的线程操作需求,那就选择继承Thread,如果只 是简单的执行一个任务,那就实现runnable。 //会卖出多一倍的票
publicclassTest {
publicstaticvoidmain(String[] args) {
// TODO Auto-generated method stub
newMyThread().start();
newMyThread().start();
}
staticclassMyThreadextendsThread{
privateintticket=5;
publicvoidrun(){
while(true){
System.out.println("Thread ticket = "+ticket--);
if(ticket<0){
break;
}
}
}
}
}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
//正常卖出
publicclassTest2 {
publicstaticvoidmain(String[] args) {
// TODO Auto-generated method stub
1
2
3
4
原因是:MyThread创建了两个实例,自然会卖出两倍,属于用法错误。
135. 多线程的五种实现方式
1, 继承Thread,重写run方法,最后创建Thread 的子类对象,调用start()方法开启线程任务
例子(example):
2, 实现Runnable接口,重写run方法,创建Runnable 的实现类对象,通过Thread 的构造传递,调用start() 方 法开启线程任务
例子(example):
MyThread2mt=newMyThread2();
newThread(mt).start();
newThread(mt).start();
}
staticclassMyThread2implementsRunnable{
privateintticket=5;
publicvoidrun(){
while(true){
System.out.println("Runnable ticket = "+ticket--);
if(ticket<0){
break;
}
}
}
}
}
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
packagese.thread.create;
publicclassCreateThread_1 {
publicstaticvoidmain(String[] args) {
Threadthread=newThread(newMyThread());
thread.start();
}
}
classMyThreadextendsThread {
@Override
publicvoidrun() {
System.out.println("do some  thing");
}
}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
packagese.thread.create;
publicclassCreateThread_2 {
publicstaticvoidmain(String[] args) {
Threadthread=newThread(newMyRunnable());
thread.start();
}
}
1
2
3
4
5
6
7
8
9
3, 实现Callable接口,重写call方法,创建Callable的实现类对象,将Callable 的实现类对象,传递到 FutureTask的构造方法中,最后将FutureTask传递到Thread 的构造方法中,通过start()方法开启线程任务
例子(example):
classMyRunnableimplementsRunnable {
@Override
publicvoidrun() {
System.out.println("do some thing");
}
}
10
11
12
13
14
15
packagese.thread.create;
packagecom.yuma.juc.thread4;
importjava.util.concurrent.Callable;
importjava.util.concurrent.ExecutionException;
importjava.util.concurrent.FutureTask;
publicclassCreateThread_3 {
publicstaticvoidmain(String[] args) throwsExecutionException,
InterruptedException {
FutureTask<Integer>futureTask=newFutureTask<Integer>(new
MyCallable());
Threadthread=newThread(futureTask);
thread.start();
Integerresult=futureTask.get();
System.out.println(result);
}
}
/**
* Callable 和Runnable接口有什么区别- 1、Callable接口中也是一个函数式接口里面拥有一个call方法
* 2、Callable接口的call方法可以有返回值。
* 3、Callable接口中的call方法可以抛异常(run()方法和call()方法都能抓异常)
*/
classMyCallableimplementsCallable<Integer> {
// 抛异常
@Override
publicIntegercall() throwsException {
// 抓异常
try {
System.out.println("do some thing");
} catch (Exceptione) {
e.printStackTrace();
}
return100;
}
}
classMyRunnableimplementsRunnable {
@Override
publicvoidrun() {
// 捕获异常
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
4、使用线程池创建
例子(example):
5、使用jdk1.8自带的异步编排方式
例子(example):
try {
inti=1/0;
} catch (Exceptione) {
System.out.println("do some thing");
e.printStackTrace();
}
}
}
44
45
46
47
48
49
50
51
packagese.thread.create;
importjava.util.concurrent.*;
publicclassCreateThread_4 {
publicstaticvoidmain(String[] args) {
// 比如使用线程池工具类
ExecutorServiceexecutorService=Executors.newFixedThreadPool(1);
executorService.submit(() -> {
System.out.println("do some thing");
});
// 比如自定义线程池
ThreadPoolExecutorthreadPoolExecutor
=newThreadPoolExecutor(10,20,30,TimeUnit.MINUTES,new
LinkedBlockingQueue<>());
threadPoolExecutor.execute(newRunnable() {
@Override
publicvoidrun() {
System.out.println("do some thing");
}
});
}
}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
packagese.thread.create;
importjava.util.concurrent.CompletableFuture;
importjava.util.concurrent.ExecutorService;
importjava.util.concurrent.Executors;
publicclassCreateThread_5 {
publicstaticvoidmain(String[] args) {
// 使用异步编排
CompletableFuture.runAsync(() -> {
System.out.println("开始执行一个任务");
});
1
2
3
4
5
6
7
8
9
10
11
12
13
创建方式
优点
缺点
适用场景
继承Thread 简单直接 单继承限制,耦合度 高 简单测试,不推荐生产 环境 实现Runnable 解耦,可继承其 他类 无返回值,不能抛异 常 大多数业务场景,推荐 使用 Callable+Future 有返回值,可抛 异常 使用复杂,获取结果 阻塞 需要获取执行结果的场 景 线程池 资源复用,管理 方便 配置复杂,可能泄漏 高并发,生产环境首选 CompletableFuture 异步编程,链式 调用 API复杂,调试困难 复杂异步任务编排 备注:不管是哪种方式创建,底层都间接或直接关联到 Runnable 接口。
136. sleep()、join()、yield()的区别
- sleep ():当前线程 “休眠” 指定时间 核心逻辑:静态方法,调用后当前线程暂停执行指定毫秒数,期间不会释放持有的锁(比如 synchronized 锁),时间到后重新进入就绪状态,等待 CPU 调度。 典型场景:固定时间暂停(比如定时任务、模拟延迟)。
- join ():让调用者 “等待” 该线程完成 核心逻辑:实例方法,调用thread.join()后,调用者线程(比如主线程)会进入等待状态,直 到thread线程执行完毕;join(long millis)是超时等待 —— 超过指定时间后,调用者不再 等待,继续执行。 典型场景:需要等待某个线程执行完(比如主线程等子线程计算结果)。
- yield ():当前线程 “礼让” CPU 执行权 核心逻辑:静态方法,调用后当前线程主动让出 CPU 执行权,但仍处于就绪状态(不是等待 / 休 眠),操作系统可能立刻再次调度该线程(比如没有其他就绪线程时);不会释放锁,也不会抛出 中断异常。 典型场景:让优先级相同的线程更公平地执行(实际开发中很少用,因为调度器行为不可控)。
}
}
14
15
特性
sleep(longmillis) join() / join(long millis) yield() 方法归 属 Thread类(静态方法) Thread类(实例方法)
Thread类(静态方法) 作用对 象 当前执行的线程 调用该方法的线程实例 当前执行的线程 核心作 用 让当前线程暂停指定时间 让调用者线程等待该线程执 行完毕 让当前线程主动让出 CPU 执行权 线程状 态 进入TIMED_WAITING(超 时等待) 调用者线程进入
WAITING/TIMED_WAITING
仍处于 RUNNABLE(就 绪)状态 是否释 放锁 不释放(持有锁时,其他线 程仍拿不到) 不释放(同上) 不释放(同上) 是否可 被中断 是(会抛出
InterruptedException )是(同上) 否(无异常,中断状 态不影响) 执行后 调度 时间到后重新进入就绪队 列,等待 CPU 调度 被等待线程执行完 / 超时 后,调用者就绪 立刻进入就绪队列, 可能马上被再次调度
137. 什么是守护线程?与普通线程的区别
守护线程是在程序运行时在后台提供一种支持性的线程。与普通线程相比,守护线程有以下几个区别:
- 终止条件:当所有用户线程结束时,守护线程会自动停止。换句话说,守护线程不会阻止程序的终 止,即使它们还没有执行完任务。
- 生命周期:守护线程的生命周期与主线程或其他用户线程无关。当所有的非守护线程都结束时, JVM 将会退出并停止守护线程的执行。
- 线程优先级:守护线程的优先级默认与普通线程一样。优先级较高的守护线程也不能够保证在其他 线程之前执行。
- 资源回收:守护线程通常被用于执行一些后台任务,例如垃圾回收、日志记录、定时任务等。当只 剩下守护线程时,JVM 会自动退出并且不会等待守护线程执行完毕。 需要注意的是,守护线程与普通线程在编写代码时没有太大的区别。可以通过将线程的 setDaemon(true)方法设置为 true,将普通线程转换为守护线程。 总结起来,守护线程在程序运行过程中提供一种支持性的服务,会在所有的用户线程结束时自动停止。
138. 谈谈对守护线程的理解
守护线程:为所有非守护线程提供服务的线程;任一个守护线程都是整个JVM中所有非守护线程的保 姆; 守护线程类似于整个进程的一个默默无闻的小喽喽;它的生死无关重要,它却依赖整个进程而运行;哪 天其他线程结束了,没有要执行的了,程序就结束了,理都没理守护线程,就把它中断了; 注意:由于守护线程的终止是自身无法控制的,因此千万不要把IO、File等重要操作逻辑分配给它;因 为它不靠谱;
守护线程的作用是什么?
举例, GC垃圾回收线程:就是一个经典的守护线程,当我们的程序中不再有任何运行的Thread,程序就 不会再产生垃圾,垃圾回收器也就无事可做,所以当垃圾回收线程是JVM上仅剩的线程时,垃圾回收线 程会自动离开。它始终在低级别的状态中运行,用于实时监控和管理系统中的可回收资源。
应用场景:
(1)来为其它线程提供服务支持的情况; (2)或者在任何情况下,程序结束时,这个线程必须正常且立刻关闭,就可以作为守护线程来使用; 反之,如果一个正在执行某个操作的线程必须要正确地关闭掉否则就会出现不好的后果的话,那么这个 线程就不能是守护线程,而是用户线程。通常都是些关键的事务,比方说,数据库录入或者更新,这些 操作都是不能中断的。 thread.setDaemon(true)必须在thread.start()之前设置,否则会跑出一个IllegalThreadStateException 异常。你不能把正在运行的常规线程设置为守护线程。 在Daemon线程中产生的新线程也是Daemon的。 守护线程不能用于去访问固有资源,比如读写操作或者计算逻辑。因为它会在任何时候甚至在一个操作 的中间发生中断。 Java自带的多线程框架,比如ExecutorService,会将守护线程转换为用户线程,所以如果要使用后台线 程就不能用Java的线程池。
139. Java中止线程的三种方式
停止一个线程通常意味着在线程处理任务完成之前停掉正在做的操作,也就是放弃当前的操作。 在 Java 中有以下 3 种方法可以中止正在运行的线程:
- 使用退出标志,使线程正常退出,也就是当 run() 方法完成后线程中止。
- 使用 stop() 方法强行中止线程,但是不推荐使用这个方法,该方法已被弃用。
- 使用 interrupt 方法中断线程。
1). 使用标志位中止线程(推荐)
在 run() 方法执行完毕后,该线程就中止了。但是在某些特殊的情况下,run() 方法会被一直执行;比如 在服务端程序中可能会使用while(true) { … }这样的循环结构来不断的接收来自客户端的请求。 此时就可以用修改标志位的方式来结束 run() 方法。
publicclassExitFlagTests {// volatile修饰符用来保证其它线程读取的总是该变量的最新的值
privatevolatilebooleanexitFlag=false; // 退出标志
publicvoidrun() {
while (!exitFlag) {
// 执行线程的任务
System.out.println("Thread is running...");
try {
Thread.sleep(1000); // 模拟一些工作
} catch (InterruptedExceptione) {
// 处理中断(如果需要)
Thread.currentThread().interrupt(); // 重新设置中断状态
}
}
System.out.println("Thread is stopping...");
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
2). 使用 stop() 中止线程(不推荐)
Thread.stop() 方法可以强行中止线程的执行。然而,这种方法是不安全的,因为它不保证线程资源的 正确释放和清理,可能导致数据不一致和资源泄露等问题,因此已被官方弃用。 通过查看 JDK 的 API,我们会看到 java.lang.Thread 类型提供了一系列的方法如 start()、stop()、 resume()、suspend()、destory()等方法来管理线程。但是除了 start() 之外,其它几个方法都被声名为 已过时(deprecated)。 虽然 stop() 方法确实可以停止一个正在运行的线程,但是这个方法是不安全的,而且该方法已被弃用, 最好不要使用它。 JDK 文档中还引入用一篇文章来解释了弃用这些方法的原因:《Why are Thread.stop, Thread.suspend and Thread.resume Deprecated?》
}
publicvoidstop() {
exitFlag=true; // 设置退出标志为true
}
publicstaticvoidmain(String[] args) throwsInterruptedException {
ExitFlagTestsexit=newExitFlagTests();
Threadthread=newThread(exit::run);
thread.start();
// 让线程运行一段时间
Thread.sleep(5000);
// 请求线程停止
exit.stop();
}
}
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
publicclassStopMethodTestsextendsThread {
publicvoidrun() {
while (true) {
System.out.println("Thread is running...");
try {
Thread.sleep(1000);
} catch (InterruptedExceptione) {
Thread.currentThread().interrupt();
}
}
}
publicstaticvoidmain(String[] args) throwsInterruptedException {
StopMethodTeststhread=newStopMethodTests();
thread.start();
// 让线程运行一段时间
Thread.sleep(5000);
// 强行中止线程(不推荐)
thread.stop();
}
}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
为什么弃用stop:
- 调用 stop() 方法会立刻停止 run() 方法中剩余的全部工作,包括在 catch 或 finally 语句中的,并抛 出ThreadDeath异常(通常情况下此异常不需要显示的捕获),因此可能会导致一些清理性的工作的 得不到完成,如文件,数据库等的关闭。
- 调用 stop() 方法会立即释放该线程所持有的所有的锁,导致数据得不到同步,出现数据不一致的问 题。
3). 使用 interrupt() 中断线程
现在我们知道了使用 stop() 方式停止线程是非常不安全的方式,那么我们应该使用什么方法来停止线程 呢?答案就是使用 interrupt() 方法来中断线程。 需要明确的一点的是:interrupt() 方法并不像在 for 循环语句中使用 break 语句那样干脆,马上就停止 循环。调用 interrupt() 方法仅仅是在当前线程中打一个停止的标记,并不是真的停止线程。 也就是说,线程中断并不会立即中止线程,而是通知目标线程,有人希望你中止。至于目标线程收到通 知后会如何处理,则完全由目标线程自行决定。这一点很重要,如果中断后,线程立即无条件退出,那 么我们又会遇到 stop() 方法的老问题。 事实上,如果一个线程不能被 interrupt,那么 stop 方法也不会起作用。 我们来看一个使用 interrupt() 的例子:
publicclassInterruptTestsextendsThread{
publicstaticvoidmain(String[] args) {
try {
InterruptTestst=newInterruptTests();
// 启动线程
t.start();
Thread.sleep(200);
// 中断线程 t
t.interrupt();
} catch (InterruptedExceptione) {
e.printStackTrace();
}
}
@Override
publicvoidrun() {
super.run();
// 循环打印 i 的值,从 0 到 200000
for(inti=0; i<=200000; i++) {
System.out.println("i="+i);
}
}
}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
从输出的结果我们会发现 interrupt 方法并没有停止线程 t 中的处理逻辑,也就是说即使 t 线程被设置为 了中断状态,但是这个中断并不会起作用,那么该如何停止线程呢? 这就需要使用到另外两个与线程中断有关的方法了: 这两个方法使得当前线程能够感知到是否被中断了(通过检查标志位)。 所以如果希望线程 t 在中断后停止,就必须先判断是否被中断,并为它增加相应的中断处理代码: 在上面这段代码中,我们增加了 Thread.isInterrupted() 来判断当前线程是否被中断了,如果是,则退 出 for 循环,结束线程。 这种方式看起来与之前介绍的“使用标志位中止线程”非常类似,但是在遇到 sleep() 或者 wait() 这样的 操作,我们只能通过中断来处理了。
public static native void sleep(long millis) throws InterruptedExceptionThread.sleep() 方法会抛出一个 InterruptedException 异常,当线程被 sleep() 休眠时,如果被中断, 这会就抛出这个异常。 (注意:Thread.sleep() 方法由于中断而抛出的异常,是会清除中断标记的。)
140. 谈谈对线程安全的理解
1)、线程安全的核心定义
线程安全是指:当多个线程并发访问同一个共享资源(对象、变量、数据结构等)时,无论这些线程的
执行顺序如何(串行 / 交替)、是否被操作系统调度中断,都能保证该资源的逻辑状态符合预期,程序
最终的执行结果与单线程执行结果完全一致,且不会出现数据错乱、逻辑异常、死锁等问题。
i=199993
i=199994
i=199995
i=199996
i=199997
i=199998
i=199999
i=200000
1
2
3
4
5
6
7
8
publicbooleanThread.isInterrupted() //判断是否被中断
publicstaticbooleanThread.interrupted() //判断是否被中断,并清除当前中断状态
1
2
@Override
publicvoidrun() {
super.run();
for(inti=0; i<=200000; i++) {
//判断是否被中断
if(Thread.currentThread().isInterrupted()){
//处理中断逻辑
break;
}
System.out.println("i="+i);
}
}
1
2
3
4
5
6
7
8
9
10
11
12
手段
核心原理
适用场景
加锁 (synchronized/Lock) 保证同一时间只有一个线程执 行临界区代码 所有需要原子操作的场景(比如 计数、转账) 原子类(AtomicInteger) 基于 CAS(无锁机制)保证操 作原子性 简单变量的原子操作(替代
count++ )不可变对象 (String/Integer) 对象创建后属性不可修改 只读共享数据 线程本地存储 (ThreadLocal) 为每个线程创建私有副本 避免共享(比如用户上下文、数 据库连接) 并发容器 (ConcurrentHashMap) 分段锁 / 无锁机制保证安全 多线程操作集合 简单来说:多线程操作共享数据时,结果 “不出错”,就是线程安全;反之(比如计数不准、集合遍历异 常、数据覆盖),就是线程不安全。
2)、线程安全问题的根本原因
线程安全问题的产生,是 “三个条件同时满足” 的结果:
- 共享资源:多个线程访问同一个可变的共享数据(比如堆中的对象属性、静态变量、共享集合) —— 栈因线程私有,局部变量(未暴露给其他线程)天然线程安全;
- 并发操作:多个线程对共享资源的操作是 “同时进行” 的(CPU 时间片切换导致线程交替执行);
- 非原子操作:对共享资源的操作不是 “不可分割” 的(比如count++ 实际是 “读→改→写” 三步操 作,中间可能被其他线程打断)。
3)、常见场景
141. (1). 天然线程安全的场景
无共享资源:每个线程操作自己的私有数据(比如栈内的局部变量); 只读共享资源:多个线程仅读取共享数据,不修改(比如常量、不可变对象String ); 单线程环境:程序只有一个线程,无并发操作。
(2). 典型的线程不安全场景
多线程修改基础类型变量:比如int count = 0 ,多线程执行count++ ; 多线程操作非线程安全集合:比如ArrayList 、HashMap 被多线程添加 / 删除元素(会出现
ConcurrentModificationException 或数据丢失);多线程修改对象属性:比如共享的User 对象,多个线程同时修改age 属性。
4). 实现线程安全的常用手段
142. synchronized的实现原理
synchronized是Java语言中最基本的线程同步机制,它通过互斥锁来控制线程对共享变量的访问。
具体实现原理如下:
- synchronized的实现基础是对象内部的锁(也称为监视器锁或管程),每个锁关联着一个对象实 例。
- 当synchronized作用于某个对象时,它就会尝试获取这个对象的锁,如果锁没有被其他线程占用, 则当前线程获取到锁,并可以执行同步代码块;如果锁已经被其他线程占用,那么当前线程就会阻 塞在同步块之外,直到获取到锁才能进入同步块。
- synchronized还支持作用于类上,此时它锁住的是整个类,而不是类的某个实例。在这种情况下, 由于只有一个锁存在,所以所有使用该类的线程都需要等待锁的释放。
- 在JVM内部,每个Java对象都有头信息,其中包含了对象的一些元信息和状态标志。synchronized 通过修改头信息的状态标志来实现锁的获取和释放。
- synchronized还支持可重入性,即在同一个线程中可以多次获取同一个锁,这样可以避免死锁问 题。
- Java虚拟机会通过锁升级的方式来提升synchronized的效率,比如偏向锁、轻量级锁和重量级锁等 机制,使得在竞争不激烈的情况下,synchronized的性能可以达到与非同步代码相当的水平。
143. 多线程的生命周期的六种状态
源码中一共定义了6钟状态。 (1)新建(NEW):线程对象刚给创建,但未启动(start)
例子(example):
(2)可运行(RUNNABLE):线程已被启动,可以被调度或正在被调度。
例子(example):
packagese.thread.life;
publicclassThread_New {
publicstaticvoidmain(String[] args) {
Threadthread=newThread();// 只要线程new出来
System.out.println("线程的名字"+thread.getName()+"线程的状
态:"+thread.getState());
}
}
1
2
3
4
5
6
7
8
9
10
11
packagese.thread.life;
1
(3)锁阻塞(BLOCKED):当前线程要获取的锁对象正被其他线程占用,此时该线程处于Blocked状 态。
例子(example):
publicclassThread_Runnable {
publicstaticvoidmain(String[] args) {
Threadthread=newThread(()->{
System.out.println("1111");
System.out.println("线程的状
态"+Thread.currentThread().getState());
});
thread.start();
System.out.println("线程的状态"+thread.getState());
}
}
2
3
4
5
6
7
8
9
10
11
12
13
14
packagese.thread.life;
publicclassThread_Blocked {
publicstaticvoidmain(String[] args) {
Objecto=newObject();
ThreadthreadA=newThread(()->{
synchronized (o){
System.out.println("11111");
try {
Thread.sleep(1000);
} catch (InterruptedExceptione) {
e.printStackTrace();
}
}
},"A");
threadA.start();
try {
Thread.sleep(500);
} catch (InterruptedExceptione) {
e.printStackTrace();
}
ThreadthreadB=newThread(()->{
synchronized (o){
}
},"B");
threadB.start();
try {
Thread.sleep(100);
} catch (InterruptedExceptione) {
e.printStackTrace();
}
System.out.println("线程"+threadB.getName()+"状
态"+threadB.getState());
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
(4)等待阻塞(WAITING):当前线程遇到了wait(),join()等方法。
例子(example):
}
}
37
38
39
40
packagese.thread.life;
publicclassThread_Waiting {
// 使用wait、notify或者notifyAll的时候必须要要结合synchronized使用
publicstaticvoidmain(String[] args) throwsInterruptedException {
Objecto=newObject();
Threadthread=newThread(() -> {
synchronized (o) {
try {
for (inti=1; i<10 ; i++) {
System.out.println("i---"+i);
if(i==5){
//使用对象的wait方法时须有一个对象和synchronized
o.wait();
//如若不结合synchronized  那么就会出现一个监视器对象
//状态异常IllegalMonitorStateException。任何一个
//对象中都有一个ObjectMonitor对象。监视器锁。管程技术。
}
}
} catch (InterruptedExceptione) {
e.printStackTrace();
}
}
});
thread.start();
Thread.sleep(2000);
System.out.println(thread.getState());
Threadthread1=newThread(()->{
//  o.notify();//使用notify或者notifyAll()都要结合synchronized使用,
// 不然就会出现监视器异常IllegalMonitorStateException
synchronized (o){
System.out.println("do some thing");
o.notify();
}
});
thread1.start();
System.out.println("end");
}
}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
(5)限时等待(TIMED_WAITING):当前线程调用了sleep(时间),wait(时间),join(时间)等方法。
例子(example):
(6)终止(TERMINATED):线程正常结束或异常提前退出。
例子(example):
备注:没有Running状态,只有Runnable状态。Runnable包括两种情况:Ready就绪+Running正在运 行。
packagese.thread.life;
publicclassThread_TimeWaiting {
publicstaticvoidmain(String[] args) throwsInterruptedException {
Objecto=newObject();
Threadthread=newThread(()->{
synchronized (o){
try {
// 线程调用wait(5000)方法
o.wait(5000);
} catch (InterruptedExceptione) {
e.printStackTrace();
}
}
});
thread.start();
// 线程调用sleep(5000)方法
Thread.sleep(5000);
// 线程调用join(5000)方法
thread.join(5000);
System.out.println(thread.getState());
}
}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
packagese.thread.life;
publicclassThread_Terminated {
publicstaticvoidmain(String[] args) throwsInterruptedException {
Threadthread=newThread(() -> {
inti=0;
System.out.println("1111");
try {
i=10/0;
} catch (Exceptione) {
e.printStackTrace();
}
System.out.println(i);
});
thread.start();
Thread.sleep(100);
System.out.println(thread.getState());
}
}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
状态
触发条件
含义与特征
NEW new Thread() 后,未调用 start() 初始状态,线程已创建但未启动 RUNNABLE 调用 start() 后(包含就绪 Ready 和运行中 Running 两种 子状态) 可执行状态: - 可能正在运行 - 或在等待 CPU/OS 资源(如 I/O)(⚠ 注意:等
待键盘输入时也显示此状态)
BLOCKED 线程竞争 synchronized 锁失败 锁阻塞: - 在对象的 Entry Set(锁池) 中等待 - 只有 synchronized 锁会触发此 状态 WAITING 调用无超时的阻塞方法: object.wait() thread.join() LockSupport.park() 无限期等待: - 在对象的 Wait Set 中休 眠 - 需外部事件唤醒(如 notify()) TIMED_WAITING 调用带超时的阻塞方法:
Thread.sleep(n)
object.wait(timeout)
thread.join(timeout)
有限期等待: - 在 OS 计时器或对象 Wait Set 中 - 超时或中断可唤醒 TERMINATED 线程执行完毕或异常终止 最终状态: - 不可重启 - 资源未立即释放 (可被 GC 回收)
144. 多线程的生命周期
备注:
BLocked的状态一定是和锁(synchronized而不是Lock,Lock的底层是AQS,不是monitor)有关 的,拿不到锁进入BLOCKED状态,所以sleep、join、等待键盘输入都不会进入BLocked 被notfiy()、notifyAll()唤醒后进入BLOCKED状态,等待获取锁。被signal()、signalAll()唤醒后进
入RUNNABLE状态,这是因为AQS的实现机制,和synchronized机制不同(后续JUC说明)。
特性
sleep()
wait()
所属类 Thread 类的静态方法 Object 类的方法 锁的释放 不释放任何锁(包括同步 锁) 释放目标对象的同步锁 唤醒条件 超时结束或被中断 (InterruptedException) 被其他线程调用 notify()/notifyAll() 或超时结束 或被中断 调用位置 任何地方 必须在同步块或同步方法内(持有锁时) 用途 单纯的暂停线程执行(定 时、延迟) 线程间协调、等待条件满足 重获锁 醒来后直接继续执行(原 本就没释放锁) 醒来后需要重新竞争获取对象锁才能继续执行 执行该方法后进 入什么状态 TIMED_WAITING (可不 是阻塞blocked) WAITING,TIMED_WAITING,(和sleep的线程 状态一样,可不在一个队列) 被唤醒后进入什 么状态 Runnable状态 Blocked状态(因为还要先拿到锁),拿到了锁 进Runnable状态
145. sleep()、wait()的区别
146. 锁池
所有需要竞争同步锁(synchronized)的线程都会放在锁池当中,比如当前对象的锁已经被其中一个线 程得到,则其他线程需要在这个锁池进行等待,当前面的线程释放同步锁后锁池中的线程去竞争同步 锁,当某个线程得到后会进入就绪队列进行等待cpu资源分配。
147. 等待池
当我们调用wait()方法后,线程会放到等待池当中,等待池的线程是不会去竞争同步锁。只有调用了 notify()或notifyAll()后等待池的线程才会开始去竞争锁,notify()是随机从等待池选出一个线程放 到锁池,而notifyAll()是将等待池的所有线程放到锁池当中。 1、sleep 是 Thread 类的静态本地方法,wait 则是 Object 类的本地方法。 2、sleep方法不会释放lock,但是wait会释放,而且会加入到等待队列中。 3、sleep方法不依赖于同步器synchronized,但是wait需要依赖synchronized关键字。 4、sleep不需要被唤醒(休眠之后推出阻塞),但是wait需要(不指定时间需要被别人中断)。 5、sleep 一般用于当前线程休眠,或者轮循暂停操作,wait 则多用于多线程之间的通信。 6、sleep 会让出 CPU 执行时间且强制上下文切换,而 wait 则不一定,wait 后可能还是有机会重新竞争 到锁继续执行的。 备注:共同点:都会释放CPU;最大不同点:wait让出cpu的同时会释放锁,sleep让出cpu的同时不会 是否释放锁
148. notify()和 notifyAll()有什么区别
在Java中,notify()和notifyAll()都属于Object类的方法,用于实现线程间的通信。 notify()方法用于唤醒在当前对象上等待的单个线程。如果有多个线程同时在某个对象上等待(通过调 用该对象的wait()方法),则只会唤醒其中一个线程,并使其从等待状态变为阻塞态再变为可运行状态。 具体是哪个线程被唤醒是不确定的,取决于线程调度器的实现。 notifyAll()方法用于唤醒在当前对象上等待的所有线程。如果有多个线程在某个对象上等待,调用 notifyAll()方法后,所有等待的线程都会被唤醒并竞争该对象的锁。其中一个线程获得锁后继续执行,其 他线程则继续等待。 需要注意的是,notify()和notifyAll()方法只能在同步代码块或同步方法内部调用,并且必须拥有与该对 象关联的锁。否则会抛出IllegalMonitorStateException异常。
149. 并发的三大特征
原子性:
原子性是指在一个操作中cpu不可以在中途暂停然后再调度,即不被中断操作,要么全部执行完成,要 么都不执行。就好比转账,从账户A向账户B转1000元,那么必然包括2个操作:从账户A减去1000元, 往账户B加上1000元。2个操作必须全部完成。 1:将 count 从主存读到工作内存中的副本中 2:+1的运算 3:将结果写入工作内存 4:将工作内存的值刷回主存(什么时候刷入由操作系统决定,不确定的) 那程序中原子性指的是最小的操作单元,比如自增操作,它本身其实并不是原子性操作,分了3步的,包 括读取变量的原始值、进行加1操作、写入工作内存。所以在多线程中,有可能一个线程还没自增完,可 能才执行到第二部,另一个线程就已经读取了值,导致结果错误。那如果我们能保证自增操作是一个原 子性的操作,那么就能保证其他线程读取到的一定是自增后的数据。
关键字:synchronized
可见性
当多个线程访问同一个变量时,一个线程修改了这个变量的值,其他线程能够立即看得到修改的值。若 两个线程在不同的cpu,那么线程1改变了i的值还没刷新到主存,线程2又使用了i,那么这个i值肯定还是 之前的,线程1对变量的修改线程2没看到这就是可见性问题。 如果线程2改变了stop的值,线程1一定会停止吗?不一定。当线程2更改了stop变量的值之后,但是还 没来得及写入主存当中,线程2转去做其他事情了,那么线程1由于不知道线程2对stop变量的更改,因 此还会一直循环下去。 关键字:volatile、synchronized、final
有序性
privatelongcount=0;
publicvoidcalc() {
count++;
}
1
2
3
4
//线程1
booleanstop=false;
while(!stop){
doSomething();
}
//线程2
stop=true;
1
2
3
4
5
6
7
虚拟机在进行代码编译时,对于那些改变顺序之后不会对最终结果造成影响的代码,虚拟机不一定会按 照我们写的代码的顺序来执行,有可能将他们重排序。实际上,对于有些代码进行重排序之后,虽然对 变量的值没有造成影响,但有可能会出现线程安全问题。 write方法里的1和2做了重排序,线程1先对flag赋值为true,随后执行到线程2,ret直接计算出结果,再 到线程1,这时候a才赋值为2,很明显迟了一步。
关键字:volatile、synchronized
volatile本身就包含了禁止指令重排序的语义,而synchronized关键字是由“一个变量在同一时刻只允许 一条线程对其进行lock操作”这条规则明确的。
synchronized关键字同时满足以上三种特性,但是volatile关键字不满足原子性。
在某些情况下,volatile的同步机制的性能确实要优于锁(使用synchronized关键字或 java.util.concurrent包里面的锁),因为volatile的总开销要比锁低。 我们判断使用volatile还是加锁的唯一依据就是volatile的语义能否满足使用的场景(原子性)
150. JMM内存模型
Java内存模型(Java Memory Model简称JMM)是一种抽象的概念,并不真实存在,它描述的是一组规则 或规范,通过这组规范定义了程序中各个变量(包括实例字段,静态字段)的访问方式。JVM运行程序 的实体是线程,而每个线程创建时JVM都会为其创建一个工作内存(有些地方称为栈空间),用于存储线程 私有的数据,而Java内存模型中规定所有变量都存储在主内存,主内存是共享内存区域,所有线程都可 以访问,但线程对变量的操作(读取赋值等)必须在工作内存中进行,首先要将变量从主内存拷贝的自己 的工作内存中,然后对变量进行操作,操作完成后再将变量写回主内存,不能直接操作主内存中的变 量,工作内存中存储着主内存中的变量副本拷贝,前面说过,工作内存是每个线程的私有数据区域,因 此不同的线程间无法访问对方的工作内存,线程间的通信(传值)必须通过主内存来完成。 JMM规定了内存主要划分为主内存和工作内存两种。 主内存:主要存储的是Java实例对象,所有线程创建的实例对象都存放在主内存中,当然也包括了共享 的类信息、常量、静态变量。由于是共享数据区域,多条线程对同一个变量进行访问可能会发生线程安 全问题。 共享变量:如果一个变量被多个线程使用,那么这个变量会在每个线程的工作内存中保有一个副本,这 种变量就是共享变量。 工作内存:主要存储当前方法的所有本地变量信息(工作内存中存储着主内存中的变量副本拷贝),每个 线程只能访问自己的工作内存,即线程中的本地变量对其它线程是不可见的,就算是两个线程执行的是 同一段代码,它们也会各自在自己的工作内存中创建属于当前线程的本地变量,当然也包括了字节码行 号指示器、相关Native方法的信息。注意由于工作内存是每个线程的私有数据,线程间无法相互访问工 作内存,因此存储在工作内存的数据不存在线程安全问题。
inta=0;
boolflag=false;
publicvoidwrite() {
a=2; //1
flag=true; //2
}
publicvoidmultiply() {
if (flag) { //3
intret=a*a;//4
}
}
1
2
3
4
5
6
7
8
9
10
11
模型入下图:(基于JMM规范)
151. JMM存在的必要性
由于JVM运行程序的实体是线程,而每个线程创建时JVM都会为其创建一个工作内存(有些地方称为栈空 间),用于存储线程私有的数据,线程与主内存中的变量操作须通过工作内存间接完成,主要过程是将变 量从主内存拷贝的每个线程各自的工作内存空间,然后对变量进行操作,操作完成后再将变量写回主内 存,那么如存在两个线程同时对一个主内存中的实例对象的变量进行操作就有可能诱发线程安全问题。 假设主内存中存在一个共享变量x(初始值为1),现在有A和B两条线程分别对该变量x=1进行操作, A/B线程各自的工作内存中存在共享变量副本x。假设现在A线程想要修改x的值为2,而B线程却想要读取 x的值,那么B线程读取到的值是A线程更新后的值2还是更新前的值1呢?答案是,不确定。 即B线程有可能读取到A线程更新前的值1,也有可能读取到A线程更新后的值2,这是因为工作内存是每 个线程私有的数据区域,而线程A操作变量x时(即将x=1拷贝到自己的工作内存中),首先是将变量从 主内存拷贝到A线程的工作内存中,然后对变量进行操作,操作完成后再将变量x写回主内存,而对于B 线程的也是类似的,这样就有可能造成主内存与工作内存间数据存在一致性问题,假如A线程修改完后 正在将数据写回主内存,而B线程此时正在读取主内存,这样B线程读取到的值就是x=1,但如果A线程 已将x=2写回主内存后,B线程才开始读取的话,那么此时B线程读取到的就是x=2。 注意:
**JMM**不同于**JVM内存区域模型**JMM与JVM内存区域的划分是不同的概念层次,更恰当说JMM描述的是一组规则, 通过这组规则控制程序中各个变量在共享数据区域和私有数据区域的访问方式,JMM是围绕原子性,有序 性、可见性展开。 JMM与Java内存区域唯一相似点,都存在共享数据区域和私有数据区域,在JMM中主内存属于共享数据区 域, 从某个程度上讲应该包括了堆和方法区,而工作内存数据线程私有数据区域,从某个程度上讲则应该包括 程序计数器、虚拟机栈以及本地方法栈。
1
2
3
4
5
6
7
JMM对共享内存的操作做出了如下两条规定:
- 线程对共享内存的所有操作都必须在自己的工作内存中进行,不能直接从主内存中写;
- 不同线程无法直接访问其他线程工作内存中的变量,因此共享变量的值传递需要通过主内存完成。
1
2
3
152. 谈谈Volatile关键字的理解
1)、验证可见性
2)、验证有序性
publicclassVolatileDemo {
staticintflag=1;
//static  volatile Integer int flag = 1;
publicstaticvoidmain(String[] args) {
newThread(newRunnable() {
@Override
publicvoidrun() {
System.out.println("我是子线程A工作内存flag的值:"+flag);
while (flag==1) {
}
System.out.println("子线程结束:"+flag);
}
}, "A").start();
try {
Thread.sleep(1000);//让线程完全启动
} catch (InterruptedExceptione) {
e.printStackTrace();
}
flag=2;
System.out.println("我是主线程工作内存flag的值:"+flag);
}
}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
publicclassVolatileOrderDemo {
staticintx, y;
staticinta, b;
//static int x, y;
//static volatile int a, b;
publicstaticvoidmain(String[] args) throwsInterruptedException {
inti=0;
while (true) {
i++;
a=b=x=y=0;
Threadthread1=newThread(() -> {
a=1;
x=b;
});
Threadthread2=newThread(() -> {
b=1;
y=a;
});
thread1.start();
thread2.start();
Thread.sleep(10);
thread1.join();
thread2.join();
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
3)、不具备原子性
153. Atomic原子类了解多少?原理是什么?
Java中的java.util.concurrent.atomic包提供了一组原子类,用于在多线程环境中执行原子操作,而无需 使用显式的锁。这些原子类使用特殊的CPU指令来确保操作的原子性,从而避免了使用锁带来的性能开 销。 这些原子类的实现依赖于底层硬件架构提供的原子操作指令。通常,这些指令在现代处理器上是硬件级 别的支持,确保对内存的读写是原子的。这使得在不使用锁的情况下,可以在多线程环境中执行某些操 作,而不会导致竞态条件(race conditions)。 以下是一些常见的java.util.concurrent.atomic包中的原子类以及它们的一些实现原理: AtomicInteger, AtomicLong, AtomicReference: 这些类使用compareAndSet(CAS)操作实现原子性。CAS是一种乐观锁定机制,它尝试原子地将 一个值更新为新值,但只有在当前值等于预期值时才成功。否则,它会重新尝试。 CAS操作是由处理器提供的原子性操作指令支持的。 AtomicBoolean: AtomicBoolean类使用compareAndSet实现。 compareAndSet的实现通常依赖于底层处理器的CAS指令。 AtomicIntegerArray, AtomicLongArray, AtomicReferenceArray: 这些类提供了对数组元素的原子性访问。 它们也使用CAS操作,但应用于数组的特定位置。
System.out.println("第"+i+"次打印:x="+x+",y="+y);
if (x==0&&y==0) {
break;
}
}
}
}
26
27
28
29
30
31
32
33
classMyAtomic {
privateIntegernumber=0;
publicintincr() {
returnnumber++;
}
}
publicclassVolatileAtomicDemo {
publicstaticvoidmain(String[] args) {
MyAtomicmyAtomic=newMyAtomic();
for (inti=0; i<1000 ; i++) {
newThread(()->{
System.out.println(myAtomic.incr());
}).start();
}
}
}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
AtomicIntegerFieldUpdater, AtomicLongFieldUpdater, AtomicReferenceFieldUpdater: 这些类提供了对对象字段的原子性更新。 它们使用了反射和CAS操作来实现。 总体来说,原子类的实现依赖于底层硬件提供的原子性操作指令,这通常是现代处理器架构的一部分。 这使得原子类能够在无锁的情况下执行一些基本的原子操作,提高了多线程环境中的性能。在高并发的 情况下,原子类是一种有用的工具,能够提供线程安全的操作,而无需显式地使用锁。
154. synchronized底层实现是什么?lock底层是什么?有
什么区别?
1) Synchronized原理:
方法级的同步是隐式,即无需通过字节码指令来控制的,它实现在方法调用和返回操作之中。JVM可以 从方法常量池中的方法表结构(method_info Structure) 中的 ACC_SYNCHRONIZED 访问标志区分一个 方法是否同步方法。当方法调用时,调用指令将会检查方法的 ACC_SYNCHRONIZED 访问标志是否被 设置,如果设置了,执行线程将先持有monitor(虚拟机规范中用的是管程一词),然后再执行方法, 最后再方法完成(无论是正常完成还是非正常完成)时释放monitor。 代码块的同步是利用monitorenter和monitorexit这两个字节码指令。分别位于同步代码块的开始和结 束位置。当jvm执行到monitorenter指令时,当前线程试图获取monitor对象所有权,如果未加锁或者 已被当前线程所持有,就把锁的计数器+1;当执行monitorexit指令时,锁计数器-1;当锁计数器为0 时,该锁就被释放了。如果获取monitor对象失败,该线程则会进入阻塞状态,直到其他线程释放锁。
2) Lock原理:
· Lock的存储结构:一个int类型状态值(用于锁的状态变更),一个双向链表(用于存储等待中的线 程) · Lock获取锁的过程:本质上是通过CAS来获取状态值修改,如果当场没获取到,会将该线程放在线程等 待链表中。 · Lock释放锁的过程:修改状态值,调整等待链表。 · Lock大量使用CAS+自旋。因此根据CAS特性,lock建议使用在低锁冲突的情况下。
3) Lock与synchronized的区别
- Lock的加锁和解锁都是由java代码配合native方法(调用操作系统的相关方法)实现的,而 synchronized的加锁和解锁的过程是由JVM管理的
- 当一个线程使用synchronized获取锁时,若锁被其他线程占用着,那么当前只能被阻塞,直到成功 获取锁。而Lock则提供超时锁和可中断等更加灵活的方式,在未能获取锁的条件下提供一种退出 的机制。
- 一个锁内部可以有多个Condition实例,即有多路条件队列,而synchronized只有一路条件队列; 同样Condition也提供灵活的阻塞方式,在未获得通知之前可以通过中断线程以及设置等待时限等 方式退出条件队列。
- synchronized对线程的同步仅提供独占模式,而Lock即可以提供独占模式,也可以提供共享模式
synchronized
Lock
关键字 接口/类 自动加锁和释放锁 需要手动调用unlock() 方法释放锁 JVM层面的锁 API层面的锁 非公平锁 可以选择公平或者非公平锁 锁是一个对象,并且锁的信息保存在了对象中 代码中通过int类型的state标识 有一个锁升级的过程 无
155. synchronized锁优化
synchronized还有一种重要的优化方式,即锁的优化技术。在Java 6及以上版本中,JVM引入了偏向 锁、轻量级锁和重量级锁的概念来提高锁的性能。这些优化方式的原理如下: 偏向锁:偏向锁是指当一个线程获取到锁之后,会在对象头中记录下该线程的标识,下次再进入同 步块时,无需进行额外的加锁操作,从而提高性能。 轻量级锁:当多个线程对同一个锁进行争夺时,JVM会使用轻量级锁来避免传统的重量级锁带来的 性能消耗。它采用自旋的方式,即不放弃CPU的执行时间,尝试快速获取锁,避免线程阻塞和上下 文切换的开销。 重量级锁:当多个线程对同一个锁进行强烈争夺时,JVM会升级为重量级锁,此时线程会进入阻塞 状态,等待锁的释放。这种方式适用于竞争激烈的情况,但会带来较大的性能开销。 锁优化技术是为了提高synchronized的并发性能,根据锁的竞争程度和持有时间的长短选择相应的锁状 态,使得多个线程能够更高效地共享资源。 如何区分:不同类型锁,通过synchronized(obj)中的锁对象obj的markword中的锁标志位来区分 备注:64位的markword启用了压缩选项后会压缩为32位:
查看对象头数据
添加依赖
<dependency>
<groupId>org.openjdk.jol</groupId>
<artifactId>jol-core</artifactId>
<version>0.10</version>
</dependency>
1
2
3
4
5
测试并运行
如何升级
备注:锁只能升级,不能降级;以上的操作仅限于>=JDK6 的synchronized,和Lock锁无关。
156. 如何实现线程的同步
线程的同步是为了保证多个线程按照特定的顺序、协调地访问共享资源,避免数据不一致和竞争条件等 问题。 在Java中,常见的线程同步方式有以下几种:
- 使用synchronized关键字:通过在方法或代码块前加上synchronized关键字,确保同一时间只有 一个线程可以执行标记为同步的代码。这样可以避免多个线程同时访问共享资源造成的数据不一致 问题。
- 使用ReentrantLock类:它是一个可重入锁,通过调用lock()和unlock()方法获取和释放锁。与 synchronized不同,ReentrantLock提供了更灵活的同步控制,例如可实现公平性和试锁等待时 间。
- 使用wait()、notify()和notifyAll()方法:这些方法是Object类的方法,允许线程间进行协作和通 信。通过调用wait()方法使线程进入等待状态,然后其他线程可以通过notify()或notifyAll()方法唤醒 等待的线程。
- 使用CountDownLatch和CyclicBarrier:它们是并发工具类,用于线程之间的同步和等待。 CountDownLatch可用于等待一组线程完成操作,而CyclicBarrier用于等待一组线程互相达到屏障 位置。 选择适合的同步方式会根据具体需求和场景而定。在使用任何同步机制时,需要注意避免死锁和性能问 题,合理设计同步范围和粒度。
publicclassTest {
publicstaticvoidmain(String[] args) {
Objectlock=newObject();
System.out.println("=== 无锁状态 ===");
System.out.println(ClassLayout.parseInstance(lock).toPrintable());
// 第一个线程获取锁(触发偏向锁)
synchronized (lock) {
System.out.println("\n=== 偏向锁状态(JDK15之后是轻量级锁) ===");
System.out.println(ClassLayout.parseInstance(lock).toPrintable());
}
}
}
1
2
3
4
5
6
7
8
9
10
11
12
157. 认识Executor线程池
什么是线程池:
创建和销毁对象是非常耗费时间的。思路:事先new创建好多个线程,放入线程池中,使用时直接 获取引用,不使用时放回池中。 生活案例:共享单车 JDK1.5起,提供了内置了Executor线程池
线程池的好处
提高响应速度(减少了创建新线程的时间) 降低资源消耗(重复利用线程池中线程,不需要每次都创建) 提高线程的可管理性:避免线程无限制创建
线程池的应用场合
需要大量线程,并且完成任务的时间短 对性能要求苛刻 接受突发性的大量请求
158. Executors提供的线程池类型
在 JDK 的 java.util.concurrent.Executors 中提供了生成多种线程池的静态方法。 ExecutorService newCachedThreadPool = Executors.newCachedThreadPool(); ExecutorService newFixedThreadPool = Executors.newFixedThreadPool(4); ScheduledExecutorService newScheduledThreadPool = Executors.newScheduledThreadPool(4); ExecutorService newSingleThreadExecutor = Executors.newSingleThreadExecutor(); 然后调用他们的 execute 方法即可。
(1)newCachedThreadPool
创建一个可缓存线程池,如果线程池长度超过处理需要,可灵活回收空闲线程,若无可回收,则新建线 程。这种类型的线程池特点是: 工作线程的创建数量几乎没有限制(其实也有限制的,数目为Interger. MAX_VALUE), 这样可灵活的往线程 池中添加线程。 如果长时间没有往线程池中提交任务,即如果工作线程空闲了指定的时间(默认为1分钟),则该工作线程 将自动终止。终止后,如果你又提交了新的任务,则线程池重新创建一个工作线程。 在使用CachedThreadPool时,一定要注意控制任务的数量,否则,由于大量线程同时运行,很有会造 成系统瘫痪。
(2)newFixedThreadPool
创建一个指定工作线程数量的线程池。每当提交一个任务就创建一个工作线程,如果工作线程数量达到 线程池初始的最大数,则将提交的任务存入到池队列中。FixedThreadPool是一个典型且优秀的线程 池,它具有线程池提高程序效率和节省创建线程时所耗的开销的优点。但是,在线程池空闲时,即线程 池中没有可运行任务时,它不会释放工作线程,还会占用一定的系统资源。
(3)newSingleThreadExecutor
创建一个单线程化的Executor,即只创建唯一的工作者线程来执行任务,它只会用唯一的工作线程来执 行任务,保证所有任务按照指定顺序(FIFO, LIFO, 优先级)执行。如果这个线程异常结束,会有另一个取 代它,保证顺序执行。单工作线程最大的特点是可保证顺序地执行各个任务,并且在任意给定的时间不 会有多个线程是活动的。
(4)newScheduleThreadPool
创建一个定长的线程池,而且支持定时的以及周期性的任务执行。例如延迟3秒执行。 这4种线程池底层全部是ThreadPoolExecutor对象的实现,阿里规范手册中规定线程池采用 ThreadPoolExecutor自定义的,实际开发也是。
159. Executor线程池的API
Executor接口是顶层接口,只有一个execute方法
ExecutorService:真正的线程池接口
void execute(Runnable cmd) :执行任务/命令,没有返回值,一般用来执行Runnable Future submit(Callable task):执行任务,有返回值,一般用来执行Callable void shutdown() :关闭线程池。不接收新任务,但是已经提交的任务会执行完。 List shutdownNow()。立刻关闭线程池。不会接收新任务,并用interrupt的方式中断正在执行的 任务;会将队列中的任务返回。
AbstractExecutorService:基本实现了ExecutorService的所有方法
ThreadPoolExecutor:默认的线程池实现类
ScheduledThreadPoolExecutor:实现周期性任务调度的线程池
Executors:工具类、线程池的工厂类,用于创建并返回不同类型的线程池
160. ThreadPoolExecutor对象的七个参数及其作用?
参数与作用:共7个参数
- corePoolSize:核心线程数,在ThreadPoolExecutor中有一个与它相关的配置: allowCoreThreadTimeOut(默认为false),当allowCoreThreadTimeOut为false时,核心线程 会一直存活,哪怕是一直空闲着。而当allowCoreThreadTimeOut为true时核心线程空闲时间超过 keepAliveTime时会被回收。
- maximumPoolSize:最大线程数,线程池能容纳的最大线程数,当线程池中的线程达到最大时, 此时添加任务将会采用拒绝策略,默认的拒绝策略是抛出一个运行时错误 (RejectedExecutionException)。值得一提的是,当初始化时用的工作队列为 LinkedBlockingDeque时,这个值将无效。
- keepAliveTime:存活时间,当非核心空闲超过这个时间将被回收,同时空闲核心线程是否回收 受allowCoreThreadTimeOut影响。
- unit:keepAliveTime的单位。
- workQueue:任务队列,常用有三种队列,即SynchronousQueue,LinkedBlockingQueue(无 界队列),ArrayBlockingQueue(有界队列)。
- threadFactory:线程工厂,ThreadFactory是一个接口,用来创建worker。通过线程工厂可以对 线程的一些属性进行定制。默认直接新建线程。
- RejectedExecutionHandler:拒绝策略,也是一个接口,只有一个方法,当线程池中的资源已经 全部使用,添加新线程被拒绝时,会调用RejectedExecutionHandler的rejectedExecution法。默 认是抛出一个运行时异常。
161. Executor线程池拒绝策略
ThreadPoolExecutor自带的拒绝策略如下: 1、AbortPolicy 直接抛出异常,默认策略; 2、CallerRunsPolicy 用调用者所在的线程来执行任务; 3、DiscardOldestPolicy 丢弃阻塞队列中靠最前的任务,并执行当前任务; 4、DiscardPolicy 直接丢弃任务; 当然也可以根据应用场景实现 RejectedExecutionHandler 接口,自定义饱和策略,如记录日志或持久 化存储不能处理的任务。
162. Executor线程池的工作原理
- 在创建了线程池后,线程池中的线程数为零。
- 当调用execute()方法添加一个请求任务时,线程池会做出如下判断:
- 如果正在运行的线程数量小于corePoolSize,那么马上创建线程运行这个任务;
- 如果正在运行的线程数量大于或等于corePoolSize,那么将这个任务放入队列;
- 如果这个时候队列满了且正在运行的线程数量还小于maximumPoolSize,那么还是要创建 非核心线程立刻运行这个任务;
- 如果队列满了且正在运行的线程数量大于或等于maximumPoolSize,那么线程池会启动默 认的拒绝策略来执行。
- 当一个线程完成任务时,它会从队列中取下一个任务来执行。
- 当一个线程无事可做超过一定的时间(keepAliveTime)时,线程会判断: 如果当前运行的线程数大于corePoolSize,那么这个线程就被停掉。 所以线程池的所有任务完成后,它最终会收缩到corePoolSize的大小。
注意:提交一个Runnable时,不管当前线程池中的线程是否空闲,只要数量小于核心线程数就会
创建新线程。
注意:ThreadPoolExecutor相当于是非公平的,比如队列满了之后提交的Runnable可能会比正
在排队的Runnable先执行。
163. 线程池的五种状态是如何流转的
线程池有五种状态: RUNNING:会接收新任务并且会处理队列中的任务 SHUTDOWN:不会接收新任务并且会处理队列中的任务 STOP:不会接收新任务并且不会处理队列中的任务,并且会中断在处理的任务。 TIDYING:所有任务都终止了,线程池中也没有线程了,这样线程池的状态就会转为TIDYING,一 旦达到此状态,就会调用线程池的terminated() TERMINATED:terminated()执行完之后就会转变为TERMINATED 这五种状态并不能任意转换,只会有以下几种转换情况:
- RUNNING -> SHUTDOWN:手动调用shutdown()触发,或者线程池对象GC时会调用finalize()从而 调用shutdown()
- (RUNNING or SHUTDOWN) -> STOP:调用shutdownNow()触发,如果先调shutdown()紧着调 shutdownNow(),就会发生SHUTDOWN -> STOP
- SHUTDOWN -> TIDYING:队列为空并且线程池中没有线程时自动转换
- STOP -> TIDYING:线程池中没有线程时自动转换(队列中可能还有任务)
- TIDYING -> TERMINATED:terminated()执行完后就会自动转换
164. 线程池为什么一定得是阻塞队列?
线程池中的线程在运行过程中,执行完创建线程时绑定的第一个任务后,就会不断的从队列中获取任务 并执行,那么如果队列中没有任务了,线程为了不自然消亡,就会阻塞在获取队列任务时,等着队列中 有任务过来就会拿到任务从而去执行任务。 通过这种方法能最终确保,线程池中能保留指定个数的核心线程数,关键代码: 某个线程在从队列获取任务时,会判断是否使用超时阻塞获取,我们可以认为非核心线程会poll(),核心 线程会take(),非核心线程超过时间还没获取到任务后面就会自然消亡了。
165. 线程发生异常,会被移出线程池吗?
答案是会的,那有没有可能核心线程数在执行任务时都出错了,导致所有核心线程都被移出了线程池? 在源码中,当执行任务时出现异常时,最终会执行processWorkerExit(),执行完这个方法后,当前线程 也就自然消亡了,但是!processWorkerExit()方法中会额外再新增一个线程,这样就能维持住固定的核 心线程数。
166. 线程池的核心线程数、最大线程数该如何设置?
我们都知道,线程池中有两个非常重要的参数:
- corePoolSize:核心线程数,表示线程池中的常驻线程的个数
- maximumPoolSize:最大线程数,表示线程池中能开辟的最大线程个数 那这两个参数该如何设置呢? 我们对线程池负责执行的任务分为三种情况:
- CPU密集型任务,比如找出1-1000000中的素数
- IO密集型任务,比如文件IO、网络IO
- 混合型任务 CPU密集型任务的特点时,线程在执行任务时会一直利用CPU,所以对于这种情况,就尽可能避免发生 线程上下文切换。 比如,现在我的电脑只有一个CPU,如果有两个线程在同时执行找素数的任务,那么这个CPU就需要额 外的进行线程上下文切换,从而达到线程并发的效果,此时执行这两个任务的总时间为: 任务执行时间2+线程上下文切换的时间 而如果只有一个线程,这个线程来执行两个任务,那么时间为: 任务执行时间2 所以对于CPU密集型任务,线程数最好就等于CPU核心数,可以通过以下API拿到你电脑的核心数: 只不过,为了应对线程执行过程发生异常导致线程阻塞的请求,我们可以额外在多设置一个线程,这样 当某个线程暂时不需要CPU时,可以有替补线程来继续利用CPU。
try {
Runnabler=timed?
workQueue.poll(keepAliveTime, TimeUnit.NANOSECONDS) :
workQueue.take();
if (r!=null)
returnr;
timedOut=true;
} catch (InterruptedExceptionretry) {
timedOut=false;
}
1
2
3
4
5
6
7
8
9
10
Runtime.getRuntime().availableProcessors()
1
所以,对于CPU密集型任务,我们可以设置线程数为:CPU核心数+1 我们在来看IO型任务,线程在执行IO型任务时,可能大部分时间都阻塞在IO上,假如现在有10个CPU, 如果我们只设置了10个线程来执行IO型任务,那么很有可能这10个线程都阻塞在了IO上,这样这10个 CPU就都没活干了,所以,对于IO型任务,我们通常会设置线程数为:2CPU核心数 不过,就算是设置为了2CPU核心数,也·不一定是最佳的,比如,有10个CPU,线程数为20,那么也 有可能这20个线程同时阻塞在了IO上,所以可以再增加线程,从而去压榨CPU的利用率。
通常,如果IO型任务执行的时间越长,那么同时阻塞在IO上的线程就可能越多,我们就可以设置更多的
线程,但是,线程肯定不是越多越好,我们可以通过以下这个公式来进行计算: 线程数 = CPU核心数 *( 1 + 线程等待时间 / 线程运行总时间) 线程等待时间:指的就是线程没有使用CPU的时间,比如阻塞在了IO 线程运行总时间:指的是线程执行完某个任务的总时间 我们可以利用jvisualvm抽样来估计这两个时间: 图中表示,在刚刚这次抽样过程中,run()总共的执行时间为92567ms,利用了CPU的时间为 11027ms,所以没有利用CPU的时间为92567ms-11027ms。 所以我们可以计算出: 线程等待时间 = 92567ms-11027ms。 线程运行总时间 =92567ms 所以:线程数 = 20 *( 1 + (92567ms-11027ms) / 92567ms )≈ 37 所以根据公式算出来的线程为37、38个线程左右。 按上述公式,如果我们执行的任务IO密集型任务,那么:线程等待时间 = 线程运行总时间,所以: 线程数 = CPU核心数 *( 1 + 线程等待时间 / 线程运行总时间) = CPU核心数 *( 1 + 1 ) = CPU核心数 * 2 以上只是理论,实际工作中情况会更复杂,比如一个应用中,可能有多个线程池,除开线程池中的线程 可能还有很多其他线程,或者除开这个应用还是一些其他应用也在运行,所以实际工作中如果要确定线 程数,最好是压测。 这个接口会执行1s,我现在利用apipost来压:
@RestController
publicclassHzkController {
@GetMapping("/test")
publicStringtest() throwsInterruptedException {
Thread.sleep(1000);
return"success";
}
}
1
2
3
4
5
6
7
8
9
10
这是在Tomcat默认最大200个线程的请求下的压测结果。 当我们把线程数调整为500: 发现执行效率提高了一倍,假如再增加线程数到1000: 提升就不那么高了。
总结,我们再工作中,对于:
- CPU密集型任务:CPU核心数+1,这样既能充分利用CPU,也不至于有太多的上下文切换成本
- IO型任务:建议压测,或者先用公式计算出一个理论值(理论值通常都比较小)
- 对于核心业务(访问频率高),可以把核心线程数设置为我们压测出来的结果,最大线程数可以等 于核心线程数,或者大一点点,比如我们压测时可能会发现500个线程最佳,但是600个线程时也 还行,此时600就可以为最大线程数
- 对于非核心业务(访问频率不高),核心线程数可以比较小,避免操作系统去维护不必要的线程, 最大线程数可以设置为我们计算或压测出来的结果。
167. Tomcat是如何自定义线程池的?
Tomcat中用的线程池为org.apache.tomcat.util.threads.ThreadPoolExecutor,注意类名和JUC下的一 样,但是包名不一样。 Tomcat会创建这个线程: 注意传入的队列为TaskQueue,它的入队逻辑为:
publicvoidcreateExecutor() {
internalExecutor=true;
TaskQueuetaskqueue=newTaskQueue();
TaskThreadFactorytf=newTaskThreadFactory(getName() +"-exec-",
daemon, getThreadPriority());
executor=newThreadPoolExecutor(getMinSpareThreads(), getMaxThreads(),
60, TimeUnit.SECONDS,taskqueue, tf);
taskqueue.setParent( (ThreadPoolExecutor) executor);
}
1
2
3
4
5
6
7
publicbooleanoffer(Runnableo) {
//we can't do any checks
if (parent==null) {
returnsuper.offer(o);
}
//we are maxed out on threads, simply queue the object
if (parent.getPoolSize() ==parent.getMaximumPoolSize()) {
returnsuper.offer(o);
}
//we have idle threads, just add it to the queue
if (parent.getSubmittedCount()<=(parent.getPoolSize())) {
returnsuper.offer(o);
}
//if we have less threads than maximum force creation of a new thread
if (parent.getPoolSize()<parent.getMaximumPoolSize()) {
returnfalse;
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
特殊在: 入队时,如果线程池的线程个数等于最大线程池数入队。 入队时,如果线程池有闲置线程,任务依旧入队。 入队时,如果线程池的线程个数小于最大线程池数,会返回false,表示入队失败,则去创建线程。 这样就控制了,Tomcat的这个线程池,在提交任务时:
- 不会先判断线程个数是否小于核心线程数,而是提前创建10个核心线程。
- 如果等于最大线程数,会入队,但是线程个数小于最大线程数会入队失败,从而会去创建线程 所以随着任务的提交,会优先创建线程,直到线程个数等于最大线程数才会入队。 当然其中有一个比较细的逻辑是:在提交任务时,如果正在处理的任务数小于线程池中的线程个数,那 么也会直接入队,而不会去创建线程,也就是上面源码中getSubmittedCount的作用。
168. ThreadLocal的原理和使用场景
每一个 Thread 对象均含有一个 ThreadLocalMap 类型的成员变量 threadLocals ,它存储本线程中所 有ThreadLocal对象及其对应的值ThreadLocalMap 由一个个 Entry 对象构成Entry 继承自 WeakReference<ThreadLocal<?>> ,一个 Entry 由 ThreadLocal 对象和 Object 构成。由此可见, Entry 的key是ThreadLocal对象,并且是一个弱引用。当没指向key的强引用后,该 key就会被垃圾收集器回收。 当执行set方法时,ThreadLocal首先会获取当前线程对象,然后获取当前线程的ThreadLocalMap对 象。再以当前ThreadLocal对象为key,将值存储进ThreadLocalMap对象中。 get方法执行过程类似。ThreadLocal首先会获取当前线程对象,然后获取当前线程的ThreadLocalMap 对象。再以当前ThreadLocal对象为key,获取对应的value。 由于每一条线程均含有各自私有的ThreadLocalMap容器,这些容器相互独立互不影响,因此不会存在 线程安全性问题,从而也无需使用同步机制来保证多条线程访问容器的互斥性。 使用场景: 1、在进行对象跨层传递的时候,使用ThreadLocal可以避免多次传递,打破层次间的约束。 2、Spring框架进行事务操作,用于存储线程事务信息。 3、Spring框架数据库连接,Session会话管理。 4、SpringMVC框架的处理器请求管理。
例子:example:
}
//if we reached here, we need to add it to the queue
returnsuper.offer(o);
}
20
21
22
23
24
Spring框架在事务开始时会给当前线程绑定一个Jdbc Connection,在整个事务过程都是使用该线程绑 定的connection来执行数据库操作,实现了事务的隔离性。Spring框架里面就是用的ThreadLocal来 实现这种隔离
1
packagecom.hzk.test.my;
publicclassPerson {
privateThreadLocal<String>name=newThreadLocal<>();
1
2
3
4
5
169. ThreadLocal内存泄漏原因,如何避免
publicvoidsetName(Stringname) {
this.name.set(name);
}
publicStringgetName() {
returnthis.name.get();
}
publicvoidremove() {
this.name.remove();
}
}
6
7
8
9
10
11
12
13
14
15
16
17
18
19
packagecom.hzk.test.my;
importjava.util.concurrent.TimeUnit;
publicclassTest {
publicstaticvoidmain(String[] args) {
Personperson=newPerson();
Threadthread1=newThread(newRunnable() {
@Override
publicvoidrun() {
person.setName("hzk");
try {
TimeUnit.SECONDS.sleep(3);
} catch (InterruptedExceptione) {
e.printStackTrace();
}
System.out.println("线程1==="+person.getName());
}
});
thread1.start();
Threadthread2=newThread(newRunnable() {
@Override
publicvoidrun() {
person.setName("hello");
try {
TimeUnit.SECONDS.sleep(3);
} catch (InterruptedExceptione) {
e.printStackTrace();
}
System.out.println("线程2==="+person.getName());
}
});
thread2.start();
}
}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
内存泄露:为程序在申请内存后,无法释放已申请的内存空间,一次内存泄露危害可以忽略,但内存泄 露堆积后果很严重,无论多少内存,迟早会被占光,不再会被使用的对象或者变量占用的内存不能被回 收,就是内存泄露。 强引用:使用最普遍的引用(new),一个对象具有强引用,不会被垃圾回收器回收。当内存空间不足, Java虚拟机宁愿抛出OutOfMemoryError错误,使程序异常终止,也不回收这种对象。 如果想取消强引用和某个对象之间的关联,可以显式地将引用赋值为null,这样可以使JVM在合适的时间 就会回收该对象。 弱引用:JVM进行垃圾回收时,无论内存是否充足,都会回收被弱引用关联的对象。在java中,用 java.lang.ref.WeakReference类来表示。可以在缓存中使用弱引用。 ThreadLocal的实现原理,每一个Thread维护一个ThreadLocalMap,key为使用弱引用的ThreadLocal 实例,value为线程变量的副本。 ThreadLocalMap使用ThreadLocal的弱引用作为key,如果一个ThreadLocal不存在外部强引用时, Key(ThreadLocal)势必会被GC回收,这样就会导致ThreadLocalMap中key为null,而value还存在着强 引用,只有thead线程退出以后,value的强引用链条才会断掉,但如果当前线程再迟迟不结束的话,这些 key为null的Entry的value就会一直存在一条强引用链(红色链条) key使用强引用当ThreadLocalMap的key为强引用回收ThreadLocal时,因为ThreadLocalMap还持有 ThreadLocal的强引用,如果没有手动删除,ThreadLocal不会被回收。 key 使用弱引用当ThreadLocalMap的key为弱引用回收ThreadLocal时,由于ThreadLocalMap持有 ThreadLocal的弱引用,即使没有手动删除,ThreadLocal也会被回收。当key为null时,调用完set方法 之后,在调用remove方法的时候会清除value值。 因此,内存泄漏的根源是:由于ThreadLocalMap的生命周期跟Thread一样长,如果没有手动删除对应 key的value,就会导致内存泄漏,而不是因为弱引用。 ThreadLocal正确的使用姿势:每次使用完ThreadLocal都调用它的remove()方法清除数据 .
170. ThreadLocal有哪些应用场景
ThreadLocal是Java中的一个类,它提供了一种在多线程环境下实现线程局部变量存储的机制。 它的应用场景包括线程池、Web开发中的请求上下文信息管理、数据库连接管理和日志记录等等。 在线程池中,可以使用ThreadLocal为每个线程维护独立的上下文信息,避免线程间互相干扰。 在Web开发中,可以使用ThreadLocal存储当前请求的上下文信息,避免参数传递的复杂性。 在数据库连接管理中,ThreadLocal可以为每个线程保持独立的数据库连接,提高并发性能。 在日志记录中,ThreadLocal可以将日志记录与当前线程关联起来,方便追踪和排查问题。 此外,ThreadLocal还可以用于在线程之间传递全局的上下文信息。 在使用ThreadLocal时需要注意内存泄漏问题和线程安全性,及时清理不再需要的变量副本,并采取适 当的同步措施保证线程安全。通过合理使用ThreadLocal,可以简化多线程编程,提高程序的性能和可 维护性。
171. 讲讲你对CountDownLatch的理解
CountDownLatch是Java中用于多线程协作的辅助类,它可以让一个或多个线程等待其他线程完成某个 任务后再继续执行。 CountDownLatch通过一个计数器来实现,计数器的初始值可以设置为等待的线程数量。每个线程在完 成任务后都会调用countDown()方法来减少计数器的值。当计数器的值减至0时,等待在 CountDownLatch上的线程就会被唤醒,可以继续执行后续的操作。 CountDownLatch的主要作用是协调多个线程的执行顺序,使得某个线程(或多个线程)必须等待其他 线程完成后才能继续执行。它常用于以下场景:
- 主线程等待多个子线程完成任务:主线程可以使用await()方法等待所有子线程完成,然后进行结果 的汇总或其他操作。
- 多个线程等待外部事件的发生:多个线程可以同时等待某个共同的事件发生,比如等待某个资源准 备就绪或者等待某个信号的触发。
- 控制并发任务的同时开始:在某些并发场景中,需要等待所有线程都准备就绪后才能同时开始执行 任务,CountDownLatch提供了一种便捷的方式来实现这一需求。 需要注意的是,CountDownLatch的计数器是不能被重置的,也就是说它是一次性的。一旦计数器减至 0,它将无法再次使用。如果需要多次使用可重置的计数器,则可以考虑使用CyclicBarrier。
172. CountDownLatch 与 join 方法的区别
调用一个子线程的join()方法后,该线程会一直被阻塞直到子线程运行完毕。而 CountDownLatch 可在子线程运行任何时候让await方法返回而不一定等到线程结束 使用线程池来管理线程时候一般都是直接添加 Runnable 到线程池,这时候没有办法再调用线程的 join 方法,countDownLatch可以,在Runnable中调用await。
173. 讲讲你对CyclicBarrier的理解
CyclicBarrier是Java中的一个多线程协作工具,它可以让多个线程在一个屏障点等待,并在所有线程都 到达后一起继续执行。与CountDownLatch不同,CyclicBarrier可以重复使用,并且可以指定屏障点后 执行的额外动作。 CyclicBarrier的主要特点有三个。 首先,它可以重复使用,这意味着当所有线程都到达屏障点后,屏障会自动重置,可以用来处理多 次需要等待的任务。 其次,CyclicBarrier可以协调多个线程同时开始执行,这在分阶段任务和并发游戏等场景中非常有 用。 最后,CyclicBarrier还提供了可选的动作,在所有线程到达屏障点时执行,可以实现额外的逻辑。 需要注意的是,在创建CyclicBarrier时需要指定参与线程的数量。一旦所有参与线程都到达屏障点后, CyclicBarrier解除阻塞,所有线程可以继续执行后续操作。
174. CountDownLatch/CyclicBarrier/Semaphore比较
特性
CountDownLatch
CyclicBarrier
Semaphore
核心功 能 等待其他线程完成事件 线程间相互等待到屏障点 控制资源并发访问数量 重用性 一次性(计数器到0后失 效) 可循环使用(屏障可重 置) 可重复使用(许可证循 环) 计数器 递减到0触发 递减到0触发重新回到初 始值 可用许可证数,增减都 可以 主要方 法 await(), countDown() await() acquire(), release() 线程关 系 等待方≠被等待方 等待方 = 被等待方 无 “等待方/被等待方”概 念 异常处 理 不会重置 会破坏屏障 不影响信号量 典型场 景 主线程等子线程初始化 多阶段协作任务 限流(如连接池)
一句话记忆
CountDownLatch:“你等我,我不等你”(一组等另一组)。 CyclicBarrier:“大家一起等,等齐了再走”(同组相互等,可重复)。 Semaphore:“排队进门,一次只能进 N 个”(限流)。
175. CompletableFuture线程编排工具
1)、什么是 CompletableFuture?
CompletableFuture 是 Java 8 引入的非阻塞异步编程核心工具,它同时实现 Future 接口(继承异步结 果容器能力)和 CompletionStage 接口(新增异步任务编排能力),提供了丰富的函数式 API,用于处 理异步任务的启动、结果转换、多任务协同和异常捕获。 简单来说: 它是「异步结果的容器」:存储异步任务的成功 / 失败结果,支持非阻塞获取; 它是「异步任务的编排器」:用链式调用描述复杂异步逻辑(如 “多任务并行 + 结果聚合”); 它是「Future 的增强版」:弥补传统 Future 的短板,让 Java 原生支持高效、简洁的非阻塞异步 编程,无需依赖第三方框架。
2)、为什么需要它?(解决了什么问题?)
在 CompletableFuture 之前,Java 依赖 Future + ExecutorService 实现异步,但存在诸多难以解决的 痛点,无法满足复杂异步场景需求:
176. 传统 Future 的核心局限性(场景化痛点)
阻塞获取结果,效率低**:Future.get() 是阻塞式,要么一直等,要么指定超时 —— 想实现 “任务 完成后自动执行后续逻辑”,只能开额外线程循环查询,浪费资源(如 “异步查库后自动更缓存”, Future 只能阻塞等结果); 复杂任务组合困难:无法简洁表达 “并行执行 A、B,都完成后执行 C”“A 失败则执行兜底任务 D” 等 逻辑,只能手动 get() 阻塞等待,代码嵌套深、维护难; 异常处理割裂:异常只能在 get() 时通过 ExecutionException 捕获,无法融入异步链 —— 中间任 务抛异常,只能在最终获取结果时统一处理,排查困难; 无回调机制,灵活性差:没有原生 “任务完成后自动回调” 能力,只能被动阻塞查询,无法适配 “异 步下载完成通知前端” 等场景; 无法手动干预结果:结果只能由任务本身生成,外部无法手动设置兜底结果(如数据库查询失败时 返回缓存数据)。
177. CompletableFuture 的核心优势(精准解决上述痛点)
异步执行 + 灵活线程管理:无需显式创建线程,默认使用 ForkJoinPool,也支持自定义线程池(如 固定线程池),适配 CPU/IO 密集型场景; 链式编排:支持异步任务的串联 / 分支(如 taskA.thenApply(…)),代码线性编写,无嵌套,可读 性强; 多任务组合:提供 allOf(所有任务完成)、anyOf(任意任务完成)、thenCombine(两任务结 果组合)等 API,轻松实现复杂协同逻辑; 全链路异常处理:通过 exceptionally(仅异常兜底)、handle(正常 + 异常统一处理)、 whenComplete(仅消费异常)等 API,异常处理可融入异步链任意环节; 非阻塞 + 回调通知:无需阻塞等待,任务完成后自动触发回调逻辑(如 thenAccept),最大化利 用线程资源; 手动干预结果:支持 complete()(手动设成功结果)、completeExceptionally()(手动触发异 常),适配缓存降级、超时兜底等场景
3)、常用的方法有哪些
开始任务的方法
runAsync:无返回值 supplyAsync 有返回值
中间方法1(增加新任务)
thenApplyAsync:有参数有返回值 thenRunAsync:无参数无返回值 thenAcceptAsync:有参数无返回值
中间方法2:(不增加新任务)
exceptionally:出现异常时执行,有返回值 handle:统一处理正常和异常情况,有返回值 whenComplete:统一处理正常和异常情况,无返回值
完成任务的方法
allOf: 所有任务 anyOf 任意一个任务 get:join:都是阻塞的,才能保证真正的任务执行完
178. 多线程的实现几种方式
继承 Thread 类、实现 Runnable 接口、实现 Callable 接口(JDK5+),前两者无返回值,后者有 返回值且可抛异常 线程池(ExecutorService),基于 Runnable/Callable 封装,兼顾性能和可管理性 Thread 受单继承限制,Runnable 灵活,Callable 支持返回值,线程池解决线程复用问题。
179. 线程的生命周期
NEW 新建态 创建Thread 实例→ NEW,未调用start() RUNNABLE 可运行态 调用start() 后进入,包含 “就绪” 和 “运行中” 两个细分状态 BLOCKED 阻塞状态 竞争 synchronized 锁失败→ BLOCKED;抢到锁→ RUNNABLE WAITING 等待状态
调用Object.wait() / Thread.join() / LockSupport.park()→ WAITING;
其他线程调用Object.notify() / LockSupport.unpark()→ RUNNABLE
需其他线程主动唤醒 TIMED_WAITING 超时等待状态
调用Thread.sleep(long) / Object.wait(long) / Thread.join(long)→TIMED_WAITING;超时 / 被唤醒→ RUNNABLE 有时间限制的等待,超时后自动唤醒 TERMINATED 终止状态 RUNNABLE 状态下run() 执行完成 / 抛出未捕获异常→ TERMINATED
180. Lambda表达式
必须基于「只有一个抽象方法」的接口(如Runnable 、Consumer 、Predicate 、Function ),这是 Lambda 能生效的核心条件(JDK8 用@FunctionalInterface 注解标识)。 简化 Runnable
publicclassSingletonHungry {// 1. 私有静态常量:类加载时直接初始化唯一实例(饿汉式核心)
privatestaticfinalSingletonHungryINSTANCE=newSingletonHungry();// 2. 私有构造方法:禁止外部new创建实例
privateSingletonHungry() {}// 3. 公有静态方法:返回唯一实例
publicstaticSingletonHungrygetInstance() {
returnINSTANCE;
}
}
publicclassSingletonLazy {
// 1. 私有静态变量:volatile禁止指令重排(关键),初始为null
privatestaticvolatileSingletonLazyINSTANCE;
// 2. 私有构造方法:禁止外部new
privateSingletonLazy() {}
// 3. 公有静态方法:双重校验锁实现懒加载+线程安全
publicstaticSingletonLazygetInstance() {// 第一层校验:避免每次调用都加锁(提升性能)
if (INSTANCE==null) {// 加锁:保证多线程下仅一个线程进入创建实例
synchronized (SingletonLazy.class) {// 第二层校验:防止多个线程等待锁后重复创建
if (INSTANCE==null) {
INSTANCE=newSingletonLazy();
}
}
}
returnINSTANCE;
}
}
// 传统方式(匿名内部类)
newThread(newRunnable() {
@Override
publicvoidrun() {
System.out.println("传统线程");
}
}).start();
// Lambda简化(无参数,单行代码)
newThread(() ->System.out.println("Lambda线程")).start();接口名称
核
心
方
法
方法签
名
使用
Consumer<T>消 费 者 入参 T, 无返回 值
Consumer<String> ps= System.out::println;
ps.accept("Hello, World!")
Supplier<T>
供 应 商 无入 参,返 回 T
Supplier<String> sup= () -> "Hello, World!";
String result = sup.get();
Function<T,R>
函 数 入参 T, 返回 R
Function<String, Integer> toLength =
String::length; int length =
toLength.apply("Hello, World!");
Predicate<T>
断 言 入参 T, 返回 boolean
Predicate<String> isEmpty = String::isEmpty;
boolean result = isEmpty.test("");
简化集合遍历(forEach + Consumer) 简化 Stream 流操作(filter/map 等)
181. 自定义线程池
定义:
参数:
corePoolSize:线程池常驻的最小线程数,即使空闲也不会销毁,除非设置
allowCoreThreadTimeOut=truemaximumPoolSize:线程池允许创建的最大线程数,核心线程 + 非核心线程的总数上限 keepAliveTime:非核心线程空闲超过该时间则销毁,释放资源 unit:keepAliveTime的时间单位(如 SECONDS、MILLISECONDS) workQueue:核心线程满时,新任务进入队列等待 ArrayBlockingQueue:一个由数组结构组成的有界阻塞队列。 LinkedBlockingQueue:一个由链表结构组成的有界阻塞队列。 SynchronousQueue:一个不存储元素的阻塞队列,即直接提交给线程不保持它们 PriorityBlockingQueue:一个支持优先级排序的无界阻塞队列。 DelayQueue:一个使用优先级队列实现的无界阻塞队列,只有在延迟期满时才能从中提取 元素 LinkedTransferQueue:一个由链表结构组成的无界阻塞队列。与SynchronousQueue类 似,还含有非阻塞方法。 LinkedBlockingDeque:一个由链表结构组成的双向阻塞队列。 threadFactory:创建线程的工厂,可自定义线程名称、优先级、是否守护线程等 handler:拒绝策略:任务队列满 + 最大线程数已满时,处理新任务的策略 AbortPolicy(默认):直接抛出RejectedExecutionException 异常,终止任务提交 CallerRunsPolicy:由提交任务的线程(如主线程)直接执行该任务,降低任务提交速度 DiscardPolicy:静默丢弃新任务,无异常、无提示 DiscardOldestPolicy:丢弃队列中最旧的任务(队列头部),将新任务加入队列
执行流程:
- 线程池初始化时,核心线程不会立即创建,而是等待任务提交后才创建(可通过
prestartCoreThread() / prestartAllCoreThreads() 预创建);- 非核心线程执行完任务后,空闲时间超过keepAliveTime 会被销毁;
- 任务队列的优先级高于非核心线程(核心线程满→先入队列,队列满→再创建非核心线程,非核心 满→拒绝策略)
182. synchronized和ReentranLock区别
// 自定义线程池核心示例
ExecutorServiceexecutor=newThreadPoolExecutor(
2,   // 核心线程数
5,   // 最大线程数
60L, // 空闲线程存活时间
TimeUnit.SECONDS,   // 时间单位
newArrayBlockingQueue<>(10),        // 任务队列(有界)
Executors.defaultThreadFactory(),    // 线程工厂
newThreadPoolExecutor.AbortPolicy() // 拒绝策略
);
对比维度
synchronized
ReentrantLock
核心实现 JVM 的内置锁(关键字) JDK 显式锁(java.util.concurrent.locks 包) 锁类型 非公平锁 默认非公平锁,可手动设置为公平锁 可中断性 不可中断 可中断 超时获取 锁 不支持 支持(tryLock) 等待 / 唤 醒 只能通过 wait ()/notify (),随机唤醒 线程 支持多个 Condition,精准唤醒指定线程 可重入性 支持 支持 释放方式 自动释放 必须手动释放(finally 中调用 unlock ()) 锁状态获 取 无法获取 可获取(isLocked ()、getHoldCount () 等)
183. volatile关键字
用于修饰成员变量 / 静态变量,核心作用是保证变量的「可见性」和「有序性」,但不保证原子性,是 JMM(Java 内存模型)的核心实现之一。 可见性 ①对 volatile 变量的写操作:强制将工作内存的新值同步到主内存; ②对 volatile 变量的读操作:强制从主内存读取最新值,禁用工作内存缓存; 有序性(禁止指令重排) 通过「内存屏障」禁止 volatile 变量相关指令的重排,保证指令执行顺序与代码顺序一致,单例模 式必须加 volatile 不保证原子性 volatile 修饰的变量执行「读 - 改 - 写」操作(如i++ )时,多线程下仍会数据错乱;
解决:原子性需通过synchronized 、Lock 或AtomicInteger (CAS)实现。使用场景:①状态标记位②单例模式 DCL(双重校验锁)③保证变量的可见性(替代锁)
184. CAS是什么
CAS(Compare And Swap)—— 比较并交换,CPU 层面的原子指令(非 Java 语法),通过原子操作 替代锁,避免线程上下文切换的开销。 核心参数:①内存地址②预期值③新值 执行逻辑:内存地址V的值==预期值A ?将V的值更新为B,返回true :不更新,返回false 整个过程是CPU层的原子性,无锁;更新失败,会通过「自旋」(循环重试)再尝试,直到成 功。
Java 通过sun.misc.Unsafe 类调用 CAS 指令,java.util.concurrent.atomic 包均基于 CAS实现 优缺点:
优点
缺点
无锁,开销远小于 synchronized ABA 问题(值被修改后又改回,CAS 误判) 原子性,无需担心线程安全 自旋重试导致 CPU 占用高 适用于低冲突场景 只能保证单个变量的原子性
模式
核心逻辑
典型应用
独占模 式 同一时间仅一个线程获取 锁 ReentrantLock、ReentrantReadWriteLock(写 锁) 共享模 式 同一时间多个线程可获取 锁 CountDownLatch、Semaphore、 ReentrantReadWriteLock(读锁)
185. AQS是什么
AQS 是 Java 并发包的核心抽象类,是 ReentrantLock、CountDownLatch、Semaphore 等并发工具 的底层实现框架,封装了 “等待队列 + 同步状态” 的核心逻辑
核心设计:
同步状态(state) 用volatile int state 表示同步状态(state=0 表示无锁,state>0 表示重入次数) 基于 CAS 修改 state,保证状态更新的原子性。 CLH 等待队列(双向链表) 当线程获取锁失败时,会被封装为「节点」加入队列尾部,阻塞等待; 队列遵循 FIFO(先进先出),只有队列头节点能竞争锁。 tryAcquire(int arg) :独占模式获取锁(ReentrantLock 重写);
tryRelease(int arg) :独占模式释放锁;tryAcquireShared(int arg) :共享模式获取锁(CountDownLatch 重写);
tryReleaseShared(int arg) :共享模式释放锁。186. ThreadLocal实现原理
ThreadLocal(线程本地变量)是 Java 提供的线程隔离工具。 核心:ThreadLocal 的核心是「ThreadLocalMap」,每个Thread对象都有一个 ThreadLocalMap,当创建一个ThreadLocal的时候,就会将该ThreadLocal对象添加到该Map 中,其中键就是ThreadLocal,值可以是任意类型。 源码: set get getMap 内存泄漏问题:
- ThreadLocalMap 的 Entry 中,key 是 ThreadLocal 的弱引用(GC 时若 ThreadLocal 无强 引用,key 会被回收),但value 是强引用;
- 若 ThreadLocal 使用后未调用remove() ,key 被回收后,value 仍被线程的 ThreadLocalMap 强引用,导致 value 无法被 GC,最终内存泄漏; 解决泄露:
- 使用后必须调用 remove ()
- 避免使用静态 ThreadLocal(减少强引用持有时间);
- 线程池场景:线程复用前可通过线程池的afterExecute 钩子方法进行清理。
187. 什么是线程
进程区别
进程是系统分配资源(内存)最小单位。一个应用程序运行起来至少有一个进程。线程共享进程分配到的资源(内存),线程是CPU最小调度的单位,一个进程至少有一个线程。 案例:植物大战僵尸这款游戏,启动后开启一个进程,里面的僵尸,植物,背景音乐都是并发的线程。
188. 线程的创建方式
5种方式: 1.继承Thread类 2.实现Runnable接口 3.实现Callable接口 4.线程池 5.CompletableFuture线程编排
189. 线程的生命周期
和状态切换
NEW: 线程未运行 | start() RUNNABLE:可运行状态
RUNNABLE:可运行状态 | 同步块中抢锁失败 _EntryList中 BLOCKED
RUNNABLE:可运行状态 | sleep()/wait()/join WAITING/TIMED_WAITING | 时间到/通知/唤醒 RUNNABLE
BLOCKED | 抢到锁回到可运行状态 RUNNABLE
RUNNABLE | run()结束 TERMINATED
190. 线程传递数据
1.启动前传参 —— 最安全 在调用线程start()方法前,通过构造方法,Setter方法,匿名内部类/lambda中捕获的外部变量 传入参数。
2.运行时通信(共享内存,消息队列) —— 最常见 ①共享内存:volatile,synchronized同步块中的变量,每个线程共享的,可以获取到 ②一个线程发送到MQ,另一个线程监听来获取,异步解耦
3.结束后拿结果 —— Callable登场
可以使用Callable
0
191. 线程池
192. 为什么要使用线程池
优点: 1.降低开销 每次开始一个线程-> pthread_create() 从用户态直接请求内核态,各种消耗性能。节省了创建和销毁的时间,将性能开销从用户时间转移到应用的启动时间里,极大降低了响应延迟。
2.解耦了任务的提交和执行 new Thread().start();
3.防止资源耗尽 单线程处理高并发 10万个请求,线程就可能导致卡死状态 有界线程池+有界队列+拒绝策略=防止JVM崩溃的防线 100个线程+(一个队列10万个请求)+ 10万01个请求给拒绝
4.统一管理所有线程 getActiveCount() getTaskCount() getQueue().size() 观测流量指标
5.上下文切换 线程池的线程复用,减少了创建,CPU缓存命中率也高,单一的线程启动后cache没有数据导致性能下降
终极反杀题: 既然线程池这么好用,阿里手册上为什么说“newFixedThreadPool”和“newSingleThreadExecutor”不让用呢? 因为他们默认使用了LinkedBlockingQueue(无界队列),任务会堆积,最终撑爆内存。
193. 有几种线程池
1.固定大小 —— 负载平稳 Executors.newFixedThreadPool(int n) 核心线程数=最大线程数,无界队列(致命)
2.单线程池 —— 保证可以按顺序执行 Executors.newSingleThreadExecutor() 核心=最大=1,无界队列(致命)
3.缓存线程池 —— 可以弹性伸缩 Executors.newCachedThreadPool() 核心=0,最大=Int最大值,同步移交队列(SynchronousQueue), 瞬间高并发会导致OOM和CPU 100%
4.定时任务线程池 —— 调度 Executors.newScheduledThreadPool(int corePoolSize) 延时执行,corePoolSize固定大小,DelayedWorkQueue按时间排序的堆结构。如果任务时间过长可能会阻塞后续的周期任务 Executors.newSingleScheduledThreadPool() 单一定时线程池
5.工作窃取池 —— java 8+ 并行计划 Executors.newWorkStealingPool(int parallelism) 每个线程有自己的双端队列Deque,如果自己的任务做完会偷其他线程队列的尾部任务。如百万级数组求和
194. 自定义线程池
195. start和run的区别
如果直接调用run()方法,就相当于普通方法的一次调用。 线程要求必须使用start()方法调用才会创建新线程,并由JVM调用run()方法。
196. 并发和并行区别
并发:CPU时间片轮询,操作系统通过时钟终端,频繁切换上下文(保存/恢复 CPU寄存器和程序计数器) 并行:依赖多核/多处理器CPU数量,程序在不同的CPU物理内核上跑。一个内核拿一个任务运行。
你开发中遇到哪些并发和并行的类或者包? 并发包:ConcurrentHashMap:内部使用了分段锁/CAS,本质就是并发设计结构 并行流:ParallelStream,这些Parallel开头的类专门为了并行设计,目的是利用多核CPU把大任务拆分成小任务同时计算
如何用代码判断当前是并发还是并行?(略) Runtime.getRuntime().availableProcessors()>1 核心数大于1 && 线程数>1 才能判断并行
197. sleep和wait区别
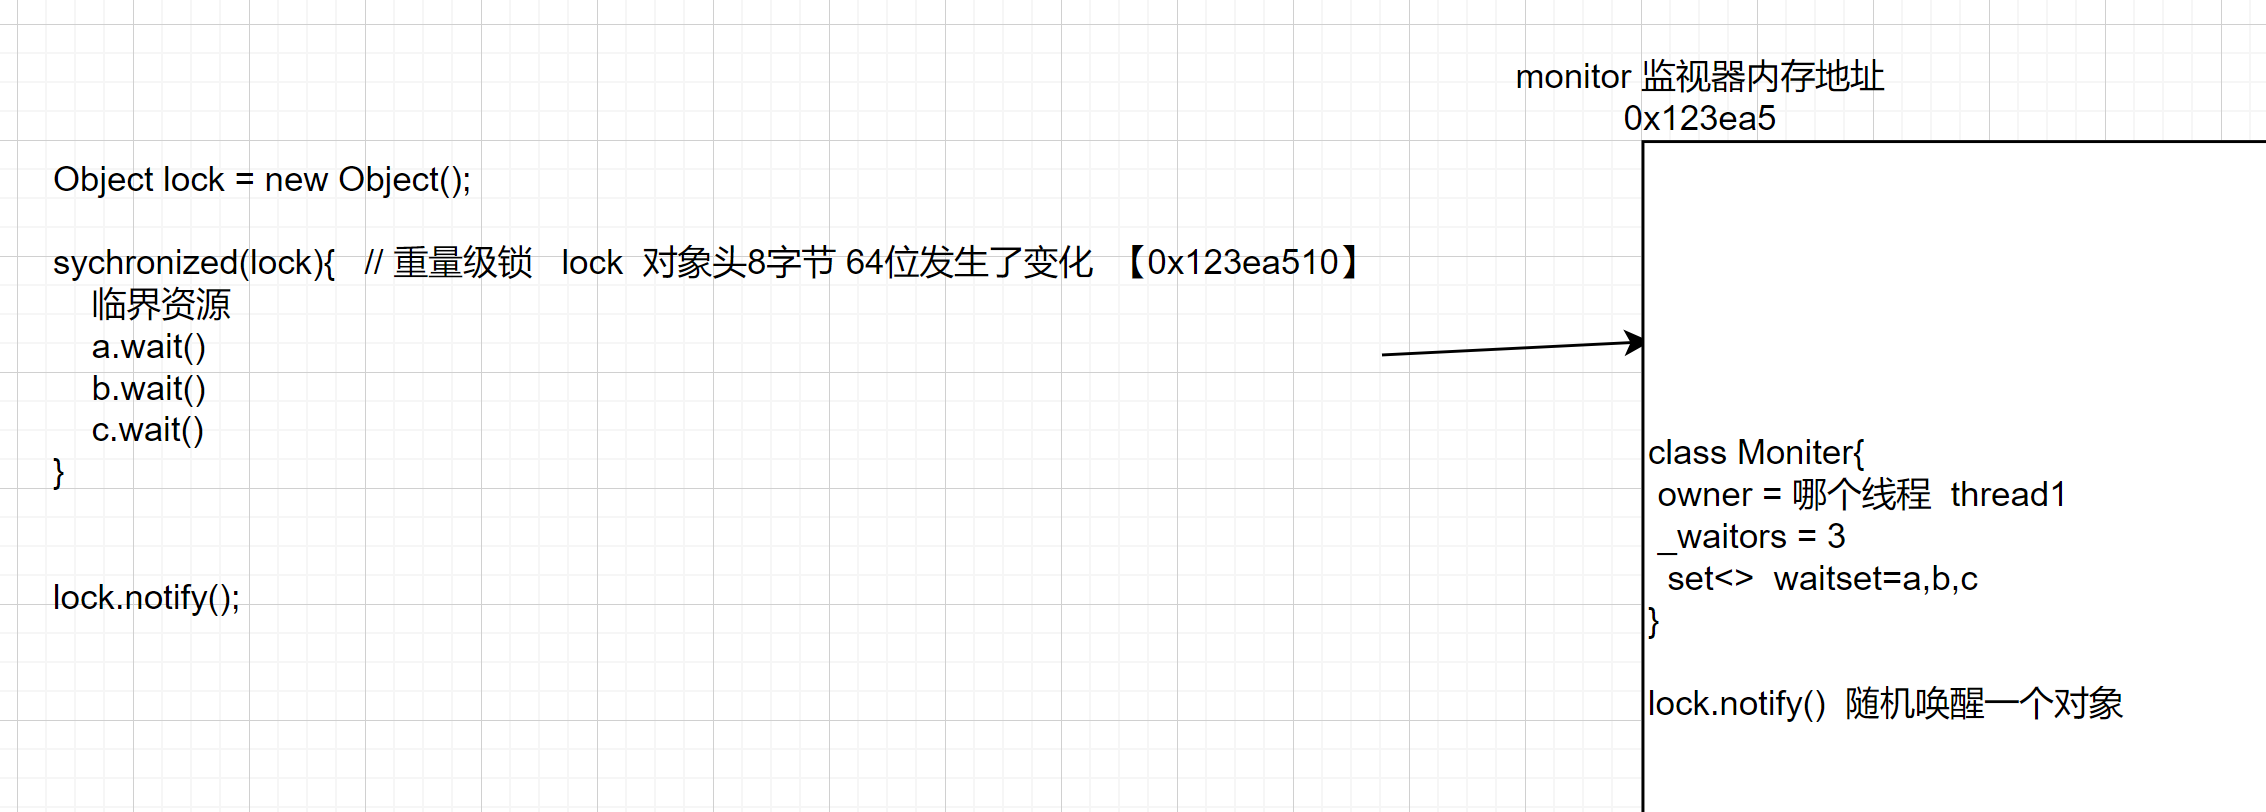
1.归属 Object.wait(); // 对象方法 Thread.sleep(); // 静态方法 2.释放锁 wait释放, sleep不释放 3.使用位置 wait只能在同步块/同步方法中 sleep任意位置 4.唤醒方式 sleep 超时唤醒,或interrupt wait 超时唤醒,或notify/notifyAll 5.线程状态不同 sleep(time): TIMED_WAITING wait(time) TIMED_WAITING /wait() WAITING 6.线程在哪里 sleep:等待CPU调度器的“定时等待队列”中 wait: 对象头的监视器中的等待池“wait set”
198. join和yield区别
main(){ a.join(); b.join(); } join是加入线程,当前的线程main要等待调用join的线程a,b死亡或超时。用于线程同步(等我做完了你再执行)
yield让出自己的CPU时间片给同级别的其他线程,但是CPU的调度器可能会忽视你的yield(提示性,并非强制)
199. notify和notifyAll区别
notify随机唤醒监视器_WaitSet中的一个线程 notifyAll唤醒所有等待池中的线程,把这些线程都移入到锁池(EntryList)
//被唤醒的线程要去抢锁,加入到_EntryList中等待抢锁
synchronized(lock){
this.notifyAll(); //Set
// this.wait(); // 各自线程中wait // this.wait(); // this.wait(); } 99%的场景使用notifyAll()
数据结构: _WaitSet: 循环双向链表 _EntryList:双向链表
200. 一个线程结束后可以再次执行start吗?
不可以。 一个Thread只能被start一次,如果再次执行start就会抛异常 IllegalThreadStateException。(源码中告诉我们一个新的线程的threadStatus=0,一旦执行过start这个值就会被VM修改,而且不可逆)
Java线程设计状态是单项流转:NEW->RUNNABLE->TERMINATED(终点) 没有复活机制的。
201. 线程编排
1.创建
CompletableFuture
2.回调/消费 thenApply / thenApplyAsync异步版本 映射T->U thenAccept/ thenAcceptAsync 消费T,无返回 thenRun / thenRunAsync 只运行,无返回
3.批量 allOf() 等待所有任务执行完 anyOf() 等待任意一个任务执行完
4.阻塞操作 get() 获取返回值,检测异常 join() 获取返回结果,不检测异常
5.异常处理 exceptionally 异常执行 handle 失败或者成功都处理 whenComplete 类似finally都完成了执行
202. 方法相关
203. 线程隔离
隔离是为了线程之间数据被污染,要隔离 ThreadLocal可以干这件事,每个线程中都有一个副本,不是传递而是隔离,ThreadLocal副作用是可能会产生内存泄漏,key是弱引用 value强引用
引用类型:
1.强:只要还用着就不会释放
2.软:内存不足OOM之前 OutOfMemory
3.弱:下一次GC发生,所有的弱引用都会被放着WeakHashMap中, 但是特殊情况:String s= “hello” //hello在常量池
WeakReference
GC: majorGC: (major主要的) 老年代GC minorGC:(minor次要的)新生代(Eden+Survior区) fullGC: (全堆GC) 整个堆+元空间/永久代(框架class)
204. 线程传参的特殊案例
@Data public class User{ private String name; }
user.setName(“zs”);
new Thread(()->{ public void run(){ user.setName(“lisi”); } }).start();
Thread.sleep(100);
String name = user.getName(); // 问name现在是zs还是lisi? ①zs,因为主线程zs,子线程lisi,分别执行在自己的线程内,CPU缓存区,如果两个线程是由2个内核分别执行,分别把zs和lisi缓存在自己内核中,那么主线程可能拿到的还是zs ②lisi,主线程和子线程使用的是同一个CPU缓存,那么主线程拿到的就是lisi 解决方案是 ①使用volatile关键字修饰name ②User类定义为Record不可变对象 ③加锁使用 ④AtomicReference原子引用类
205. 线程终止的方式
一 线程业务 1.过期处理 (永远不要使用此方式,会把共享对象的状态处于不一致的情况) stop() 停止 -> resume(); 停止,suspend()挂起给唤醒以后停止 2.线程的interrupt() + isInterrupted()检测 捕获异常 3.使用volatile关键字+标志位 volatile flag=true; // 监听标志位 new Thread(()->{ while(flag){…} }).start(); // 改标志位 new Thread(()->{… flag=false;}).start();
二 线程池 shutdown() 停止
三 IO阻塞 可以使用定时器线程,倒计时,到时间以后ioStream.close() /socket.close()
四 守护线程的自动消亡 thread.setDaemon(true) 主线程执行完后不会等待守护线程
206. 死锁的四个条件
必须条件: 1.互斥 2.保持并请求 3.不可剥夺 4.循环等待
解决:打破2,3,4必要条件 2.保持并请求 ① 一次性请求所有的锁 (实际比较困难) ② 在你请求锁前,释放你持有的锁 3.不可剥夺 使用tryLock尝试获取,抢不到就不抢了 4.循环等待 按顺序加锁
207. 7个核心参数
1.核心线程数 2.最大线程数 3.空闲时间 4.空闲时间单位 5.等待队列线程池工厂 6.线程工厂 7.拒绝策略
工作流程: 1.开始线程池是空的 2.任务来 -> 创建线程到核心线程数 3.核心满了 -> 等待队列 4.队列满了 -> 最大线程数 5.最大线程数满了 -> 拒绝策略处理
208. 4个拒绝策略
AbortPolicy(中止策略)—— 默认行为,快速失败 抛异常,丢弃任务
CallerRunsPolicy(调用者运行策略)—— 生产环境最推荐 不丢也不抛异常,任务从哪来回它的调用者线程去执行
DiscardPolicy(丢弃策略)—— 静默杀手,极不推荐 啥也不干,直接丢,也不抛异常,不记录日志
DiscardOldestPolicy(丢弃最老策略)—— 最冤枉的策略 丢弃等待最久的任务,尝试提交当前新任务
大厂必杀: 自定义策略:目标任务持久化+补偿重试 1.任务存入redis/mysql 持久化了 2.记录失败日志,触发告警 3.启动一个补偿线程来执行任务,稍后重试
209. 4个等待队列
ArrayBlockingQueue:有界队列 LinkedBlockingQueue:链表队列,可选有界/无界 SynchronousQueue:同步移交队列 (没有容量,放一个拿一个) PriorityBlockingQueue:优先级队列,无界堆结构,按优先级排序 DelayedWorkQueue用户处理ScheduledThreadPoolExecutor定时任务的内部专属队列
210. 线程数到底应该多少
CPU密集型任务(加密/解密/大量数学运算) 核心=CPU内核数+1 (服务器挂了20个CPU/16核 = 320+1) 最大=CPU内核数+1 (服务器挂了20个CPU/16核 = 320+1)
IO密集型任务(文件,IO,数据库读写多) 核心=2CPU内核数 (640) 最大=4CPU内核数 (1280)
大厂公式: 核心=CPU核心/(1-阻塞系数),比如阻塞系数0.8,4个内核20个线程
理想化公式: 最佳线程数 = CPU核心数 × (1 + 线程等待时间 / 线程计算时间)
面试题: 核心线程数,最大线程数的指标如何得到的? 压力测试/冒烟测试等根据流量来得到的最佳值,而且不同的业务类型匹配不同的策略
211. ConcurrentHashMap的原理
ConcurrentHashMap的原理
JDK7:segment锁段+Lock
主要组成:主要是由分段锁(Segment)和链表数组(Entry[])组成,Segment 本质上是一个 “子哈希表”,它继承自 ReentrantLock(可重入锁),因此每个 Segment 自身就是一把锁。将整个存储空间分成多个段Segment,每个段都维护着一个独立的链表数组。每个段都拥有自己的锁,因此不同的线程可以同时对不同的段进行操作,从而实现并发访问。
访问流程:当一个线程需要访问某个元素时,首先需要根据元素的哈希值定位到对应的段,然后获取该段的锁。获取锁后,线程会在该段对应的链表上进行插入、删除或者查找操作。这样做的好处是,不同线程对于不同段的操作不会相互阻塞,提高了并发性能。
缺点:并没有解决并发访问时链表造成的性能问题。当多个线程同时修改同一个段的链表时,可能会导致链表成为热点,并发性能下降
JDK8:;它摒弃了Segment(锁段)的概念,利用 volatile + CAS 实现;JDK8还引入了Node 和 TreeBin 来表示键值对的存储。Node 是链表节点,TreeBin 是红黑树节点。这些节点都通过 CAS(Compare and Swap) 操作来保证并发安全性。
扩容机制:JDK8还引入了一种新的扩容机制,使用了无锁算法来提高并发性能。同HashMap
ForwardingNode 节点:表示这个桶的数据已经全部搬迁完毕了。其哈希值固定为 -1。应用场景:在多线程协同扩容(Help Transfer)**时,线程每迁移完一个桶,就会在老数组对应位置放一个 ForwardingNode。
ReservationNode 节点:一个临时的“哨兵”锁定节点。其哈希值固定为 -3。作用:在执行计算函数的耗时期间,先往空桶里塞入这个节点占位。防止其他线程趁虚而入抢写这个空桶,保证了原子性计算的绝对安全。
212. 线程安全
213. JUC辅助类
214. 锁降级
从写锁降级成为读锁。在当前线程拥有写锁的情况下,再次获取到读锁,随后释放写锁的过程。 获取写锁->获取读锁->释放写锁->释放读锁 在获取读锁后直接释放写锁 对于ReentrantReadWriteLock,支持锁降级,不支持锁升级。不可以在读锁没有关闭的情况直接上写锁。
215. 阻塞队列
阻塞队列主要在生产者/消费者的场景使用 当一个线程试图对一个已经满了的队列进行入队列操作时,它将会被阻塞,除非有另一个线程做了出队列操作;同样,当一个线程试图对一个空队列进行出队列操作时,它将会被阻塞,除非有另一个线程进行了入队列操作
1.ArrayBlockingQueue:由数组结构组成的有界阻塞队列 2.LinkedBlockingQueue: 由链表结构组成的有界阻塞队列 3.PriorityBlockingQueue: 支持优先级排序的无界阻塞队列 4.DelayQueue:使用优先级队列实现的延迟无界阻塞队列 5.SynchronousQueue:不存储元素的阻塞队列,也叫做单个元素队列 6.LinkedTransferQueue:有链表组成的无界阻塞队列
216. CAS
CAS: compare and swap 比较并交换 CAS主要是用来保证原子性的技术,基于乐观锁实现的
CAS操作主要有3个参数: 内存地址A, 旧值B,新值C 将指定内存A的内容 跟 旧值B 进行一个比较, 如果相等,则替换为 C, 如果不等,自旋。
CAS底层采用 native方法(C/C++来实现的),具体为 sun.misc.Unsafe 类,他的操作是原子性的,CAS只能保证单个变量的原子性,如果同时修改多个字段,就不能直接用CAS,此时可以用AtomicReference包装一个不可变对象,通过 CAS 整体替换
副作用: 1.ABA问题: 场景: 线程 P1 读取变量值为 A。 P1 被切换出去,线程 P2 将 A 改成 B,又改回 A。 P1 回来继续执行,发现值还是 A,CAS 成功。 针对这种情况,可以采取 加版本号(或者时间戳)
2.自旋开销 CAS失败后, 他就会进行 循环处理(自旋), 产生极大开销 解决方案: 升级为锁, 极端竞争场景下, 先内部进行CAS乐观尝试,失败后,此时坚持无锁CAS就是负优化,之后让线程挂起等待(阻塞),让出CPU给其他真正干活的线程,整体效率更高, 不是一上来就是挂起的,有过程: 偏向锁-> 轻量级锁(自旋)->重量级锁(挂起)
217. AQS
一、AQS是什么 AbstractQueuedSynchronizer,抽象队列同步器,是用来构建锁或其他同步组件的基础框架,核心思想:用一个 volatile int state 表示同步状态,通过一个内置的 FIFO 双向队列 管理等待线程,使用 CAS 原子修改状态。
二、核心三要素 state: volatile int,表示同步状态(锁是否被持有、信号量剩余许可数等),通过 getState(), setState(), compareAndSetState() 操作。
CLH 队列变种: 一个虚拟的双向链表,存放获取锁失败的线程;头节点是当前持有锁的线程,新节点通过 CAS 插入队尾。
CAS 操作:修改 state 的唯一途径,配合自旋实现无锁队列操作。
三、state 核心同步状态变量,volatile保证多线程间变量可见性; 不同同步器语义不同; ReentrantLock:state=0 无锁,>0 代表锁重入次数; Semaphore:state 代表剩余许可数量; CountDownLatch:state 代表剩余需要倒数的次数。
四、等待队列: 存放竞争资源失败、需要阻塞等待的线程,是FIFO 双向阻塞队列,底层由 Node 节点构成,包含 4 个关键点: ①Node 节点双向链表 ②Node 内部存储: ③head:持有资源或哨兵节点 ④tail:新节点入队位置
五、设计模式(模板方法模式) AQS 采用模板方法模式,父类定义完整获取 / 释放锁流程,子类只需要实现差异化逻辑,包含 3 个关键点: ①AQS 定义通用模板 AQS 提供acquire()、release()、acquireShared()、releaseShared()等final 模板方法,封装完整流程:竞争 state → 失败入队阻塞 → 唤醒后重试竞争 → 释放资源唤醒后继,流程固定不可重写。 ②子类实现钩子方法 AQS 定义空的抽象钩子方法,由子类重写实现自身同步逻辑: 独占:tryAcquire(int arg)、tryRelease(int arg); 共享:tryAcquireShared(int arg)、tryReleaseShared(int arg)。 tryAcquire/tryRelease 等 ③tryAcquire/tryRelease 等 核心子类钩子方法: tryAcquire:尝试独占获取资源,返回 true 代表抢占成功; tryRelease:尝试独占释放资源,返回 true 代表释放后需要唤醒后继线程; 共享配套tryAcquireShared/tryReleaseShared,适用于信号量、倒计时门栓。
六、工作流程 ①线程调用锁的lock()/acquire(),执行 AQS 模板方法; ②调用子类tryAcquire,通过 CAS 修改 state 竞争资源: 成功:直接执行业务代码; 失败:封装线程为 Node,CAS 插入等待队列 tail 尾部; ③队列内线程循环阻塞,等待前驱节点释放资源唤醒; ④线程释放锁时调用release(),子类tryRelease修改 state; ⑤state 释放完成后,唤醒 head 后继等待节点,被唤醒线程重新竞争 state。
七、 两种资源共享模式 独占模式(Exclusive):只有一个线程能获取资源。如 ReentrantLock。
共享模式(Share):多个线程可同时获取资源。如 Semaphore, CountDownLatch, ReadLock。
可同时存在(如 ReentrantReadWriteLock:写锁独占,读锁共享)。
218. 锁
219. 并发容器
220. volatile关键字
三大特性: 1.可见性:对 volatile 变量的写操作会立即刷新到主内存,读操作会从主内存读取最新值,保证一个线程修改后其他线程立即可见 2.禁止指令重排序:volatile 变量前后加内存屏障,防止编译器和 CPU 对指令重新排序,保证代码执行顺序与书写顺序一致 3.不保证原子性:volatile 只保证单次读/写的原子性,但不保证复合操作(如 i++)的原子性
核心用法: 1.状态标志位:用于线程间共享的布尔状态变量.控制线程停止 2.双重检查锁(DCL)单例:配合 synchronized 实现懒加载单例模式,防止指令重排序导致的未初始化对象引用 3.轻量级读多写少场景
内存屏障(底层原理): volatile 通过插入内存屏障实现 1.写屏障:在 volatile 写之后插入,强制将写缓冲区刷新到主内存 2.读屏障:在 volatile 读之前插入,强制使本地缓存失效,从主内存重新读取 3.禁止重排序屏障:在 volatile 变量操作前后插入屏障,阻止特定类型的指令重排序
注意事项: 1.不适用于 i++ 等复合操作 2.不能修饰数组元素:volatile修饰数组时,只保证数组引用可见,不保证数组元素可见 3.不保证最终一致性:写操作无法回滚,不适合事务性场景 4.性能开销:仍存在一定的开销(禁止缓存优化、内存屏障),比普通变量慢,但比 synchronized 快 5.64位变量特殊注意:对 long和 double 的读写本身可能分两次 32 位操作,但 JVM 规范保证 volatile 修饰的 64 位变量读写是原子操作
221. CopyOnwriteArraylist的原理
设计思想:读写分离,写时复制 CopyOnWriteArrayList 1.每次对集合进行写操作,不会对原容器进行修改,会复制一份副本,对副本进行写操作,再将容器的引用指向新副本;读操作时访问原来的容器 核心原则:读无锁,写加锁;读快写慢;最终一致性 2.技术细节 底层维护了一个不可变的数组(用volatile)private transient volatile Object[] array;
迭代器(弱一致性)迭代的是快照,所以迭代过程中新增删除的元素不会被迭代到 试用场景 1.读操作多于写操作 2.允许读取到旧数据(最终一致性即可) 3.不需要高并发写操作,且数组元素数量不宜过多(避免复制开销和内存占用过大)。
222. 原子类
JUC原子类位于atomic包下,是Java并发编程中无锁并发的核心工具,解决多线程下基本数据类型、引用类型、数组、对象字段的复合赋值操作线程安全问题,全程无锁、自旋重试,保证操作的原子性、可见性、有序性
底层实现: 所有JUC原子类的底层核心均为CAS + volatile关键字
总体架构: 1.原子类: 无锁原子操作,保证线程安全
2.锁: 显式锁,提供比 synchronized 更灵活的锁机制
3.同步工具: 线程间协调与通信
4.线程池: 管理线程生命周复用期,线程资源
5.阻塞队列: 线程安全的生产者-消费者队列
6.并发集合: 线程安全的容器
7.Fork/Join: 分治并行计算框架
原子类整体分类:
- 基本类型原子类*:操作基本数据类型数值
- 数组类型原子类:操作数组中元素的数值
- 引用类型原子类:操作对象引用,实现对象整体原子更新
- 对象字段原子更新器:精准更新对象的某个成员字段,节省内存
- 累加器/计数器原子类(JDK8+):高并发场景专用高性能计数器
优点:
- 无锁操作,不触发线程阻塞、上下文切换,并发性能优异;
- 基于CAS自旋重试,线程活跃度高,响应速度快;
- 使用简单,无需手动加锁解锁,线程安全不易出错。
缺点:
- 高并发竞争激烈时,CAS自旋会消耗大量CPU资源;
- 仅支持单个变量原子操作,无法实现多变量复合原子逻辑;
- 基础原子类存在ABA问题,需额外使用带版本戳的原子类解决;
- LongAdder等累加器不保证实时数据精准性。
高频面试核心要点
- 原子类底层是CAS+volatile,非锁机制属于乐观锁 2.CAS三大问题:CPU自旋、多变量不支持、ABA 3.JDK8 LongAdder分段锁思想是高并发计数最优方案 4.原子类仅保证操作原子性,不保证业务整体事务一致性,复杂并发场景仍需锁
223. JMM
一、JMM是什么 JMM,Java内存模型,抽象规范,屏蔽硬件差异,定义共享变量的访问规则
二、三大问题 可见性:一个线程的修改,另一个线程能立即看到。 有序性:指令重排导致多线程执行顺序错乱。 原子性:非 JMM 核心目标,但 JMM 规定了基本原子操作范围。
三、内存抽象结构
主内存:共享变量存储区。
工作内存:线程私有,持有变量副本
线程操作变量必须经过主内存↔工作内存的交互。
两个规定:
- 线程对共享内存的所有操作都必须在自己的工作内存中进行,不能直接从主内存中读写;
- 不同线程无法直接访问其他线程工作内存中的变量,因此共享变量的值传递需要通过主内存完成。
四. Happens-Before 规则 JMM 判定数据竞争和排序的核心依据 程序次序规则 监视器锁规则 volatile 变量规则 传递性 A hb B, B hb C ⇒ A hb C。 start() 规则 join() 规则 线程中断规则 对象终结规则
五. 两个核心关键字 volatile:保证可见性 + 禁止指令重排(通过内存屏障)。不保证原子性。典型用法:状态标志、DCL 单例。 synchronized(锁):同时保证原子性、可见性、有序性。释放锁时刷新主内存,获取锁时清空工作内存。
六、关键内存屏障 volatile用到 4 种屏障,理解“写后刷新、读前失效”即可 StoreStore、StoreLoad、LoadLoad、LoadStore。(store:写,load:读 ) volatile 写插入 StoreStore + StoreLoad;volatile 读插入 LoadLoad + LoadStore。
七、一个经典案例:DCL 单例为什么要 volatile private volatile static Singleton instance; 防止 instance = new Singleton() 被重排为“先分配内存引用,后初始化对象”,导致其他线程拿到未完成的对象
224. 虚拟线程(Virtual Threads)
225. HashMap原理
1.基本定义 HashMAP:是基于哈希表的 Map 接口实现,存储键值对(Key-Value)数据结构,允许 null 键和 null 值
HahMap底层就是通过一个数组,来储存我们所有的元素。数组初始大小为16,也可以通过new HashMap的时候指定大小。
JDK7是entry对象;JDK8是node对象
四个属性:hash,key,value,next(当前元素指向下一个元素的指针)
影响hash性能原因1 哈希算法的优劣2 加载因子的大小3 碰撞后的处理方式
升级;条件:只有当前链表长度达到8个,数组长度达到64个才会升级,
扩容:条件:链表长度到达八个,数组长度未达64。 这时,再往链表长度为8的桶上放元素,就会进行扩容,或者到达扩容阈值(默认12),就是达到数组长度*加载因子(默认0.75),具体是老数组长度翻一倍形成新数组
扩容机制:JDK1.7:hash值重新取模你的新数组长度,就是rehash,优点:分布均匀;JDK1.8会通过位运算符跟老数组长度进行运算,如果等于16,认为是高位元素,小于16就算低位元素,地位元素会保留原来位置,高位元素是元位置加上扩容的的长度,优点:性能高一点)
降级:从红黑树降到链表:当 HashMap 进行翻倍扩容时,原本挂在同一个红黑树下的节点会被重新分配(Rehash)到新数组的高位桶和低位桶中: 拆分结果:一棵树会被拆分成两条新的节点链(低位链、高位链)。 退化判定:拆分后,如果其中某一条链上的节点数量 小于等于 6(UNTREEIFY_THRESHOLD = 6),那么这个分支就不会再保持红黑树结构,而是直接调用 untreeify() 方法,退化还原为普通的单向链表。
在“删除元素(remove())”时 如果您不断地从 HashMap 中 remove 元素,导致原本已经是红黑树的桶(Bucket)里的节点越来越少,红黑树也会触发退化。
JDK 1.7:并发扩容时采用头插法,会颠倒原有链表的顺序。多线程同时扩容时,极易形成环形链表(死循环),导致下一次 get() 时 CPU 直接飙死到 100%。 JDK 1.8:改用尾插法,保持了链表的原有相对顺序,彻底解决了死循环问题。
特殊的 null 键存放位置 当 Key 为 null 时,它的 hash 值被硬编码强制设为 0。因此,null 键对应的节点永远固定存放在数组的第一个位置(即 table[0] 的桶里)。
226. 线程同步
线程同步:用来控制多个线程访问共享资源的“先后顺序”和“动作时序”,从而保证程序在并发环境下能得出正确的结果 1.sync锁 方法1:使用synchronized代码块: 语法结构: synchronized(同步监视器){ 同步代码 } 同步监视器:1.引用类型 2.可以改变锁对象的值,不能改变引用,可以final修饰锁 3.String和包装类不能用 最好用共享资源做锁对象 同步代码块中能发生CPU切换吗?能 但是后续的被执行的线程也无法执行同步代码块(锁仍旧close)
方法2:使用synchronized方法: 用锁把整个方法锁住 synchronized实现同步的基础:Java中的每一个对象都可以作为锁。具体表现为以下3种形式:
- 对于普通同步方法,锁是当前实例对象this。
- 对于静态同步方法,锁是当前类的Class对象。
- 对于同步方法块,锁是synchonized括号里配置的对象
2.lock:三个实现:ReentrantLock、ReentrantReadWriteLock.ReadLock、ReentrantReadWriteLock.WriteLock Lock接口里获取锁的方法: lock()\unlock:获取锁,已被获取需要等待,,需要主动释放锁,将释放锁的操作放在finally块中进行,以保证锁一定被被释放,防止死锁. trylock():有返回值Boolean,表示尝试获取锁,不会一直等待 tryLock(long time, TimeUnit unit)拿不到锁时会等待一定的时间,在时间期限之内如果还拿不到锁,就返回false。如果如果一开始拿到锁或者在等待期间内拿到了锁,则返回true lockInterruptibly():通过这个方法去获取锁时,如果线程正在等待获取锁,则这个线程能够响应中断,即中断线程的等待状态
ReentrantLock可重入锁: ReentrantLock内部维持一个锁的计数器,初始值为0。每次执行lock()后,计数加1,每次执行unlock()时计数减1。可以通过ReentrantLock的getHoldCount()获取当前计数器的值
ReentrantReadWriteLock读写锁:针对这种读多写少 读写锁允许同一时刻被多个读线程访问,但是在写线程访问时,所有的读线程和其他的写线程都会被阻塞 从一个ReadWriteLock中多次获取的ReadLock、WriteLock是同一把读锁,同一把写锁,都是重入锁,读共享,写独占
227. 线程通信
线程通信:多个线程间怎么把活干完 1.生产者与消费者;wait(),notify()唤醒 1)先线程同步,再通信 2)生产者消费者被wait()阻塞,被唤醒是从wait()下继续执行,不是从同步块开始
多个线程出现的问题 虚假唤醒:唤醒条件没满足,但是唤醒了 原因: 1.if进行判断 解决方法:while循环 2.notify()生产后又生产,消费后又消费(生消在同一队列等待) 解决方法:notifyAll() 法2:lock接口里newCondition(),Condition接口里有await(),signal(), signalAll()更加清楚的控制多线程的休眠和唤醒。 对于同一个锁;可以定义不同的conditon,在不同的情况下用不同的conditon。 一个condition包含一个等待队列。 调用await(),signal(),signalAll()需要在lock的临界区里
228. CountDownLatch
核心:一等多
CountDown是计数递减的意思,Latch是门闩的意思,CountDownLatch是一个非常实用的多线程控制工具类,底层是基于AQS实现
工作流程:它内部维护一个递减的计数器,比如刚开始有n个门闩,当它递减到0的时候就会阻塞执行后续的操作
常用方法: 1.new CountDownLatch(int count) 实例化一个倒计数器,count指定初始计数 2.countDown() 每调用一次,计数减一 3.getCount() 获取当前计数器的值 4.await(时间) 等待,当计数减到0时,阻塞线程并行执行
注意事项: countDown() 方法应在 finally 块中调用,以确保即使在任务执行异常时也能递减计数器,避免主线程永远阻塞
优点:
1.解耦灵活:不关心谁调用countDown(),任意线程或外部事件都可触发,无需持有具体线程引用
2.支持使用线程池
3.超时控制:await(timeout) 避免永久阻塞,支持超时降级处理。
4.同时唤醒多个线程:所有等待线程在计数器归零时被一次性唤醒
5.轻量高效:底层基于AQS实现
缺点; 1.不可重置:门闩只能使用一次 2.无法获取已完成数量:无法查询已有多少个任务完成,只能获取剩余计数 3.不区分完成状态:无法知道哪些任务成功、哪些失败,只能知道“计数归零”这一事件 4.线程中断不自动递减:等待线程被中断时,计数器不会自动减少,需业务代码自行处理
面试:CountDownLatch 与 join 方法的区别
CountDownLatch 等待的是计数器归零这一事件,解耦灵活,支持线程池和超时,但不可重置。 join()等待的是具体线程对象死亡,必须持有线程引用,只能等线程结束,不支持线程池,但可多次调用等待不同线程
229. CyclicBarrier
核心:多等多
这个类的中文意思是“循环栅栏”。意思就是一个可循环利用的屏障,它的主要作用是在多个线程相互等待达到某个共同点之后再一起继续执行
它内部也有一个计数器,初始值是在构造时指定。CyclicBarrier 是一个同步辅助类,通常用于协调多个线程之间的任务分配和执行
核心方法: 1.CyclicBarrier(int parties):构造方法,指定需要等待的线程数量 2.await():当前线程到达屏障点并等待,直到所有线程都到达 3.wait(long timeout, TimeUnit unit):带超时的等待,超时后抛出 TimeoutException,同时屏障被破坏 4.reset():手动重置屏障到初始状态,正在等待的线程会抛出 BrokenBarrierException 5.getNumberWaiting():获取当前正在屏障处等待的线程数 6.isBroken():判断屏障是否被破坏
使用场景: 1.并行计算分阶段汇总:多个子线程各自计算一部分,全部到达屏障后由屏障动作汇总结果,然后继续下一阶段计算 2.多线程分步处理:将一个大任务拆分为多个阶段,每个阶段所有线程完成后再进入下一阶段
特点: 1.可重用:计数器归零后自动重置,可反复使用,适合分阶段任务 2.屏障动作:最后一个到达的线程负责执行预定义的 Runnable,可用于聚合结果或执行收尾操作 3.互相等待:所有线程都在等待彼此,任何一个线程在等待过程中被中断或超时,屏障会被标记为“破坏”(broken),其他线程会抛出 BrokenBarrierException 4.基于 ReentrantLock + Condition实现
注意事项: 1.线程数必须匹配:await() 调用次数必须达到 parties 值,否则所有线程永久阻塞 2.屏障破坏处理:当某个线程在 await()时被中断或超时,屏障进入“broken”状态, reset()恢复
230. Semaphore
核心:限制并发数量
CountDownLatch和CyclicBarrier的计数器递减的,而Semaphore的计数器是既可以递增也可以递减,并可指定计数器的初始值
Semaphore可以控制同时访问的线程个数。非常适合需求量大,而资源又很紧张的情况。底层是基于AQS实现的
核心方法: 1.Semaphore(int permits, boolean fair):构造方法,permits指定初始许可证数量 ,fair指定公平/非公平锁, true 代表公平锁,false 代表非公平锁 ,默认是非公平锁 2.acquire():获取一个许可证,若无则阻塞 ,里面可以放数字 3.release():归还一个许可证 ,里面可以放数字 4.tryAcquire():尝试获取,成功返回 true,失败立即返回 false(不阻塞) ,里面可以放时间以及时间单位
使用场景: 1.数据库连接池限流:控制最大并发连接数 2.接口限流/QPS控制:限制同时处理请求数,保证系统不会被压垮 3.多资源并发访问控制:限制同时访问某个共享资源的线程数量
注意事项: 1.许可证归还必须匹配:release() 次数必须等于 acquire() 次数,否则许可证数量会逐渐累积或耗尽 2.finally 块释放:确保获取许可证后一定释放,避免泄漏 3.批量获取需谨慎:acquire(10)要求一次性获取 10 个许可证,若不足则阻塞,可能降低并发度。通常用单个许可证循环获取更灵活
231. 虚拟线程的价值
虚拟线程Java21 推出的JVM 轻量级线程,由 JVM 自己管理,在java中线程跟系统线程是一一对应的。不跟操作系统内核线程一对一绑定;少量操作系统真实线程,就能承载几十万、上百万虚拟线程。在jdk21升级之后是最重要的一个功能。
核心价值
-
抹平并发编程复杂度
不用再手动调线程池核心数、队列、拒绝策略,不用 CompletableFuture、响应式编程(Reactor/RxJava)就能轻松实现十万、百万级并发,保持同步阻塞编码习惯。
-
大幅提升 IO 密集型服务吞吐量
数据库、RPC、HTTP、消息队列等等待型业务,传统平台线程受操作系统线程上限限制,虚拟线程几乎无数量瓶颈。
-
降低高并发系统运维成本 省去线程池参数调优、线程泄露排查、阻塞线程耗尽等线上故障;栈追踪、ThreadLocal、同步锁
4.统一同步编程范式,抛弃响应式学习成本
传统高并发两条路:
- 线程池同步:并发量上不去;
- 响应式异步:代码晦涩、调试难、学习成本极高;
232. 相关面试题
233. 有了虚拟线程还需要线程池嘛
先说结论:不能完全替代,两种线程池依然必不可少
使用场景 虚拟线程:Web 接口、RPC 调用、DB 查询、文件 IO、批量推送等 IO 密集业务
平台线程池:大数据计算、加密、循环运算、离线同步等 CPU 密集任务、需要限流场景
二者最佳搭配方案 接口、RPC、数据库查询(IO 密集):用虚拟线程执行器,简化开发,提升吞吐量
234. 基本类型原子类
核心类:AtomicInteger、AtomicLong、AtomicBoolean,仅支持int、long、boolean三种基本类型。
核心方法: 1.get():获取当前最新值 2.set():直接设置新值(非原子,不推荐并发使用) 3.getAndIncrement():先获取值,再自增(等价于i++,原子操作) 4.incrementAndGet():先自增,再获取值(等价于++i,原子操作) 5.getAndDecrement()/decrementAndGet():原子自减操作 5.compareAndSet(int expect, int update):核心CAS方法,预期值匹配则原子更新 6.getAndAdd()/addAndGet():原子累加指定数值
235. 数组类型原子类
核心类:AtomicIntegerArray、AtomicLongArray、AtomicReferenceArray
作用:实现数组单个元素的原子更新,数组整体不保证线程安全,仅针对下标元素操作原子。
特点:无需遍历加锁,可精准对数组指定下标元素做原子增减、更新操作,并发处理数组数据效率更高
236. 引用类型原子类
核心类:AtomicReference、AtomicStampedReference、AtomicMarkableReference
AtomicReference:通用对象引用原子类,实现任意对象引用的CAS更新,仅对比引用地址,无法解决ABA问题。 -AtomicStampedReference:带版本戳的引用原子类,通过「引用值+版本号」双重校验,彻底解决ABA问题,每次更新版本号自增。 AtomicMarkableReference:带标记位的引用原子类,通过布尔标记位记录对象是否被修改,无需记录版本次数,节省内存,仅判断状态不判断次数。
237. 对象字段原子更新器
核心类:AtomicIntegerFieldUpdater、AtomicLongFieldUpdater、AtomicReferenceFieldUpdater
作用:动态更新普通对象的volatile成员字段,无需创建原子类对象,直接操作原有对象字段,节省内存开销。
使用硬性条件:
- 被更新字段必须被volatile*修饰
- 字段必须是非static、非final
- 字段访问权限需匹配(通常为public)
适用场景:对象仅个别字段需要并发更新,无需整体原子包装,轻量化并发场景
238. 累加器/计数器原子类
核心类:LongAdder、DoubleAdder、LongAccumulator、DoubleAccumulator
作用:解决AtomicLong高并发下CAS自旋频繁、CPU消耗高的问题,是超高并发计数器的最优选择
核心原理: 分段累加 摒弃单一value变量,将数据拆分到多个Cell数组分段存储,多线程并发修改不同Cell,减少CAS竞争;最终汇总所有Cell值得到最终结果,大幅提升并发吞吐量。
239. 理解虚拟线程
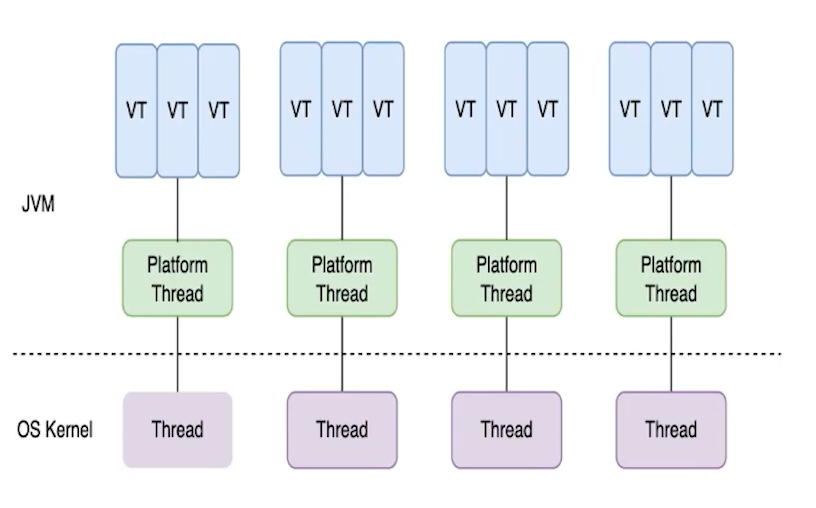
案例,学校接到一个任务写一万份学生评语,传统的Thread的线程一个任务交给一个人干,现在有了虚拟线程然后把任务分发成一个个小任务,每个学生老师都分一部分任务。如果有人干不了的话就换其他人去干,对外还是一个任务。
虚拟线程
底层:图结构底层:OS 内核线程(紫色框)= 工厂真实工位
-
机器 CPU 只认它,操作系统给工位分配干活时间;
-
工位成本极高,工厂不能随便建几百上千个,一般就几十个、几百个封顶;
-
一个工位同一时间只能有 1 个人干活。 中层:Platform 平台线程(绿色框 = 载体)= 固定工人
-
每个工人永久占一个工位,1 个人绑定 1 个工位;
-
传统代码就是直接让这些工人干业务:
工人去仓库拿货(IO / 查数据库)等待的时候,工位空着也没法给别人用,纯浪费。
上层:VT 虚拟线程(浅蓝色)= 无数张任务工单
- 工单超级轻,打印一张几乎不花钱,想印十万张都没问题;
- 工单本身不能直接上工位干活,必须交给中层固定工人拿着工单去工位执行。
240. 虚拟线程执行器算不算线程池?和传统线程池差异
算特殊调度器,但和线程池完全不同:
-
不复用虚拟线程,每条任务新建 VT,用完销毁;仅复用底层载体
-
无并发上限,无核心 / 最大线程、队列、拒绝策略配置
-
虚拟线程执行器:每提交一个任务,新建一条独立虚拟线程,执行完毕直接销毁,不存在线程复用、无核心 / 最大线程概念,没有池化复用逻辑。
-
传统线程池:复用固定数量平台线程,主动限制并发,线程是池内资源,反复回收复用,有最大容量限制
241. 同步锁和Lock锁
一、JVM级别的锁 二、JDKAPI级别的锁 同步锁(synchronized) Lock锁 可重入锁 可重入锁 隐式锁 显式锁 取决于JVM底层的实现,不灵活 可以提供多种锁方案供选择,更灵活 发生异常会自动释放锁 发生异常不会自动释放锁,需要在finally中释放锁 独占锁 WriteLock 独占锁 ReadLock 共享锁 同步监视器对象头里面的markword字段 底层是AQS(state属性+双向链表) 可以锁方法、可以锁代码块 只可以锁代码块 仅支持非公平锁 可支持公平锁、非公平锁
242. 锁升级
sync锁在JDK1.6之前是重量级锁,之后引入了如下锁 其中偏向锁在JDK15之后被淘汰 锁升级不可逆,只能升级不能降级
无锁(001) 对象刚被创建时,没有线程对其进行同步访问时的状态。
偏向锁(101) 只有一个线程访问同步资源 修改对象头的MarkWord 标志位,并写入线程ID
轻量级锁(00) 轻度竞争,自旋锁 使用CAS尝试将MarkWord中的所标志位修改为00,如果成功则获得锁,反之自旋
重量级锁(10) 重度竞争、操作系统内核态、Monitor对象及其等待队列、阻塞 多个线程同时激烈竞争同步资源时,从轻量级锁升级为重量级锁, 对象头的 MarkWord 会指向一个 “重量级锁对象(Monitor)”。 未获取到锁的线程会被阻塞(进入操作系统内核态),放入 Monitor 的等待队列 直到持有锁的线程释放锁后,由操作系统唤醒队列中的线程重新竞争。
243. 平台线程和虚拟线程的核心区别
核心区别
-
映射:平台 1:1 绑定 OS 内核线程;虚拟 M:N 动态复用载体 M:N就是多条虚拟线程共享少量 OS 平台线程;虚拟线程阻塞时让出载体,载体去执行其他就绪虚拟线程。
-
资源:平台栈固定 1MB、重量级;虚拟栈动态伸缩、百万级无 OOM
-
阻塞:平台阻塞占死 OS 线程;虚拟阻塞释放载体线程
-
数量:平台上限几千;虚拟支持数十万、百万级
244. 锁的分类
JVM级别的锁 同步锁(synchronized) 无锁、偏向锁、轻量级锁、重量级锁
自旋锁
循环+不阻塞=自旋,CAS 就是典型自旋
自旋次数:一、jdk1.6之前是默认10次
二、jdk1.6及以后是自适应策略动态变化 决策由上一次历史决定,若上一次成功,本次会增加自旋次数,若上次失败,则会减少自旋,甚至跳过自旋升级为重量级锁
可重入锁 定义:同一把锁可以使用多次。比如说多层同步块使用同一把锁。 基于 AQS 的state字段。state=0无锁,同一线程加锁 state++,释放 state—。
公平锁 定义:线程严格按照请求顺序获取锁,先到先得。 AQS 中维护 CLH 队列,新线程必须检查是否有前驱节点,有则入队等待,不会尝试抢锁。
非公平锁 定义:新线程允许在释放锁的瞬间直接抢锁(插队),不必先入队。 先进行抢锁,抢锁失败后到队列中排队
独占锁 定义:同一时刻仅允许一个线程持有。 synchronized ReentrantLock WriteLock
共享锁 定义:多个线程可以同时持有,只要没有写操作。 特性:允许多个读线程并发,提升读多写少性能。 ReadLock
悲观锁
定义:总是假设最坏情况,认为冲突一定会发生,访问资源前先加锁。
synchronized、ReentrantLock、ReentrantReadWriteLock
先锁后操作。
乐观锁 定义:假设冲突很少,直接操作,提交时再检查冲突,失败则重试或回滚。 无锁化,高并发下避免阻塞。 先操作后检查。
245. 虚拟线程的优缺点
虚拟线程优点
- IO 场景吞吐量大幅提升,无线程数量瓶颈
- 同步编码,无需回调 / 响应式,改造成本极低
- 零参数配置,不用调试线程池参数
- 内存开销极小,硬件资源利用率更高
虚拟线程的缺点
- 不适合 CPU 密集型任务
- 原生未改造的 native 阻塞方法不会释放载体,丧失优势
- 无线程优先级,JVM 会忽略设置
- ThreadLocal 极易内存泄漏,推荐 ScopedValue 替代
- 无内置限流,突发流量会打垮下游服务
246. ThreadLocal 在虚拟线程有什么坑?怎么解决?
坑:VT 可达百万级,每个线程持有大对象会造成严重内存泄漏。 方案:
- 使用完手动 remove ();
- Java21 配套 ScopedValue;
247. 代码
248. EntryList和CLH变种双向队列的区别是什么
EntryList CLH
所属 同步sync的monitor JUC并发包
代码 C++ Java
数据结构 双向链表 双向链表
并发控制 操作系统的互斥量+线程阻塞 CAS自旋+unpark/park
线程状态不同 BLOCKED WAITING/TIMED_WAITING
公平 不公平 都可
四、IO、网络与工具
249. IO流分类
IO流根据流向有输入流和输出流两种:读是输入,写是输出,输入输出不是针对数据源,而是针对内存 空间 IO流根据类型分类有字节流和字符流:字节流是万能流,可以处理任意的文件。字符流不是万能流,基本 上用来处理纯文本文件 IO流程根据功能特征分类有节点流和包装流:节点流负责和底层数据源交互,包装流负责增强功能 流的四个抽象顶级类: 字节输入流 InputStream 字节输出流 OutputStream 字符输入流 Reader 字符输出流 Writer 备注:流的设计遵循 “装饰者模式”:处理流包裹节点流,增强功能(缓冲、转换、序列化)。
250. Java五种文件拷贝方式
在 Java 中,文件拷贝主要有以下几种方式,不同场景下效率差异显著。以下从实现方式、效率对比和适 用场景三方面详细解析:
1)、文件拷贝的 5 种实现方式
- 传统字节流拷贝FileOutputStream 特点:基础方法,直接逐字节或缓冲区读写。 效率:最低(适合小文件)。
- 缓冲流优化拷贝BufferedInputStream+BufferedOutputStream 特点:通过缓冲区减少 I/O 次数。 效率:比传统字节流提升 2~5 倍。
- NIO Files.copy方法(Java 7+) 特点:单行代码完成拷贝,底层自动优化。 效率:接近最高效(适合大多数场景)。
- NIO FileChannel 通道拷贝
publicstaticvoidmain(String[] args) throwsIOException {
try (InputStreamis=newFileInputStream("source.txt");
OutputStreamos=newFileOutputStream("target.txt")) {
byte[] buffer=newbyte[1024];
intlength;
while ((length=is.read(buffer)) >0) {
os.write(buffer, 0, length);
}
}
}
1
2
3
4
5
6
7
8
9
10
publicstaticvoidmain(String[] args) throwsIOException {
try (BufferedInputStreambis=newBufferedInputStream(new
FileInputStream("source.txt"));
BufferedOutputStreambos=newBufferedOutputStream(new
FileOutputStream("target.txt"))) {
byte[] buffer=newbyte[8192]; // 缓冲区越大,性能越好(通常 8KB~64KB)
intlen;
while ((len=bis.read(buffer)) !=-1) {
bos.write(buffer, 0, len);
}
}
}
1
2
3
4
5
6
7
8
9
10
publicstaticvoidmain(String[] args) throwsIOException {
Pathsource=Paths.get("source.txt");
Pathtarget=Paths.get("target.txt");
Files.copy(source, target, StandardCopyOption.REPLACE_EXISTING);
}
1
2
3
4
5
方法
耗时(毫秒)
适用场景
传统字节流
45005000
小文件(<10MB)
缓冲流
12001500
通用场景
Files.copy800~1000 简单代码 + 快速开发
FileChannel.transfer600800
大文件(>100MB)
内存映射文件
500700
超大文件(>1GB)
特点:利用通道(Channel)直接传输数据。
效率:大文件性能最佳(利用零拷贝技术)。
251. 内存映射文件拷贝MappedByteBuffer
特点:将文件映射到内存直接操作。 效率:适合超大文件(但实现复杂,需谨慎处理内存)。
2)、效率对比(1GB 文件测试)
3)、如何选择最高效方式?
- 小文件(<10MB) 直接使用Files.copy ,代码简洁且性能足够。
- 大文件(100MB~1GB) 优先选择FileChannel.transferTo() ,利用零拷贝减少内核态与用户态数据复制。
- 超大文件(>1GB)用内存映射文件(MappedByteBuffer ),但需注意:
publicstaticvoidmain(String[] args) throwsIOException {
try (FileChannelsourceChannel=new
FileInputStream("source.txt").getChannel();
FileChanneltargetChannel=new
FileOutputStream("target.txt").getChannel()) {
sourceChannel.transferTo(0, sourceChannel.size(), targetChannel);
}
}
1
2
3
4
5
6
publicstaticvoidmain(String[] args) throwsIOException {
try (RandomAccessFilesourceFile=newRandomAccessFile("source.txt",
"r");
RandomAccessFiletargetFile=newRandomAccessFile("target.txt",
"rw")) {
FileChannelsourceChannel=sourceFile.getChannel();
MappedByteBufferbuffer=
sourceChannel.map(FileChannel.MapMode.READ_ONLY, 0, sourceChannel.size());
targetFile.getChannel().write(buffer);
}
}
1
2
3
4
5
6
7
8
避免频繁映射/释放内存(开销大)。
处理内存溢出风险(OutOfMemoryError )。- 通用场景 Files.copy或缓冲流,平衡代码可读性与性能。
4)、终极建议
优先使用Files.copy :Java 7+ 自带优化,简单高效。 大文件必用FileChannel`:性能碾压传统流。 避免手动逐字节读写:除非处理特殊格式(如加密流)。
252. BIO、NIO、AIO 之间的区别
1).BIO (Blocking I/O)
BIO 属于同步阻塞 IO 模型。 同步阻塞 IO 模型中,应用程序发起 read 调用后,会一直阻塞,直到内核把数据拷贝到用户空间。 在客户端连接数量不高的情况下,是没问题的。但是,当面对十万甚至百万级连接的时候,传统的 BIO 模型是无能为力的。因此,我们需要一种更高效的 I/O 处理模型来应对更高的并发量。
2).NIO (Non-blocking/New I/O)
Java 中的 NIO 于 Java 1.4 中引入,对应 java.nio 包,提供了 Channel , Selector,Buffer 等抽象类。 NIO 中的 N 可以理解为 Non-blocking,不单纯是 New。它是支持面向缓冲的,基于通道的 I/O 操作方 法。对于高负载、高并发的(网络)应用,应使用 NIO 。 Java 中的 NIO 可以看作是 I/O 多路复用模型。也有很多人认为,Java 中的 NIO 属于同步非阻塞 IO 模 型。 跟着我的思路往下看看,相信你会得到答案! 我们先来看看同步非阻塞 IO 模型。 同步非阻塞 IO 模型中,应用程序会一直发起 read 调用,等待数据从内核空间拷贝到用户空间的这段时 间里,线程依然是阻塞的,直到内核把数据拷贝到用户空间。 相比于同步阻塞 IO 模型,同步非阻塞 IO 模型确实有了很大改进。通过轮询操作,避免了一直阻塞。 但是,这种 IO 模型同样存在问题:应用程序不断进行 I/O 系统调用轮询数据是否已经准备好的过程是十 分消耗 CPU 资源的。 这个时候,I/O 多路复用模型就上场了。 IO 多路复用模型中,线程首先发起 select 调用,询问内核数据是否准备就绪,等内核把数据准备好了, 用户线程再发起 read 调用。 read 调用的过程(数据从内核空间 -> 用户空间)还是阻塞的。 目前支持 IO 多路复用的系统调用,有 select,epoll 等等。select 系统调用,目前几乎在所有的操 作系统上都有支持。 select 调用:内核提供的系统调用,它支持一次查询多个系统调用的可用状态。几乎所有的操 作系统都支持。 epoll 调用:linux 2.6 内核,属于 select 调用的增强版本,优化了 IO 的执行效率。
IO多路复用模型,通过减少无效的系统调用,减少了对 CPU 资源的消耗。
Java 中的 NIO ,有一个非常重要的选择器 ( Selector ) 的概念,也可以被称为多路复用器。通过它,只 需要一个线程便可以管理多个客户端连接。当客户端数据到了之后,才会为其服务。 Buffer、Channel和Selector三者之间的关系如下:
3).AIO (Asynchronous I/O)
AIO 也就是 NIO 2。Java 7 中引入了 NIO 的改进版 NIO 2,它是异步 IO 模型。 异步 IO 是基于事件和回调机制实现的,也就是应用操作之后会直接返回,不会堵塞在那里,当后台处理 完成,操作系统会通知相应的线程进行后续的操作。 总结:最后,来一张图,简单总结一下 Java 中的 BIO、NIO、AIO。
253. 谈谈你对Java序列化的理解
1).什么是序列化和反序列化?
序列化:将 Java 对象转换为字节流(如保存到文件或通过网络传输)。 反序列化:将字节流还原为 Java 对象。 序列化的核心是让对象能够在非 Java 环境(如文件、数据库、网络)中存储或传输。
Java的序列化是指将Java对象转换为字节流的过程,可以将这些字节流保存到文件中或通过网络传输。
反序列化则是指将字节流恢复成对象的过程。
序列化的主要目的是实现对象的持久化存储和传输,让对象可以在不同的计算机或不同的时间点被重建 和使用。通过序列化,可以将对象的状态以字节的形式保存下来,并且在需要的时候进行恢复,从而实 现了对象的跨平台传输和持久化存储。 在Java中,要使一个类可序列化,需要满足以下条件:
- 实现java.io.Serializable接口,该接口是一个标记接口,没有任何方法。
- 所有的非静态、非瞬态的字段都可以被序列化。 使用Java的序列化机制,可以通过ObjectOutputStream将对象转换为字节流并写入文件或网络流中。反 之,通过ObjectInputStream可以从字节流中读取数据并还原为对象。 需要注意的是,在进行序列化和反序列化时,对象的类和字段的定义必须保持一致,否则可能会导致序 列化版本不匹配或字段丢失的问题。
2).如何实现序列化和反序列化?
Java 提供了Serializable接口,用于标记需要序列化的类。 序列化底层原理:ObjectStreamClass类中可以看到writeObjectMethod属性,值来自对象 writeObject方法 反序列化底层原理:ObjectStreamClass类中可以看到readObjectMethod属性,值来自对象 readObject方法
/**
* @Auth:TianMing
* @Description:基本应用
*/
importjava.io.*;
publicclassSerializationExampleimplementsSerializable {
privatestaticfinallongserialVersionUID=1L; // 序列化版本号
privateStringname;
privatetransientintage; // transient 关键字表示该字段不参与序列化
// 构造方法、getter 和 setter 略
publicstaticvoidmain(String[] args) {
SerializationExampleobj=newSerializationExample();
obj.setName("张三");
obj.setAge(25);
// 序列化
try (ObjectOutputStreamoos=newObjectOutputStream(new
FileOutputStream("object.ser"))) {
oos.writeObject(obj);
System.out.println("对象已序列化");
} catch (IOExceptione) {
e.printStackTrace();
}
// 反序列化
try (ObjectInputStreamois=newObjectInputStream(new
FileInputStream("object.ser"))) {
SerializationExamplenewObj= (SerializationExample)
ois.readObject();
System.out.println("对象已反序列化: "+newObj.getName());
// 注意:transient 字段会被还原为默认值(这里是 0)
System.out.println("年龄: "+newObj.getAge());
} catch (IOException|ClassNotFoundExceptione) {
e.printStackTrace();
}
}
}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
自行编写readObject()函数,用于对象的反序列化构造,从而提供约束性。可以自定义反序列化对象的 校验信息
3).序列化和反序列化的注意事项
3.1 transient关键字transient修饰的字段不会被序列化。 反序列化时,transient字段会被还原为默认值(如int为0 ,String为null )。
3.2 serialVersionUIDserialVersionUID是序列化版本号,用于标识类的版本。 如果类的结构发生变化(如新增字段或修改字段类型),serialVersionUID不匹配会导致反序 列化失败。 最好显式声明serialVersionUID ,否则编译器会自动生成一个,但容易导致版本不一致。 3.3 静态字段 静态字段不会被序列化,因为它们属于类而不是对象。
4).序列化和反序列化的安全性问题
序列化和反序列化存在安全风险,尤其是反序列化时: 反序列化恶意数据可能导致代码执行或数据泄露。 面试官可能会问你如何避免这些问题。 解决方法:
- 自定义readObject 和writeObject方法**:
在类中覆盖readObject和writeObject方法,验证数据的合法性。- 重写代码
- 使用安全的序列化框架: 避免使用 Java 默认的序列化机制,改用更安全的框架(如 Protobuf、Kryo)。
- 避免敏感数据参与序列化: 使用transient修饰敏感字段,确保它们不被序列化。
/**
* @Auth:TianMing
* @Description:安全性
*/
privatevoidreadObject(ObjectInputStreamois) throwsIOException,
ClassNotFoundException {
ois.defaultReadObject();
// 验证数据
if (name==null) {
thrownewInvalidObjectException("name 不能为空");
}
}
1
2
3
4
5
6
7
8
9
10
11
5).序列化和反序列化的性能优化
Java 的默认序列化机制效率较低,可以通过以下方式优化:
1. 使用**Externalizable** ** 接口**:
Externalizable是Serializable的子接口,允许自定义序列化逻辑。
通过实现writeExternal和readExternal方法,可以减少序列化数据的大小。- 使用高效的序列化库: Protobuf:Google 开发的高效序列化框架,支持跨语言。 Kryo:轻量级、高性能的序列化框架。 FST:快速、紧凑的序列化库。
6).面试常见问题
问题 1:为什么需要序列化?
答案:序列化可以将对象转换为字节流,方便存储或传输。例如,将对象保存到文件、通过网络发 送对象、在分布式系统中传递对象。 问题 2:transient和static字段为什么不参与序列化? 答案:transient表示字段不参与序列化,static字段属于类而不是对象,因此也不参与序列 化。 问题 3:serialVersionUID的作用是什么?
答案:serialVersionUID用于标识类的版本。如果类的结构发生变化,serialVersionUID不匹配会导致反序列化失败。
问题 4:如何提高序列化的性能?
答案:可以使用Externalizable接口自定义序列化逻辑,或者使用高效的序列化库(如 Protobuf、Kryo)。
问题 5:序列化和反序列化有哪些安全问题?
答案:反序列化恶意数据可能导致代码执行或数据泄露。 如何防止反序列化破坏单例模式的对象呢?可以通过重写readObject方法或者readResolve 方法、使用安全的序列化框架、避免敏感数据参与序列化来解决。
问题 6:追问又来了,上面的readObject和 readResolve方法有啥区别呢?
示例 1:重写readObject方法
importjava.io.*;
/**
* @Auth:TianMing
* @Description: readObject
*/
publicclassSingletonimplementsSerializable {
privatestaticfinallongserialVersionUID=1L;
privatestaticfinalSingletonINSTANCE=newSingleton();
// 私有构造方法,防止外部实例化
privateSingleton() {
// 防止反射破坏单例
1
2
3
4
5
6
7
8
9
10
11
12
示例 2:使用readResolve()方法
if (INSTANCE!=null) {
thrownewIllegalStateException("Already instantiated");
}
}
// 提供获取实例的方法
publicstaticSingletongetInstance() {
returnINSTANCE;
}
// 重写 readObject 方法,阻止反序列化
privatevoidreadObject(ObjectInputStreamois) throwsIOException,
ClassNotFoundException {
thrownewIOException("Singleton cannot be deserialized");
}
publicstaticvoidmain(String[] args) {
Singletoninstance1=Singleton.getInstance();
// 尝试序列化和反序列化
try (ObjectOutputStreamoos=newObjectOutputStream(new
FileOutputStream("singleton.ser"))) {
oos.writeObject(instance1);
} catch (IOExceptione) {
e.printStackTrace();
}
try (ObjectInputStreamois=newObjectInputStream(new
FileInputStream("singleton.ser"))) {
Singletoninstance2= (Singleton) ois.readObject();
System.out.println(instance1==instance2); // false,因为
readObject 抛出了异常
} catch (IOException|ClassNotFoundExceptione) {
e.printStackTrace();
}
}
}
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
importjava.io.*;
/**
* @Auth:TianMing
* @Description: readResolve
*/
publicclassSingletonimplementsSerializable {
privatestaticfinallongserialVersionUID=1L;
privatestaticfinalSingletonINSTANCE=newSingleton();
// 私有构造方法,防止外部实例化
privateSingleton() {
// 防止反射破坏单例
if (INSTANCE!=null) {
thrownewIllegalStateException("Already instantiated");
}
}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
readObject方法:适合用来阻止反序列化或验证对象状态。 readResolve()方法:适合用来确保反序列化后返回的是单例的唯一实例。 两种方法的区别
readObject 方法:
是ObjectInputStream的方法,用于自定义反序列化逻辑。
适合用来验证对象的状态或直接阻止反序列化。
readResolve() 方法:是一个特殊的钩子方法,用于在反序列化完成后返回一个对象。 适合用来确保返回的是单例的唯一实例。
7).总结
序列化:将对象转换为字节流。 反序列化:将字节流还原为对象。
注意事项:transient 、serialVersionUID 、静态字段。安全性:避免反序列化恶意数据,使用安全的序列化框架。 性能优化:使用Externalizable或高效的序列化库。 掌握这些知识点后,你可以在面试中自信地回答序列化和反序列化相关的问题!如果还有其他疑问,可 以继续提问。 // 提供获取实例的方法
publicstaticSingletongetInstance() {
returnINSTANCE;
}
// 使用 readResolve 方法,确保返回的是单例的唯一实例
privateObjectreadResolve() {
returnINSTANCE;
}
publicstaticvoidmain(String[] args) {
Singletoninstance1=Singleton.getInstance();
// 尝试序列化和反序列化
try (ObjectOutputStreamoos=newObjectOutputStream(new
FileOutputStream("singleton.ser"))) {
oos.writeObject(instance1);
} catch (IOExceptione) {
e.printStackTrace();
}
try (ObjectInputStreamois=newObjectInputStream(new
FileInputStream("singleton.ser"))) {
Singletoninstance2= (Singleton) ois.readObject();
System.out.println(instance1==instance2); // true,因为
readResolve 返回了 INSTANCE
} catch (IOException|ClassNotFoundExceptione) {
e.printStackTrace();
}
}
}
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
254. IP地址和端口号
• IP地址:用来标志网络中的一个通信实体的地址。通信实体可以是计算机,路由器等。 • IP地址分类 – IPV4:32位地址,以点分十进制表示,如192.168.0.1 – IPV6:128位(16个字节)写成8个16位的无符号整数,每个整数用四个十六进制位表示,数之间用冒 号(:)分开,如:3ffe:3201:1401:1280:c8ff:fe4d:db39:1984 • 特殊的IP地址 – 127.0.0.1 本机地址 – 192.168.0.0—192.168.255.255私有地址,属于非注册地址,专门为组织机构内部使用。 • 端口:port – IP地址用来标志一台计算机,但是一台计算机上可能提供多种应用程序,使用端口来区分这些应用程 序。 – 端口是虚拟的概念,并不是说在主机上真的有若干个端口。通过端口,可以在一个主机上运行多个网 络应用程序。 – 端口范围0---65535,16位整数 • 端口分类 – 公认端口 0—1023 比如80端口分配给WWW,21端口分配给FTP,22端口分配给SSH,23端口分配给 telnet,25端口分配给smtp – 注册端口 1024—49151 分配给用户进程或应用程序 – 动态/私有端口 49152—65535 • 理解IP和端口的关系 – IP地址好比每个人的地址(门牌号),端口好比是房间号。必须同时指定IP地址和端口号才能够正确的 发送数据 – IP地址好比为电话号码,而端口号就好比为分机号。
255. ISO/OSI参考模型和TCP/IP 参考模型
OSI(Open System Interconnection),开放式系统互联参考模型。是一个逻辑上的定义,一个规 范,它把网络协议从逻辑上分为了7层。每一层都有相关、相对应的物理设备,比如常规的路由器 是三层交换设备,常规的交换机是二层交换设备。OSI七层模型是一种框架性的设计方法,建立七 层模型的主要目的是为解决异种网络互连时所遇到的兼容性问题,其最主要的功能就是帮助不同类 型的主机实现数据传输。它的最大优点是将服务、接口和协议这三个概念明确地区分开来,通过七 个层次化的结构模型使不同的系统不同的网络之间实现可靠的通讯。 TCP/IP协议是Internet最基本的协议、Internet国际互联网络的基础,主要由网络层的IP协议和传 输层的TCP协议组成。TCP/IP 定义了电子设备如何连入因特网,以及数据如何在它们之间传输的标 准。协议采用了4层的层级结构,每一层都呼叫它的下一层所提供的协议来完成自己的需求。 ISO制定的OSI参考模型的过于庞大、复杂招致了许多批评。伴随着互联网的流行,其本身所采用的 TCP/IP协议栈获得了更为广泛的应用和认可。在TCP/IP参考模型中,去掉了OSI参考模型中的会话 层和表示层(这两层的功能被合并到应用层实现)。同时将OSI参考模型中的数据链路层和物理层 合并为主机到网络层。
256. TCP 协议和 UDP 协议的比较
TCP 和 UDP 是 TCP/IP 协议栈中传输层的两个核心协议,它们基于 IP 层的路由功能将数据包发送到目 的主机,为应用层协议(如 HTTP、SMTP、SNMP、FTP、Telnet 等)提供端到端的传输服务。 TCP 的服务器与客户端之间通信,就好比两个人打电话,需要先建立连接、确认对方在线,才能开始对 话,因此通信时需要指定双方的 IP 地址和端口号。 UDP 的服务器与客户端之间通信,则更像两个人互相发送信件。发送方只需要知道对方的地址,就可以 直接将信件发出,无需提前建立连接,也无法保证对方一定能收到。 TCP 面向虚电路,UDP 面向数据报,二者的核心区别,本质上就是虚电路服务与数据报服务的区别。 具体区别如下: TCP 是面向连接的传输协议;UDP 是无连接的传输协议。 TCP 提供流量控制、拥塞控制,并保证数据按序到达、不丢失、不重复;UDP 不提供这些机制。 TCP 在传输过程中,所有报文段沿着同一条路径传输;UDP 的每个数据报可独立选择路由。 TCP 是可靠传输协议,通过确认应答、超时重传、序列号校验等机制保证可靠性;UDP 是不可靠 传输协议,不保证数据一定送达。 UDP 头部开销小,无需建立连接和维护状态,因此传输速度更快、延迟更低。 TCP 适合传输数据量大、对可靠性要求高的场景;UDP 适合实时性要求高、可容忍少量丢包的场 景。
257. 什么是Socket
所谓 Socket(通常译作 “套接字”),是对网络中 IP 地址和端口号的抽象描述,本质是一个用于网络通 信的句柄(编程接口),应用程序通过 Socket 可以向网络发起请求,或响应来自网络的请求。 我们开发的网络应用程序位于 TCP/IP 协议栈的应用层,而 TCP、UDP 属于传输层协议。应用层程序要 调用传输层的通信能力,需要通过 Socket 作为 “中间层” 实现解耦 ——Socket 就像是传输层为应用层预 留的 “通信接口”,应用程序只需通过这个接口发送或接收数据,无需关心数据在接口之下的传输细节 (比如如何封装、路由、重传等),这些都由传输层、网络层等底层协议自动完成。 从协议栈交互的角度来说,Socket 是应用层与传输层之间的编程桥梁:传输层在网络层(IP 层)的基础 上,为应用层进程提供 “进程到进程” 的逻辑通信通道,而应用层进程正是通过 Socket 接口,借助 TCP/UDP 协议与另一台主机上的指定进程完成数据交互。 通过 Socket 编程,开发者可以开发客户端和服务器端的网络应用程序,既支持本地局域网内的进程通 信,也能基于互联网(Internet)实现跨地域的全球通信。
258. Netty
259. 为什么Netty适合做网络编程?
Netty是一个基于Java的高性能网络编程框架,它被广泛用于构建可扩展的、高性能的网络应用程序。以 下是一些原因说明为什么Netty适合做网络编程:
- 强大的抽象和组件:Netty提供了一组强大的抽象和可重用的组件,如事件模型、处理器链、编解 码器等。这些组件使得网络编程变得更加简单和灵活,开发者可以根据需求自由组合和定制。
- 高性能:Netty采用了基于事件驱动的异步非阻塞IO模型,利用了Java NIO(New IO)的特性,能 够处理大量的并发连接。它的线程模型和内存管理机制也经过优化,能够最大限度地提高网络应用 程序的性能和吞吐量。
- 完善的协议支持:Netty提供了丰富的协议支持,包括TCP、UDP、HTTP、WebSocket等。它内置 了许多常用的协议编解码器,可以轻松地进行协议的解析和编码,简化了网络应用程序的开发过 程。
- 可扩展性:Netty的设计非常灵活,支持自定义的协议、编解码器和处理器。它提供了丰富的扩展 点和钩子函数,可以方便地进行功能扩展和定制,满足各种复杂的业务需求。
- 成熟稳定:Netty是一个成熟稳定的开源项目,经过了广泛的实际应用和验证。它拥有活跃的社区 和强大的生态系统,提供了大量的文档、示例和工具,使得开发者能够快速上手并解决问题。 综上所述,Netty具有强大的抽象和组件、高性能、完善的协议支持、可扩展性和成熟稳定等特点,使其 成为一种优秀的选择用于网络编程。
260. Netty性能好的原因是什么?
Netty 是一个高性能的网络应用框架,其性能好的原因主要有以下几点:
- 异步非阻塞:Netty 使用异步非阻塞的 I/O 模型,可以处理大量的并发连接而不需要为每个连接分 配一个线程。这种模型减少了线程切换的开销,提高了系统的吞吐量和响应速度。
- 高度可定制化:Netty 提供了丰富的可定制化选项,可以根据应用的需求进行灵活的配置。开发者 可以自定义编解码器、处理器链、线程模型等,以适应不同的网络应用场景。
- 零拷贝:Netty 支持零拷贝技术,可以避免数据在内存之间的多次拷贝,减少了内存的使用和数据 传输的开销,提高了性能。
- 内存管理优化:Netty 使用了内存池技术,可以重用内存,减少了频繁的内存分配和回收操作,提 高了内存的利用率和性能。
- 模块化设计:Netty 的设计模块化,各个功能模块之间解耦,可以根据需要选择性地使用特定的模 块,避免了不必要的性能损耗。 总的来说,Netty 的高性能得益于其异步非阻塞的 I/O 模型、可定制化的设计、零拷贝技术、内存管理 优化和模块化架构等多个方面的优势。这些特性使得 Netty 成为开发高性能网络应用的理想选择。
261. Netty的零拷贝是怎么实现的?
Netty 实现零拷贝主要依赖于以下两个技术:
- 零拷贝文件传输:Netty 使用了操作系统提供的零拷贝机制,例如 Linux 下的 sendfile 和 splice 系 统调用。这些系统调用可以直接将文件数据从磁盘读取到网络套接字,或者从一个套接字传输到另 一个套接字,而无需经过用户空间和内核空间之间的数据拷贝。
- 零拷贝内存传输:Netty 使用了 Direct Memory Buffer(直接内存缓冲区)来实现零拷贝内存传 输。直接内存缓冲区是一种直接分配在堆外内存的缓冲区,可以通过操作系统的文件描述符直接读 写数据,避免了数据在用户空间和内核空间之间的拷贝。 通过使用这些零拷贝技术,Netty 在进行数据传输时可以避免将数据从一个缓冲区拷贝到另一个缓冲 区,从而减少了数据拷贝的次数和数据在内存之间的传输开销。这样可以提高数据传输的效率和性能。 需要注意的是,零拷贝并不是在所有情况下都能完全避免数据拷贝。在某些情况下,仍然需要进行少量 的数据拷贝操作,例如数据的解码和编码过程。但是相比传统的拷贝方式,Netty 的零拷贝机制可以最 大程度地减少数据拷贝的次数,提高了性能。
262. 能不能说一说Netty的无锁化设计?
Netty 的无锁化设计是指在多线程环境下,尽量减少对共享数据的锁使用,以避免锁竞争和线程阻塞, 从而提高系统的并发性能。Netty 在实现无锁化设计时主要采用了以下几种技术:
- 并发容器:Netty 使用了并发容器来替代传统的线程安全集合类。例如,使用 ConcurrentMap 替 代 HashMap,使用 ConcurrentLinkedQueue 替代 LinkedList,这些并发容器底层使用了 CAS (Compare and Swap)等无锁算法来实现线程安全。
- 原子操作:Netty 使用了原子操作来实现对共享数据的无锁访问。原子操作是一种不可中断的操 作,可以保证在多线程环境下对共享数据的操作是原子性的。Netty 使用了 Java 提供的原子类,如 AtomicBoolean、AtomicInteger 等,来实现无锁访问。
- 事件驱动模型:Netty 的核心思想是基于事件驱动的模型,通过事件的发布和订阅来实现线程间的 解耦和通信。这种模型避免了线程间的锁竞争,每个线程只需要处理自己感兴趣的事件,大大提高 了系统的并发性能。
- 非阻塞 I/O:Netty 使用了非阻塞的 I/O 模型,通过异步的方式处理网络 I/O 操作,避免了线程在 等待 I/O 完成时的阻塞,提高了系统的并发性能。 通过这些无锁化设计的技术手段,Netty 在多线程环境下能够更好地利用计算资源,提高系统的并发性 能和可伸缩性。同时,无锁化设计也减少了线程间的竞争和线程阻塞,避免了潜在的死锁和性能瓶颈问 题。
263. Netty的线程模型是怎么样的?
Netty的线程模型是基于事件驱动的,它采用了多线程池的架构来处理网络请求和事件。以下是Netty的 线程模型的主要特点:
- Boss线程池(Acceptors):这个线程池用于处理新的连接请求,通常会绑定到一个端口,并且负 责接受客户端的连接。每个Boss线程都会监听一个独立的套接字,用于接受客户端的连接请求。
- Worker线程池(EventLoopGroup):一旦连接建立,客户端的请求会被传递给Worker线程池 中的一个EventLoop进行处理。Worker线程池负责处理I/O事件,如读取和写入数据,以及执行用 户定义的业务逻辑。Netty通常会有多个Worker线程,每个线程都会处理多个连接,通过事件循环 (EventLoop)来处理这些连接上的事件。
- EventLoop(事件循环):每个Worker线程都包含一个EventLoop,它负责处理一个或多个连接 上的事件。EventLoop会持续地从事件队列中获取事件,然后执行相应的操作,比如读取数据、处 理请求、写入数据等。每个连接都会被分配到一个特定的EventLoop,确保了事件的顺序性和线程 的安全性。
- 任务队列:Netty使用任务队列来存储需要处理的事件,这些事件可以是读写操作、用户自定义的 任务或其他事件。这些事件会被EventLoop从队列中取出并执行。 总体来说,Netty的线程模型允许多个连接共享同一个线程,避免了线程创建和销毁的开销,提高了系统 的性能和效率。通过事件驱动的方式,Netty能够高效地处理大量的并发连接,适用于构建高性能、可扩 展的网络应用程序。需要注意的是,具体的线程数目和配置可以根据应用程序的需求进行调整。
264. Netty如何解决TCP粘包、拆包的问题的?
Netty提供了多种解决TCP粘包和拆包问题的机制,帮助开发者处理在网络传输过程中可能出现的数据分 片问题。这些机制可以确保数据在发送和接收时能够正确地分割和组装,从而避免粘包和拆包的困扰。 以下是Netty解决TCP粘包和拆包问题的一些常见方法:
- 固定长度解码器(FixedLengthFrameDecoder):这个解码器会根据指定的固定长度对接收到 的数据进行切割。无论数据内容如何,都会按照固定长度进行拆分,从而确保每个数据包的长度是 一致的。
- 行尾分隔符解码器(LineBasedFrameDecoder):适用于基于文本协议的场景,该解码器会根 据行尾分隔符(如换行符)将数据切分为不同的数据包。这样,每个数据包都会包含一行完整的文 本。
- 分隔符解码器(DelimiterBasedFrameDecoder):类似于行尾分隔符解码器,但可以自定义分 隔符。开发者可以指定特定的字节序列作为分隔符,用于切分数据。
- 自定义解码器:Netty还允许开发者根据具体的协议和业务需求创建自定义的解码器。这样可以更 灵活地处理数据的分割和组装。 这些解码器通常作为ChannelPipeline中的一部分,用于解决数据在网络传输过程中可能引发的粘包和拆 包问题。开发者可以根据自己的需求选择合适的解码器,或者结合多种解码器来处理不同类型的数据。 需要注意的是,虽然这些解码器可以很好地处理大部分粘包和拆包问题,但在一些复杂的情况下可能仍 需要开发者进行额外的处理和调优。
265. Netty的Buffer为什么好用
Netty的Buffer在网络编程中被认为非常好用,有以下几个方面的优势:
- 内存管理优化:Netty的Buffer实现了内存池技术,能够有效地管理内存的分配和释放。这可以减 少频繁的内存分配和垃圾回收,从而提高性能和减少延迟。
- 零拷贝技术:Netty的Buffer支持零拷贝(Zero-Copy)技术,这意味着在数据传输过程中可以避免 不必要的数据拷贝,减少了CPU和内存的负担,提高了数据传输的效率。
- 支持多种数据类型:Netty的Buffer提供了多种类型的Buffer,如堆内存缓冲区(Heap Buffer)和 直接内存缓冲区(Direct Buffer),可以根据需要选择合适的Buffer类型来优化性能。
- 灵活的API:Netty的Buffer提供了丰富的操作方法,可以轻松地进行数据读写、切片、复制等操 作,使得处理数据变得更加方便和灵活。
- 与ChannelPipeline集成:Netty的Buffer与ChannelPipeline紧密集成,可以方便地在不同的处理 器(如编码器、解码器、处理器等)之间传递数据,简化了数据处理的流程。
- 可扩展性和定制性:Netty允许开发者基于自己的需求扩展和定制Buffer的行为,从而实现更高级 别的功能和优化。 综上所述,Netty的Buffer在性能、内存管理、数据传输效率以及灵活性方面的优势,使得它成为了网络 编程中一个非常实用和强大的工具。无论是处理小规模数据还是大规模数据,Netty的Buffer都能够有效 地提升网络应用的性能和可靠性。
266. 说说 Netty 的对象池技术?
Netty的对象池技术是一种用于管理和重用对象的机制,旨在提高内存使用效率和性能。在网络编程中, 频繁地创建和销毁对象可能会导致内存碎片化和额外的垃圾回收开销,从而影响应用程序的性能。Netty 引入了对象池技术来缓解这些问题。 在Netty中,对象池主要用于管理两种类型的对象:ByteBuf(字节缓冲区)和ChannelHandlerContext (通道处理上下文)。以下是关于Netty对象池技术的一些关键点:
- ByteBuf对象池:Netty的ByteBuf是用于处理网络数据的字节缓冲区。通过使用ByteBuf对象池, Netty可以重用已经分配的字节缓冲区,避免频繁地创建和销毁这些对象。这有助于减少内存分配 和垃圾回收的开销,提高数据传输效率和应用程序性能。
- ChannelHandlerContext对象池:Netty中的ChannelHandlerContext代表了处理器(如编码 器、解码器、处理器等)与Channel之间的关联关系。通过使用ChannelHandlerContext对象池, Netty可以在数据处理过程中重用上下文对象,减少上下文对象的创建和销毁开销,从而提高数据 处理的效率。
- 资源回收和管理:Netty的对象池技术能够自动地管理对象的生命周期和资源回收。当对象不再需 要时,它们会被返回到对象池,以便稍后重用。这有助于避免内存泄漏和资源浪费。
- 配置和定制:Netty允许开发者根据应用程序的需求进行对象池的配置和定制。开发者可以设置池 的大小、对象的生存时间等参数,以适应不同的场景和负载。 综上所述,Netty的对象池技术是一项重要的功能,能够有效地提高网络应用程序的内存使用效率和性 能,特别是在处理大规模数据和高并发情况下。通过重用对象,Netty能够降低资源开销,提高数据传输 效率,并且在一定程度上减少内存碎片化问题。
267. Netty有哪些序列化协议?
Netty并不直接提供序列化协议,但它可以与各种序列化协议进行集成。序列化是将对象转换为可在网络 上传输或持久化存储的格式的过程。Netty可以与多种序列化协议一起使用,以根据应用程序的需要进行 数据的编码和解码。以下是一些常见的序列化协议,可以与Netty一起使用:
- Java自带的序列化(Java Serialization):Java自带了一套对象序列化机制,可以将Java对象转 换为字节流进行传输。但是,这种序列化方式在性能和灵活性方面可能存在问题,因此在高性能网 络应用中可能不是首选。
- JSON(JavaScript Object Notation):JSON是一种轻量级的数据交换格式,易于阅读和编写, 适用于各种编程语言。Netty可以与JSON库(如Jackson、Gson等)一起使用,将对象转换为JSON 格式进行传输。
- Protobuf(Protocol Buffers):Protobuf是一种由Google开发的高效的二进制序列化协议,具 有很高的性能和紧凑的数据表示。Netty可以与Protobuf集成,使用Protobuf生成的类来进行对象 的编码和解码。
- MessagePack:MessagePack是一种基于二进制的轻量级序列化格式,具有高性能和紧凑的数据 表示。它可以与Netty一起使用,实现数据的传输和解析。
- Thrift:Thrift是由Apache开发的一种跨语言的序列化协议,支持多种编程语言,并具有高性能和 可扩展性。Netty可以与Thrift一起使用,实现对象的序列化和反序列化。
- Avro:Avro是另一种由Apache开发的序列化框架,旨在提供紧凑的二进制格式和动态数据模型。 Netty可以与Avro一起使用,实现数据的编码和解码。 这些序列化协议可以根据应用程序的需求进行选择,根据性能、数据大小、跨语言支持等因素来决定使 用哪种协议。Netty的灵活性使得它能够与各种序列化协议集成,以实现高效的网络通信。
268. Netty 中用了哪些设计模式?
在Netty中使用了许多设计模式来实现高效的网络通信和处理。以下是一些Netty中使用的设计模式:
- 工厂模式(Factory Pattern):Netty使用工厂模式来创建不同类型的通道、处理器和其他组 件,隐藏了对象创建的细节,使代码更具可维护性和扩展性。
- 装饰器模式(Decorator Pattern):Netty的处理器链(Pipeline)机制使用了装饰器模式。每个 处理器都可以在收到数据、处理数据和传递数据时添加额外的逻辑,这使得用户可以轻松地定制数 据的处理流程。
- 观察者模式(Observer Pattern):Netty中的事件和事件监听器机制使用了观察者模式。通道状 态变化、数据读写等事件可以被观察,而用户可以注册相应的监听器来处理这些事件。
- 责任链模式(Chain of Responsibility Pattern):Netty的处理器链(Pipeline)本质上就是一 个责任链,每个处理器负责特定的任务,可以在链中按顺序处理数据,将复杂的处理逻辑拆分成独 立的模块。
- 单例模式(Singleton Pattern):Netty中的一些关键组件,如线程池、事件循环,都使用了单例 模式确保只有一个实例存在,从而节省资源并确保一致性。
- 模板方法模式(Template Method Pattern):Netty的一些类提供了模板方法,定义了通用的 处理流程和步骤,而将具体的实现细节留给子类来实现。
- 策略模式(Strategy Pattern):Netty中的一些组件,如编码器和解码器,可以根据不同的业务 需求进行替换,这种灵活性符合策略模式的思想。
- 适配器模式(Adapter Pattern):Netty中的适配器可以帮助用户将不同的数据格式、协议等转 换成统一的格式,以适应不同的通信需求。 这些设计模式的使用使得Netty能够提供高度灵活、高性能和可扩展的网络通信框架,满足各种不同应用 场景的需求。
269. Tomcat
270. Tomcat的缺省端口是多少,怎么修改?
默认端口为8080,可以通过在tomcat安装包conf目录下,service.xml中的Connector元素的port属性 来修改端口。
271. Tomcat有哪几种Connector 运行模式(优化)?
这三种模式的不同之处如下: BIO:一个线程处理一个请求。缺点:并发量高时,线程数较多,浪费资源。Tomcat7版本或更低版本 中,在Linux系统中默认使用这种方式。 NIO:利用Java的异步IO处理,可以通过少量的线程处理大量的请求。tomcat8.0.x中默认使用的是 NIO。Tomcat7必须修改Connector配置来启动: APR:即Apache Portable Runtime,从操作系统层面解决io阻塞问题。Tomcat7或Tomcat8在Win7或 以上的系统中启动默认使用这种方式。
272. Tomcat有几种部署方式?
利用Tomcat的自动部署:把web应用拷贝到webapps目录(生产环境不建议放在该目录中)。Tomcat 在启动时会加载目录下的应用,并将编译后的结果放入work目录下。 使用Manager App控制台部署:在tomcat主页点击“Manager App” 进入应用管理控制台,可以指定一 个web应用的路径或war文件。修改conf/server.xml文件部署:在server.xml文件中,增加Context节点 可以部署应用。 增加自定义的Web部署文件:在conf/Catalina/localhost/路径下增加 xyz.xml文件,内容是Context节 点,可以部署应用。
273. Tomcat容器是如何创建Servlet类实例?用到了什么原理?
当容器启动时,会读取在webapps目录下所有的web应用中的web.xml文件,然后对 xml文件进行解 析,并读取servlet注册信息。然后,将每个应用中注册的servlet类都进行加载,并通过反射的方式实例 化。(有时候也是在第一次请求时实例化)在servlet注册时加上1如果为正数,则在一开始就实例化, 如果不写或为负数,则第一次请求实例化。
<Connector port="8080" protocol="org.apache.coyote.http11.Http11NioProtocol"
connectionTimeout="20000" redirectPort="8443"/>
274. Tomcat如何优化?
tomcat作为Web服务器,它的处理性能直接关系到用户体验,下面是几种常见的优化措施: 掉对web.xml的监视,把jsp提前编辑成Servlet。有富余物理内存的情况,加大tomcat使用的jvm的内存 服务器所能提供CPU、内存、硬盘的性能对处理能力有决定性影响。 对于高并发情况下会有大量的运算,那么CPU的速度会直接影响到处理速度。内存在大量数据处理的情 况下,将会有较大的内存容量需求,可以用-Xmx -Xms -XX:MaxPermSize等参数对内存不同功能块进行 划分。我们之前就遇到过内存分配不足,导致虚拟机一直处于full GC,从而导致处理能力严重下降。硬 盘主要问题就是读写性能,当大量文件进行读写时,磁盘极容易成为性能瓶颈。最好的办法还是利用下 面提到的缓存。利用缓存和压缩 对于静态页面最好是能够缓存起来,这样就不必每次从磁盘上读。这里我们采用了Nginx作为缓存服务 器,将图片、css、js文件都进行了缓存,有效地减少了后端tomcat的访问。另外,为了能加快网络传输 速度,开启gzip压缩也是必不可少的。但考虑到tomcat已经需要处理很多东西了,所以把这个压缩的工 作就交给前端的Nginx来完成。除了文本可以用gzip压缩,其实很多图片也可以用图像处理工具预先进行 压缩,找到一个平衡点可以让画质损失很小而文件可以减小很多。曾经我就见过一个图片从300多kb压 缩到几十kb,自己几乎看不出来区别。采用集群 单个服务器性能总是有限的,最好的办法自然是实现横向扩展,那么组建tomcat集群是有效提升性能的 手段。我们还是采用了Nginx来作为请求分流的服务器,后端多个tomcat共享session来协同工作。 优化线程数优化 找到Connector port=“8080” protocol=“HTTP/1.1”,增加maxThreads和acceptCount属性(使 acceptCount大于等于maxThreads),如下: 其中: maxThreads:tomcat可用于请求处理的最大线程数,默认是200 minSpareThreads:tomcat初始线程 数,即最小空闲线程数 maxSpareThreads:tomcat最大空闲线程数,超过的会被关闭 acceptCount: 当所有可以使用的处理请求的线程数都被使用时,可以放到处理队列中的请求数,超过这个数的请求将 不予处理.默认100 使用线程池优化 在server.xml中增加executor节点,然后配置connector的executor属性,如下: 其中: namePrefix:线程池中线程的命名前缀 maxThreads:线程池的最大线程数 minSpareThreads:线程 池的最小空闲线程数 maxIdleTime:超过最小空闲线程数时,多的线程会等待这个时间长度,然后关闭 threadPriority:线程优先级 注:当tomcat并发用户量大的时候,单个jvm进程确实可能打开过多的文件句柄,这时会报 java.net.SocketException:Too many open files错误。可使用下面步骤检查:
<Connector port="8080" protocol="HTTP/1.1"connectionTimeout="20000"
redirectPort="8443"acceptCount="500" maxThreads="400" />
<Executor name="tomcatThreadPool" namePrefix="req-exec-"maxThreads="1000"
minSpareThreads="50"maxIdleTime="60000"/><Connector port="8080"
protocol="HTTP/1.1"executor="tomcatThreadPool"/>
ps -ef |grep Tomcat查看tomcat的进程ID,记录ID号,假设进程ID为10001 lsof -p 10001|wc -l 查看当 前进程id为10001的文件操作数使用命令:ulimit -a 查看每个用户允许打开的最大文件数 启动速度优化 删除没用的web应用:因为tomcat启动每次都会部署这些应用。关闭WebSocket:websocket-api.jar和 tomcat-websocket.jar。随机数优化:设置JVM参数:-Djava.security.egd=file:/dev/./urandom。内存 优化 因为tomcat启动起来后就是一个java进程,所以这块可以参照JVM部分的优化思路。堆内存相关参数, 比如说: -Xms:虚拟机初始化时的最小堆内存。 -Xmx:虚拟机可使用的最大堆内存。-Xms与-Xmx设成一样的值,避免JVM因为频繁的GC导致性能大起 大落 -XX:MaxNewSize:新生代占整个堆内存的最大值。 另外还有方法区参数调整(注意:JDK版本)、垃圾收集器等优化。JVM相关参数请看:手把手教你设置 JVM调优参数
275. 熟悉Tomcat的哪些配置?
Context(表示一个web应用程序,通常为WAR文件,关于WAR的具体信息见servlet规范)标签。 docBase:该web应用的文档基准目录(Document Base,也称为Context Root),或者是WAR文件的 路径。可以使绝对路径,也可以使用相对于context所属的Host的appBase路径。 path:表示此web应用程序的url的前缀,这样请求的url为http://localhost:8080/path/。 reloadable:这个属性非常重要,如果为true,则tomcat会自动检测应用程序的/WEB-INF/lib和/WEB- INF/classes目录的变化,自动装载新的应用程序,我们可以在不重启tomcat的情况下改变应用程序。 useNaming:如果希望Catalina为该web应用使用一个JNDI InitialContext对象,设为true。该 InitialialContext符合J2EE平台的约定,缺省值为true。 workDir:Context提供的临时目录的路径,用于servlet的临时读/写。利用 javax.servlet.context.tempdir属性,servlet可以访问该目录。如果没有指定,使用 $CATALINA_HOME/work下一个合适的目录。 swallowOutput:如果该值为true,System.out和System.err的输出被重定向到web应用的logger。如 果没有指定,缺省值为false debug:与这个Engine关联的Logger记录的调试信息的详细程度。数字越大,输出越详细。如果没有指 定,缺省为0。 host(表示一个虚拟主机)标签。 name:指定主机名。 appBase:应用程序基本目录,即存放应用程序的目录。 unpackWARs:如果为true,则tomcat会自动将WAR文件解压,否则不解压,直接从WAR文件中运行应 用程序。 Logger(表示日志,调试和错误信息)标签。 className:指定logger使用的类名,此类必须实现org.apache.catalina.Logger接口。 prefix:指定log文件的前缀。 suffix:指定log文件的后缀。 timestamp:如果为true,则log文件名中要加入时间,如下例:localhost_log.2001-10-04.txt。
276. 计算机网络
277. 介绍一下OSI七层模型?
当然,我很乐意为您介绍一下OSI七层模型。 OSI七层模型是一个用于描述计算机网络通信协议的框架,它由国际标准化组织(ISO)于1984年制定并 发布。该模型将网络通信过程分解为七个不同的层次,每个层次都负责特定的功能,从物理连接到应用 程序的交互,以实现数据在不同设备之间的传输和交换。以下是每个层次的简要介绍:
- 物理层(Physical Layer):这是最底层的层次,负责处理物理媒介和电信号传输。它定义了连 接硬件设备的标准,例如电缆类型、电压规范等。
- 数据链路层(Data Link Layer):此层负责在直接相连的两个设备之间传输数据帧,通过物理地 址(MAC地址)进行寻址和识别。它还处理错误检测和校正,确保可靠的数据传输。
- 网络层(Network Layer):网络层负责在不同网络之间路由数据包,通过IP地址进行寻址。它 处理数据包的传输路径选择和逻辑寻址,以实现跨网络的通信。
- 传输层(Transport Layer):传输层负责在端到端的通信中提供数据传输的可靠性和错误检测。 它管理数据的分段、传输控制、流量控制等,常见的传输层协议包括TCP(传输控制协议)和UDP (用户数据报协议)。
- 会话层(Session Layer):会话层负责建立、管理和终止应用程序之间的会话连接。它处理会话 的控制和同步,确保数据正确传输并在需要时进行恢复。
- 表示层(Presentation Layer):表示层负责数据的格式化、加密、压缩等处理,以确保不同系 统间数据的交换和解释能够无障碍地进行。
- 应用层(Application Layer):应用层是最顶层的层次,直接为用户提供网络服务和应用程序。 它包含了各种应用,如电子邮件、文件传输、远程访问等。 通过这种分层的方式,OSI模型帮助网络工程师和开发者更好地理解和设计网络协议、通信和应用。然 而,需要注意的是,实际网络协议不一定都严格按照这七层模型来设计,而是根据实际需求和技术进行 了调整和扩展。
278. 什么是TCP的粘包、拆包
TCP(Transmission Control Protocol)是一种常用的传输层协议,用于在计算机网络上可靠地传输数 据。在TCP通信中,粘包(Packet Sticking)和拆包(Packet Splitting)是两个可能出现的问题,涉及 到数据的传输和接收过程中的数据分割和组合。 粘包(Packet Sticking):粘包指的是在发送端将多个小数据包连续发送,而接收端却可能一次性接 收到了多个小数据包,这些数据包“粘”在一起,无法准确分辨出每个数据包的界限。这可能是因为发送 端的数据写入缓冲区比较快,而接收端读取数据的速度较慢,导致多个数据包被一次性读取。粘包会导 致接收端无法正确解析数据,从而影响数据的处理和解释。 拆包(Packet Splitting):拆包指的是在发送端将一个大数据包分割成多个小数据包发送,而接收端 却可能无法正确地将这些小数据包组合成完整的大数据包。这可能是因为发送端的数据分割不当,或者 接收端没有足够的信息来确定如何正确组合这些小数据包。拆包会导致接收端无法还原原始数据,从而 造成数据的错误或丢失。 为了解决粘包和拆包问题,通常需要在应用层设计一些协议或者采用一些技术手段,例如:
- 消息长度字段:在消息的开头加入一个固定长度的字段,用来表示后续消息的长度,接收端可以根 据这个字段来准确地分割和组合数据包。
- 消息分隔符:在消息的末尾加入一个特定的分隔符,接收端通过识别分隔符来分割数据包。
- 使用固定长度消息:将所有消息都固定到同样的长度,不足的部分用填充数据补齐。
- 应用层协议设计:在应用层定义明确的消息格式和协议,确保发送端和接收端都按照相同的规则进 行数据的分割和组合。 总之,处理粘包和拆包问题需要在应用层进行合适的设计和处理,以确保数据在传输过程中能够正确地 分割和组合,保证通信的可靠性和准确性。
279. ARP 与 RARP 的区别是什么?
ARP(Address Resolution Protocol)和RARP(Reverse Address Resolution Protocol)都是用于在网 络通信中解决IP地址和物理MAC地址之间映射关系的协议,但它们的功能和应用场景有所不同。
- ARP(Address Resolution Protocol): ARP用于将一个已知的IP地址解析成对应的物理MAC地 址。在一个局域网中,当主机需要与另一个主机通信时,它会先检查自己的ARP缓存表,看是否已 经有目标IP地址对应的MAC地址。如果没有,它就会发送一个ARP请求广播,询问局域网内是否有 响应该IP地址的主机。目标主机收到该请求后,会发送一个ARP响应,包含自己的MAC地址。这 样,请求主机就可以得到目标主机的MAC地址,从而建立通信。
- RARP(Reverse Address Resolution Protocol): RARP与ARP相反,它用于将已知的物理 MAC地址解析成对应的IP地址。主要应用于无盘工作站等设备,在启动时需要获取自己的IP地址, 但是这些设备没有预设IP地址,只有MAC地址。设备启动时会发送一个RARP请求广播,请求分配 一个IP地址。RARP服务器会收到请求后,查找MAC地址对应的IP地址,然后将IP地址发送回设备, 使设备能够配置自己的IP地址。 总结区别: ARP解析IP地址到MAC地址,而RARP解析MAC地址到IP地址。 ARP主要用于常规网络通信,而RARP主要用于无盘设备等特殊情况下的地址配置。 ARP请求由需要通信的主机发出,而RARP请求由需要获取IP地址的设备发出。 需要注意的是,随着网络技术的发展,ARP和RARP在现代网络中的使用逐渐减少,因为有更高级的技术 和协议来管理IP地址和MAC地址的映射关系,如DHCP(Dynamic Host Configuration Protocol)和 IPv6的邻居发现协议。
280. 路由器与交换机的区别是什么?
路由器(Router)和交换机(Switch)是网络中常见的两种设备,它们在网络中扮演不同的角色,有以 下区别:
- 功能与工作层次: 路由器:路由器位于网络的边缘,连接不同的网络或子网,主要负责在不同网络之间转发数据 包。它能够基于目标IP地址决定数据包的最佳路径,从而实现网络之间的通信。 交换机:交换机通常位于局域网(LAN)内部,它通过学习MAC地址来建立和维护一个MAC 地址表,然后根据MAC地址表将数据包直接从源端口转发到目标端口,从而实现局域网内部 设备之间的通信。
- 转发决策: 路由器:路由器通过查看数据包的目标IP地址来进行转发决策,选择最佳路径将数据包从一个 网络传送到另一个网络。 交换机:交换机通过查看数据包的源MAC地址来决定将数据包发送到哪个目标端口,以实现 局域网内部设备之间的直接通信。
- 广播域和碰撞域: 路由器:路由器能够隔离不同网络之间的广播域和碰撞域,这意味着在不同网络间的广播消息 不会被传播到其他网络。 交换机:交换机也能够隔离广播域,但在同一个交换机内部,所有设备共享一个碰撞域,因此 在交换机内部通信不会发生碰撞。
- 网络范围: 路由器:路由器通常用于连接不同的网络,可以跨越不同的物理位置和地理区域。 交换机:交换机通常用于连接同一局域网内的设备,限制在一个相对较小的网络范围内。 总之,路由器和交换机在网络中扮演不同的角色,分别用于实现不同的通信需求。路由器负责不同网络 之间的数据包转发,而交换机则负责同一网络内部设备之间的数据包交换。
281. 什么是TCP三次握手、四次挥手?
当然,我可以解释一下TCP三次握手和四次挥手的概念。 TCP三次握手: TCP三次握手是在建立TCP连接时使用的一种协议,用于确保客户端和服务器之间的通信能够稳定地开 始。这个过程涉及三个步骤:
- 第一步(SYN):客户端向服务器发送一个带有SYN(同步)标志的数据包,请求建立连接。客户 端进入SYN_SENT状态。
- 第二步(SYN-ACK):服务器收到客户端的请求后,会发送一个带有SYN和ACK(确认)标志的数 据包,表示同意建立连接。服务器进入SYN_RECEIVED状态。
- 第三步(ACK):客户端收到服务器的响应后,发送一个带有ACK标志的数据包给服务器,确认连 接已建立。双方都进入已建立连接的状态,可以开始进行数据传输。 这三步握手过程确保了双方都同意建立连接,并且双方都准备好了进行数据传输。 TCP四次挥手: TCP四次挥手是在关闭TCP连接时使用的一种协议,用于确保双方能够安全地终止连接。这个过程涉及四 个步骤:
- 第一步(FIN):一方(通常是客户端)向另一方(通常是服务器)发送一个带有FIN(结束)标志 的数据包,表示希望关闭连接。发送方进入FIN_WAIT_1状态。
- 第二步(ACK):接收方收到关闭请求后,发送一个带有ACK标志的数据包作为确认。发送方进入 FIN_WAIT_2状态,等待接收方的确认。
- 第三步(FIN):接收方准备好关闭连接时,会发送一个带有FIN标志的数据包,表示同意关闭连 接。接收方进入CLOSE_WAIT状态。
- 第四步(ACK):发送方收到接收方的关闭确认后,发送一个带有ACK标志的数据包作为确认。双 方都进入连接已关闭的状态。 这四步挥手过程确保双方都完成了数据传输,并且同意关闭连接,避免了数据丢失或不完整的情况。 总之,TCP三次握手和四次挥手是确保通信的可靠性和完整性的重要步骤,分别用于建立和关闭TCP连 接。
282. TCP是如何保证可靠传输的?
TCP(传输控制协议)保证可靠传输的主要方式包括以下几个方面:
- 三次握手:在建立连接时,发送方首先发送一个SYN(同步)标志的数据包给接收方。接收方收到 后,确认收到这个SYN,并发送一个带有ACK(确认)和SYN标志的数据包给发送方。最后,发送 方再发送一个带有ACK标志的数据包作为确认。这三步握手确保双方都同意建立连接,减少了连接 错误的可能性。
- 序列号和确认机制:TCP使用序列号来标识每个发送的数据包,接收方根据序列号确认收到的数据 包。如果发送方未收到确认,会重新发送数据包,直到接收到确认为止。这保证了数据的可靠传 输,避免了数据包丢失的情况。
- 数据分段和重组:TCP将应用层传输的大块数据分割成小的数据段进行传输,接收方根据序列号将 这些数据段重新组装成完整的数据。如果发现某个数据段丢失,TCP会要求重新发送该数据段,确 保数据的完整性。
- 流量控制:TCP利用滑动窗口机制进行流量控制,确保发送方不会发送过多的数据导致接收方无法 及时处理。这防止了拥塞并保持了传输的平稳。
- 超时重传:如果发送方在一定时间内没有收到确认,会认为数据包丢失,然后会重新发送这些数据 包。这样即使数据包在传输过程中丢失,也能够通过超时重传来确保数据的到达。
- 四次挥手:在关闭连接时,发送方和接收方都要确认关闭,防止数据的丢失或不完整。 通过上述机制,TCP可以有效地保证数据的可靠传输,确保数据在传输过程中不会丢失、重复或无序。
283. 基于UDP实现一个TCP协议
UDP(User Datagram Protocol)是一种无连接的、不可靠的传输协议,而TCP(Transmission Control Protocol)是一种面向连接的、可靠的传输协议。基于UDP实现一个TCP协议是不可行的,因为 UDP缺乏TCP提供的许多关键特性,如可靠的数据传输、流量控制、拥塞控制等。 然而,你可以使用UDP来实现一种类似TCP的协议,提供一些基本的可靠性和有序性。下面是一个简单 的示例,展示了如何使用UDP实现一个基于可靠传输的简化TCP协议:
- 序号和确认机制:在数据包中添加序号字段和确认字段。发送方将每个数据包分配一个唯一的序 号,并等待接收方发送确认消息。接收方收到数据包后,发送确认消息,确认收到的最后一个有序 数据包的序号。发送方根据接收到的确认消息确定哪些数据包已经被成功接收。
- 超时重传:发送方需要设置一个定时器,在发送数据包后启动计时器。如果在一定时间内没有收到 确认消息,发送方会假设数据包丢失,并重新发送该数据包。接收方在收到重复的数据包时可以丢 弃重复的数据。
- 流量控制:发送方和接收方可以使用滑动窗口机制来进行流量控制。发送方根据接收方的可接受窗 口大小来确定发送的数据量,并根据接收方发送的确认消息调整发送窗口的大小。
- 拥塞控制:由于UDP本身不提供拥塞控制机制,你可以基于UDP实现一些简单的拥塞控制策略, 如慢启动和拥塞避免。这可以包括动态调整发送窗口大小和控制发送速率,以避免网络拥塞。 需要注意的是,尽管你可以使用UDP实现一些类似TCP的特性,但由于UDP的本质特点,它仍然无法提 供与TCP完全相同的可靠性和性能。在实际应用中,如果需要可靠的数据传输和其他高级特性,建议使 用TCP协议而不是基于UDP的自定义协议。
284. 为什么需要HTTP/2,他解决了什么问题?
HTTP/2 是 HTTP 协议的下一代版本,旨在改进性能和效率。它解决了 HTTP/1.1 存在的一些问题,并引 入了一些新的特性和优化,以提供更快的网页加载速度、更高的效率和更好的用户体验。以下是 HTTP/2 解决的一些问题:
- 多路复用(Multiplexing):在 HTTP/1.1 中,每个请求都需要使用单独的连接,导致了高延迟和 低效率。HTTP/2 使用二进制分帧层,通过在单个连接上同时发送多个请求和响应,实现了多路复 用。这意味着可以并发处理多个请求,减少了延迟,提高了效率。
- 头部压缩(Header Compression):在 HTTP/1.1 中,每个请求和响应的头部都需要重复发 送,浪费了带宽和资源。HTTP/2 引入了头部压缩机制,使用了 HPACK 压缩算法,可以显著减少 头部的大小,减少了数据传输量,提高了效率。
- 服务器推送(Server Push):在 HTTP/1.1 中,客户端需要发送多个请求来获取网页中的所有资 源,例如脚本、样式表和图片等。而 HTTP/2 支持服务器推送,服务器可以主动将与请求的资源相 关的其他资源一起推送给客户端,减少了额外的请求延迟,提高了页面加载速度。
- 流量控制(Flow Control): HTTP/2 引入了流量控制机制,可以对数据流进行控制,防止发送方 发送过多的数据导致接收方无法处理。这有助于平衡发送和接收之间的速度差异,提高了性能和稳 定性。
- 优先级(Priority): HTTP/2 支持请求的优先级设置,可以告知服务器哪些请求更重要,服务器 可以相应地优先处理重要的请求,提高了用户体验。 总体而言,HTTP/2 在性能、效率和用户体验方面有了显著的改进。它通过多路复用、头部压缩、服务 器推送、流量控制和优先级等特性,减少了延迟、提高了吞吐量,加快了网页加载速度,提供了更好的 性能和效率。
285. HTTP/2存在什么问题,为什么需要HTTP/3?
尽管 HTTP/2 在性能和效率方面带来了显著的改进,但它仍然存在一些问题,这些问题促使了 HTTP/3 的出现。以下是一些 HTTP/2 存在的问题:
- 依赖于 TCP 协议: HTTP/2 是在 TCP 协议之上构建的,而 TCP 协议在高延迟和不可靠的网络环境 下存在一些问题。当出现丢包或网络拥塞时,TCP 使用的拥塞控制机制会导致连接的延迟增加,从 而影响性能。
- 队头阻塞(Head-of-Line Blocking): HTTP/2 使用多路复用技术,但在一个连接上的多个请求 和响应共享同一个传输通道。如果其中一个请求或响应出现延迟或丢失,将会阻塞后续的请求和响 应,这被称为队头阻塞。这可能导致其他请求受到影响,影响了整体性能。
- 部署复杂性: HTTP/2 的实施相对复杂,需要对服务器和客户端进行更新以支持新的协议。这可能 导致一些兼容性和部署问题,使得采用 HTTP/2 变得相对困难。 为了解决这些问题,HTTP/3 应运而生,它采用了全新的传输协议——QUIC(Quick UDP Internet Connections)。HTTP/3 基于 UDP 协议,而不是 TCP,以提供更好的性能和可靠性。以下是为什么需 要 HTTP/3 的一些原因:
- 解决 TCP 的问题: QUIC 作为传输层协议,克服了 TCP 的一些问题,如连接建立的延迟、队头阻 塞和拥塞控制机制。QUIC 使用自己的拥塞控制算法,可以更快地适应网络状况的变化,并提供更 好的性能。
- 减少延迟: HTTP/3 使用 QUIC 协议,通过减少握手时间和降低队头阻塞的影响,可以显著减少延 迟。这对于实时通信、视频流和移动应用等对低延迟要求较高的场景非常重要。
- 更好的并发性: HTTP/3 在一个连接上可以同时处理多个请求和响应,避免了队头阻塞的问题。这 提供了更好的并发性和吞吐量,提高了性能。
- 更好的适应性: HTTP/3 的部署相对简单,因为它使用了现有的 UDP 协议。它可以更容易地通过 NAT 和防火墙,适应多样化的网络环境。 总的来说,HTTP/3 通过引入 QUIC 协议,解决了 HTTP/2 存在的一些问题,如 TCP 的限制和队头阻 塞。它提供了更好的性能、更低的延迟和更好的并发性,同时具有更好的适应性和部署简单性。
286. Cookie,Session,Token的区别是什么?
Cookie、Session 和 Token 都是用于在 Web 应用程序中管理用户身份验证和状态的方式,但它们在实 现和使用上有一些区别。以下是它们之间的主要区别:
- Cookie: Cookie 是一小段文本信息,由服务器发送到用户的浏览器,并存储在用户的本地计算机上。 主要用于在浏览器和服务器之间存储少量数据,通常用于身份验证、用户偏好设置、跟踪用户 活动等。 Cookie 存储在客户端,可以在浏览器中设置过期时间,以及作用域(可以限定在特定的域名 或路径下)。 可以被浏览器禁用或删除,且可能存在安全性问题,如跨站点脚本(XSS)攻击和跨站请求伪 造(CSRF)攻击。
- Session: Session 是服务器端存储的用户信息,通过一个唯一的会话标识(Session ID)与客户端进行 关联。 当用户访问服务器时,服务器会创建一个新的 Session,并分配一个唯一的 Session ID,将用 户数据存储在服务器上,而不是在用户的浏览器中。 Session 数据存储在服务器上,通常在内存、数据库或缓存中,因此相对安全,但会占用服务 器资源。 Session 常用于存储敏感信息,如用户身份验证状态、购物车内容等。
- Token: Token 是一种令牌,通常是一个加密的字符串,用于验证用户身份和授权。 在基于令牌的身份验证中,用户在登录后会收到一个令牌,将其保存在客户端(通常是本地存 储或 Cookie)中,并在每次请求时将令牌发送给服务器。 服务器使用密钥验证令牌的有效性,从而确定用户身份和权限。 令牌可以在客户端存储,不需要在服务器上维护会话状态,因此适用于分布式系统和无状态应 用。 总结起来: Cookie 是在客户端存储的小段文本数据,通常用于存储用户偏好和跟踪用户活动。 Session 是服务器端存储的用户数据,通过唯一的会话标识与客户端关联,常用于存储敏感信息。 Token 是一种令牌,用于验证用户身份和授权,适用于无状态应用和分布式系统。 选择使用哪种方法取决于应用程序的需求和安全性考虑。
287. HTTPS只是比HTTP安全吗?
HTTPS(Hypertext Transfer Protocol Secure)不仅仅是比 HTTP(Hypertext Transfer Protocol)更 安全,而且它提供了一系列安全性和保护机制,以确保在 Web 通信中的数据保密性、完整性和身份验 证。以下是 HTTPS 相对于 HTTP 的主要安全改进:
- 数据加密: HTTPS 使用 SSL(Secure Sockets Layer)或 TLS(Transport Layer Security)协议 对传输的数据进行加密。这意味着在数据从客户端发送到服务器的过程中,第三方无法轻易地截 取、窃听或篡改数据。加密保护了用户的敏感信息,如登录凭据、支付信息等。
- 身份验证: HTTPS 通过使用数字证书对服务器进行身份验证。数字证书由受信任的证书颁发机构 (Certificate Authority,CA)签发,用于证明服务器的身份。这样,用户可以确信他们正在与合 法的服务器通信,而不是被冒充的恶意服务器。
- 数据完整性: HTTPS 使用加密算法和消息认证码(Message Authentication Code,MAC)来确 保数据在传输过程中没有被篡改或损坏。接收方可以验证数据的完整性,以确保数据的原始性和完 整性。
- 信任度和安全指示:浏览器在使用 HTTPS 连接时会显示安全指示,如绿色锁图标、网站名称旁边 的“安全”标签等。这些指示向用户传达了对网站的信任和数据的保护,帮助用户识别安全的网站并 减少受到网络攻击的风险。
- 防止窃听和篡改: HTTPS 的加密机制防止了中间人攻击(Man-in-the-Middle Attack),其中攻 击者可以窃听、篡改或伪造通信内容。通过加密和身份验证,HTTPS 提供了更高的安全性,使得中 间人攻击变得更加困难。 总而言之,HTTPS 不仅仅是比 HTTP 更安全,它通过加密通信、身份验证、数据完整性和安全指示等机 制,提供了更高级别的保护,确保用户的数据在传输过程中得到保密、完整和安全。因此,在涉及敏感 信息传输的场景中,使用 HTTPS 是非常重要和推荐的。
288. 浏览器输入www.baidu.com回车之后发生了什么
当在浏览器中输入 “[www.baidu.com]” 并按下回车之后,以下是大致的步骤和过程:
- 域名解析:浏览器首先会将 “[www.baidu.com]” 解析为 IP 地址。它会检查本地 DNS 缓存,如果 找到了对应的 IP 地址,则跳过后续步骤。如果没有找到,则浏览器会向本地计算机的 DNS 解析器 发送查询请求。
- DNS 查询:本地计算机的 DNS 解析器会收到浏览器发送的 DNS 查询请求,并尝试解析域名 “[ww w.baidu.com”。如果本地解析器缓存中有对应的记录,则返回解析结果给浏览器。如果没有缓存 记录,则本地解析器会向根域名服务器发送查询请求。
- 递归查询:根域名服务器收到查询请求后,会返回给本地解析器一个对应的顶级域名服务器的 IP 地址。本地解析器再次向顶级域名服务器发送查询请求。
- 迭代查询:顶级域名服务器收到查询请求后,会返回给本地解析器一个次级域名服务器的 IP 地 址。本地解析器再次向次级域名服务器发送查询请求。
- 迭代查询继续:这个过程会一直进行下去,直到本地解析器获得了最终的目标服务器的 IP 地址。
- 建立 TCP 连接:一旦浏览器获得了目标服务器的 IP 地址,它会使用 HTTP 协议中的默认端口 (80)或 HTTPS 协议中的默认端口(443)与服务器建立 TCP 连接。
- 发送 HTTP 请求:浏览器通过建立的 TCP 连接向服务器发送一个 HTTP 请求。这个请求包含了请 求的方法(如 GET、POST)、请求的路径(如 ”/“)以及其他的头部信息(如用户代理、Cookie 等)。
- 服务器处理请求:服务器收到浏览器发送的请求后,会根据请求的路径和其他信息来处理请求。对 于百度的首页请求,服务器会返回相应的 HTML 页面。
- 服务器响应:服务器处理完请求后,会生成一个 HTTP 响应。响应包括响应的状态码(如 200 表 示成功)、响应的内容(如 HTML 页面)以及其他的头部信息(如响应的日期、内容类型等)。
- 接收和渲染页面:浏览器收到服务器的响应后,会解析响应内容并渲染页面。它会将 HTML 解析 为 DOM(文档对象模型),加载和显示页面中的其他资源(如 CSS、JavaScript、图像等)。
- 断开连接:页面渲染完成后,浏览器和服务器之间的 TCP 连接会被断开。 以上是一个简化的描述,实际的过程可能还涉及到其他的细节和步骤。但总体上,这些步骤描述了当在 浏览器中输入 “www.baidu.com” 并按下回车后,浏览器如何解析域名、建立连接、发送请求、接收响 应和渲染页面的过程。
289. 对称加密和非对称加密有什么区别?
对称加密和非对称加密是两种常见的加密算法,它们在加密和解密数据时有一些重要的区别:
对称加密:
使用相同的密钥(称为密钥)来进行加密和解密数据。 加密和解密的过程速度较快,因为使用的算法相对简单。 对称加密适用于大量数据的加密,如文件传输。 密钥的管理相对较为复杂,需要确保密钥的安全性,防止未授权的人获取密钥。 常见的对称加密算法有 DES(Data Encryption Standard)、AES(Advanced Encryption Standard)等。
非对称加密:
使用一对密钥,分别是公钥和私钥。公钥用于加密数据,私钥用于解密数据。 加密和解密的过程相对较慢,因为使用的算法相对复杂。 非对称加密适用于安全性要求较高的场景,如身份验证、数字签名等。 公钥可以公开分发,而私钥必须保密保存。 常见的非对称加密算法有 RSA(Rivest-Shamir-Adleman)、DSA(Digital Signature Algorithm)等。 总结起来,对称加密使用相同的密钥进行加密和解密,速度快但密钥管理复杂;非对称加密使用不同的 密钥进行加密和解密,安全性高但速度较慢。通常的做法是,对称加密用于加密大量的数据,而非对称 加密用于安全性要求较高的场景,例如建立安全的通信渠道、数字签名等。在实际应用中,通常会将对 称加密和非对称加密结合起来使用,以兼顾效率和安全性。
290. 简单介绍一下DNS?
DNS(Domain Name System,域名系统)是互联网中用于将人类可读的域名转换为计算机可理解的IP 地址的一种系统。它充当了互联网上的“电话簿”,使用户能够通过易于记忆的域名访问网站,而不必记 住复杂的IP地址。 以下是 DNS 的基本工作原理和组成部分:
- 域名结构:域名按照层次结构划分,从右到左逐级具有不同的层级。例如,” [www.example.com]” 中,顶级域是 “.com”,次级域是 “example”,子域是 “www”。
- 域名解析:当用户在浏览器中输入一个域名,比如 “www.example.com”,操作系统或浏览器会向 本地计算机的DNS 解析器发送查询请求,以获取该域名对应的IP地址。
- DNS解析过程:如果本地解析器的缓存中没有目标域名的IP地址,它会执行以下步骤: 递归查询:本地解析器向根域名服务器发送查询请求,根服务器会返回顶级域名服务器的IP 地址。 迭代查询:本地解析器继续向顶级域名服务器发送查询请求,获得次级域名服务器的IP地 址。 继续迭代:这个过程会一直持续下去,直到本地解析器获取了目标域名的IP地址。
- 响应缓存:本地解析器在解析域名后,会将结果缓存一段时间。这样,如果再次有相同域名的查 询,就可以直接从缓存中获取结果,加快访问速度。
- 记录类型: DNS查询可以返回多种类型的记录,包括: A记录:将域名映射到IPv4地址。 AAAA记录:将域名映射到IPv6地址。 CNAME记录:将域名指向另一个域名。 MX记录:指定邮件服务器的地址。 NS记录:指定管理特定区域的域名服务器。 DNS在互联网中起着至关重要的作用,它不仅使人们能够通过易于记忆的域名访问网站,还支持电子邮 件、域名注册等多种互联网服务。然而,由于其核心的分布式特性,DNS也需要关注安全性和性能方面 的问题。
291. ping的原理是什么?
Ping是一种常用的网络工具,用于测试主机之间的连通性和测量网络延迟。它基于ICMP(Internet Control Message Protocol,互联网控制报文协议)来实现。 以下是Ping的基本工作原理:
- 发送ICMP Echo请求:当用户在命令行中执行ping命令,并指定目标主机的IP地址或域名时,操作 系统会创建一个ICMP Echo请求报文。
- 封装ICMP报文:ICMP Echo请求报文包含一个特定的标识符和序列号,以及一些其他的控制信 息。操作系统将ICMP报文封装在IP数据包中,设置目标IP地址为目标主机的IP地址。
- 发送数据包:操作系统将封装好的IP数据包发送到本地网络接口,通过网络传输到目标主机。
- 目标主机的响应:目标主机接收到ICMP Echo请求后,会检查目标IP地址是否与自己匹配。如果匹 配,则生成一个ICMP Echo响应报文。
- 返回响应数据包:目标主机将ICMP Echo响应报文封装在IP数据包中,并将数据包发送回源主机的 IP地址。
- 源主机接收响应:源主机接收到ICMP Echo响应后,会检查标识符和序列号是否与发送的请求匹 配。如果匹配,则认为目标主机可达,并计算往返时间(Round-Trip Time,RTT)。 Ping的原理基于ICMP协议,它通过发送Echo请求并接收Echo响应来测试主机之间的连通性。Ping命令 通常用于诊断网络问题、测量网络延迟和检查主机的可达性。通过比较发送请求和接收响应之间的时间 差,可以估计网络的延迟情况。
292. 什么是IPV6?和IPV4有什么区别?
IPv6(Internet Protocol version 6,互联网协议第6版)是互联网上的一种网络协议,用于为设备分配 唯一的IP地址以及进行数据包传输。它是IPv4(Internet Protocol version 4,互联网协议第4版)的继 任者。IPv6的引入主要是为了解决IPv4地址空间不足、支持更多的设备连接以及提供更好的网络性能和 安全性等问题。 主要的区别如下:
- 地址空间:最显著的区别是IPv6提供了远远超过IPv4的地址空间。IPv4使用32位地址,最多支持约 42亿个不同的IP地址,而IPv6采用128位地址,可支持的地址数量极其庞大,约为3.4 x 10^38个。 这解决了IPv4中地址短缺的问题,使每个设备都能够拥有唯一的IP地址。
- 地址表示: IPv6地址使用冒号分隔的8组16进制数表示,例如: 2001:0db8:85a3:0000:0000:8a2e:0370:7334。为了缩短表示,IPv6允许省略前导零,以及连续的 零块。IPv4则使用点分十进制表示,例如:192.168.1.1。
- 自动配置: IPv6支持更强大的自动地址配置机制,设备可以通过Router Advertisement(路由器 通告)协议自动获取IP地址和其他网络配置信息,从而简化了网络设置。
- 安全性: IPv6在设计时考虑了更多的安全性特性,包括内置的IPSec(Internet Protocol Security,互联网协议安全)支持,可以更轻松地实现网络通信的加密和认证。
- 移动性支持: IPv6更好地支持移动设备,有助于实现无缝漫游和移动IP地址的更改。
- 流量控制和质量服务: IPv6引入了更灵活和精细的流量控制和质量服务机制,有助于提供更稳定和 高效的网络传输。
- NAT(Network Address Translation):在IPv4中,由于地址短缺,常常需要使用NAT来将多 个设备共享单个公共IP地址。在IPv6中,地址数量充足,减少了对NAT的需求,有助于简化网络配 置。 尽管IPv6带来了许多优势,但由于网络基础设施的升级以及应用程序和设备的适配等问题,目前全球网 络仍然广泛使用IPv4。然而,随着时间的推移,IPv6的推广和采用逐渐增加,以满足不断增长的互联网 连接需求。
293. 什么是正向代理和反向代理?
正向代理(Forward Proxy)和反向代理(Reverse Proxy)是两种常见的代理服务器配置,用于在客户 端和目标服务器之间进行中间转发和处理。 正向代理:正向代理是位于客户端和目标服务器之间的代理服务器。当客户端发送请求时,请求首先被 发送到正向代理服务器,然后由代理服务器转发请求到目标服务器,并将响应返回给客户端。客户端通 常需要配置代理服务器的地址和端口,以便与目标服务器通信。 正向代理的主要功能包括:
- 隐藏客户端的真实IP地址:客户端的请求被代理服务器转发,目标服务器只能看到代理服务器的IP 地址,无法直接获取客户端的真实IP地址。
- 访问控制和过滤:代理服务器可以实施访问控制策略,限制客户端对目标服务器的访问。它还可以 过滤请求和响应,对流量进行审查和修改。
- 缓存:代理服务器可以缓存目标服务器的响应,以减轻目标服务器的负载并提高响应速度。
- 加速和优化:代理服务器可以对请求和响应进行优化,例如压缩、加密、负载均衡等,以提供更快 的访问速度和更好的性能。 反向代理:反向代理是位于目标服务器和客户端之间的代理服务器。当客户端发送请求时,请求首先被 发送到反向代理服务器,然后由代理服务器将请求转发到一个或多个目标服务器,最后将目标服务器的 响应返回给客户端。客户端不需要知道目标服务器的存在,只需要与反向代理服务器通信。 反向代理的主要功能包括:
- 负载均衡:反向代理可以将请求分发到多个目标服务器,以平衡服务器负载,提高系统的可扩展性 和容错性。
- 安全性和保护:反向代理可以充当防火墙,保护目标服务器免受恶意请求和攻击,例如DDoS攻 击。
- 缓存和加速:反向代理可以缓存目标服务器的响应,以提供更快的访问速度和更好的性能。
- SSL加密和解密:反向代理可以处理SSL/TLS加密和解密,减轻目标服务器的负载。 总结: 正向代理是代理客户端的请求,代表客户端与目标服务器通信;而反向代理是代理目标服务器的响应, 代表目标服务器与客户端通信。两者在网络架构中扮演不同的角色,提供不同的功能和优势。
294. 什么是跨域访问问题,如何解决?
跨域访问问题(Cross-Origin Resource Sharing,CORS)是由浏览器的同源策略引起的。同源策略是 一种安全机制,它限制了一个网页中的脚本只能访问同源(相同协议、域名和端口)的资源,防止恶意 网站通过脚本访问其他网站的数据。 当网页中的 JavaScript 代码尝试从一个源(域)请求另一个源的资源时,浏览器会发出跨域请求,如果 目标资源的服务器没有正确配置跨域访问策略,浏览器会阻止该请求,从而导致跨域访问问题。 为了解决跨域访问问题,可以采取以下方法:
- 服务器端设置响应头:目标服务器可以在响应中设置特定的响应头来允许跨域访问。常见的响应头 是”Access-Control-Allow-Origin”,它指定允许访问资源的域。服务器可以设置该头为特定的域 名,或使用通配符”*“表示允许任意域名进行访问。例如,设置响应头:“Access-Control-Allow- Origin: *”
- 请求时添加额外的头信息:发起跨域请求时,可以在请求中添加一些额外的头信息,例 如”Origin”头,用于告知服务器请求的来源。服务器可以根据该头信息来判断是否允许跨域访问, 并设置相应的响应头。
- 使用代理:可以在自己的服务器上设置代理,将跨域请求转发到目标服务器。客户端与自己的服务 器进行通信,而自己的服务器与目标服务器进行通信,从而避免了浏览器的跨域限制。
- JSONP(JSON with Padding): JSONP是一种跨域访问的解决方案,它通过在页面中动态创建