面试题库
Java 后端知识总汇
集合/线程/JUC/JVM/Spring/中间件/Docker Compose/AI 知识点总汇(含图示),共 285 条。
- Java
- 面试
Java 后端知识总汇
来源:
resource/260731-总结.rar → 全部内容总汇总.md
大纲
集合
List
实现了list接口的对象是list集合 List集合所有的元素是线性方式存储的 有序、可重复、有索引、可以设空值
Set
一、Set集合的特点
- 无序性:Set 集合中的元素不按任何特定顺序排列,无法通过索引访问元素,即集合内部的元素顺序可能随时间和操作发生变化。
- 唯一性:Set 集合不允许包含重复的元素。判断元素是否重复的标准是基于元素的
.equals()方法。如果两个对象在.equals()方法下判断为相等,则 Set 集合中只会存储其中一个。 - 最大容量:理论上,Set 集合可以无限增长,直到受到可用内存限制为止。
二、Set集合的主要实现类
HashSet:基于哈希表实现,具有良好的插入、删除和查找性能,但不保证元素的迭代顺序。TreeSet:基于红黑树实现,元素自动排序(要么基于元素自身的自然排序,要么通过自定义 Comparator),插入、删除和查找性能为O(logn),确保了集合内元素的排序顺序。LinkedHashSet:结合了 HashSet 和 LinkedList 的特性,它维护元素插入的顺序,同时仍然保证元素的唯一性。
| 实现类 | 底层结构 | 有序性 | 重复判断 | 允许 null | 线程安全 | 查询 / 增删效率 |
|---|---|---|---|---|---|---|
| HashSet | HashMap(数组 + 链表 + 红黑树) | 完全无序 | hashCode + equals | 1 个 null | 不安全 | 极高 O(1) |
| LinkedHashSet | LinkedHashMap | 插入有序 | hashCode + equals | 1 个 null | 不安全 | 略低于 HashSet,维护双向链表 |
| TreeSet | TreeMap(红黑树) | 自然排序 / 自定义排序 | compareTo / Comparator | 不允许 | 不安全 | O(logn) |
Map
Map: Map 是 Java 中双列集合(键值对存储)的顶级接口
| 特性 | Key(键) | Value(值) |
|---|---|---|
| 是否可重复 | ❌ 不可重复 | ✅ 可重复 |
| 是否有序 | ❌ 无序(部分实现类有序) | 跟随 Key 的顺序 |
| 是否有下标 | ❌ 无下标 | ❌ 无下标 |
| 是否允许 null | ✅ 最多一个 null key | ✅ 允许多个 null value |
| 关系 | 唯一标识 | 可共享 |
工具类
Collection
ArrayList和LinkedList的区别
ArrayList LinkedList 基于动态数组,数据连续存储 基于双向链表,节点包含数据和指针
快,可以通过索引直接访问 慢,需要遍历节点
末尾操作快,但在中间插入/删除时 头尾操作快,尤其是插入/删除时效率高 需要移动大量数据
占用内存较少,只存储数据本身 占用内存较多,因为每个节点都有两个额外的指针
适合需要快速访问数据的场景, 适合需要频繁插入/删除的场景,如队列 如商品列表
底层是数组,查询快,增删慢 底层是链表,查询慢,增删快
泛型
编译器的语法糖,运行期全靠类型擦除硬撑
优点:
1.数据类型可以像参数一样由外部传入
2.当变量与泛型不匹配时编译器会拦截
3.提高代码可读性
三种使用方法:泛型类,泛型接口,泛型方法
Collections常用方法
Collections 是一个操作 Set、List 和 Map 等集合的工具类。Collections 中提供了一系列静态的方法对集合元素进行排序、查询和修改等操作,还提供了对集合对象设置不可变、对集合对象实现同步控制等方法
- 排序相关方法(仅 List 可用) sort () 排序、reverse () 反转、shuffle () 乱序、swap () 交换元素
2.查询统计:max、min、frequency、binarySearch、replaceAll
3.复制:copy
4.线程安全:synchronizedList/Set/Map 坑: synchronizedList/Set/Map底层实现并不是Collection的list而是返回Collections静态内部类的SynchronizedRandomAccessList,里面实现的方法不是同步的,而是方法体中的使用同步块(mutex)来实现
5只读集合:emptyXXX、singletonXXX、unmodifiableXXX
Arrays常用方法
一、toString () 打印数组(最常用)
二、sort () 数组排序
三、binarySearch () 二分查找 注意:前提:数组必须提前升序排序
四、copyOf /copyOfRange 数组复制 copyOf:从头复制,可扩容 / 缩容 copyOfRange:区间复制 [from,to) 左闭右开
五、fill () 数组填充赋值
六、equals () /deepEquals () 比较数组是否相等 equals:一维数组,判断每个元素值是否相同 deepEquals:多维数组专用
七、asList () 数组转 List(高频面试坑)
1.Arrays.asList() 返回的是 Arrays 内部静态 ArrayList,固定长度,不能增删;
2.底层共享原数组,数组和 List 修改互相影响;
3.基本数据类型数组转换会把整个数组作为单个元素;
4.业务开发标准写法:new ArrayList<>(Arrays.asList(array));
5基本类型数组用 Stream.boxed () 转包装类 List。
迭代器
fail-fast和fail-safe的区别(面试重点)
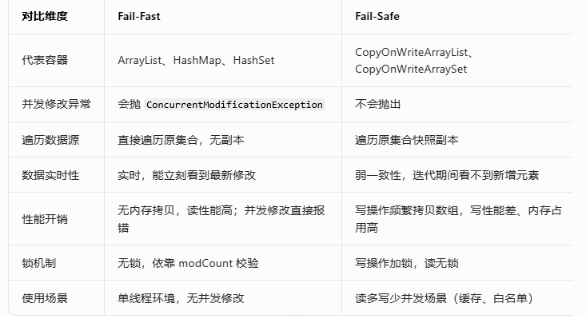
Fail-Fast(快速失败) 迭代集合过程中,检测到集合结构发生修改立刻抛出 ConcurrentModificationException,不允许并发修改。
Fail-Fast:遍历原集合,无锁依靠 modCount(修改计数器) 校验,结构修改立刻抛并发修改异常,适用于单线程,读写无拷贝效率高;必须使用迭代器自带的 iterator.remove() 方法,它会同步更新 expectedModCount。
Fail-Safe(安全失败)
迭代时不操作原集合,拷贝一份底层数据副本遍历;原集合修改不影响迭代器,不会抛并发修改异常。 使用CopyOnWriteArrayList
Fail-Safe:写时复制快照遍历,不抛异常,读多写少并发使用,但写操作开销大、数据非实时;
Comparator与Comparable有什么区别(开发是否考虑排序了解)
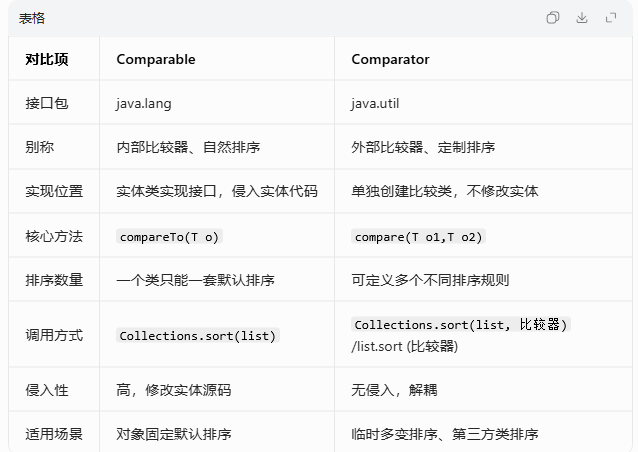
Comparable:实体类自己实现该接口,重写 compareTo(),对象减参数从小到大排序,参数减对象从大到小排序,定义对象默认排序规则,一个类只能有一套默认排序逻辑。
Comparator:外部比较器,不修改实体类代码,单独创建比较器,灵活自定义多种排序规则,一个类可以创建多个不同 Comparator。参数前减后从小到大,后减前从大到小。
高频问答
- 什么时候用哪个? 实体有固定默认排序 → Comparable
需要多种排序规则、临时排序、不能修改实体源码 → Comparator
- sort 同时传 Comparable 和 Comparator,以谁为准?
以Comparator 外部比较器优先,忽略元素自身的 compareTo。 3. 优缺点总结 Comparable 优点:调用简单,直接 sort;缺点:只能一套规则,改排序要改实体
Comparator 优点:多套规则、解耦、灵活;缺点:调用时多传一个参数
函数接口
1.Consumer
2.Supplier
3.Function<T,R> R apply(T) 有参有返 stream.map(Function<T,R>)
4.Predicate
方法引用
1.静态方法引用 接口 引用 = 类名::静态方法名
2.对象方法引用 接口 引用 = 对象::对象方法名
3.构造方法引用 接口 引用 = 类名::new
4.特殊方法引用 接口 引用 = 类名::对象方法名 类名帮对象占位,抽象方法的第一个参数就是调用方法的对象,第二个参数是方法中的第一个参数。
Iterator
ListIterator
概念 迭代:一句话总结:就是把集合中的元素 一个一个的拿出来。
Iterator接口的常用方法如下: list,set都可以使用
public E next():返回迭代的下一个元素。注意,在进行集合元素取出时,如果集合中已经没有元素了,还继续使用迭代器的next方法,将会发生java.util.NoSuchElementException没有元素的错误。
public boolean hasNext():如果仍有元素可以迭代,则返回 true。
void remove() ; 根据条件删除元素
List 集合额外提供了一个 listIterator() 方法,该方法返回一个 ListIterator 列表迭代器对象, ListIterator 接口继承了 Iterator 接口 提供了专门操作 List 的方法: void add():通过迭代器添加元素到对应集合 void set(Object obj):通过迭代器替换正迭代的元素 void remove(): 通过迭代器删除刚迭代的元素 boolean hasPrevious():如果以逆向遍历列表,往前是否还有元素。 Object previous(): 返回列表中的前一个元素。 int previousIndex():返回列表中的前一个元素的索引 boolean hasNext() 如果仍有元素可以迭代则返回 true。 Object next() 返回列表中的下一个元素。 int nextIndex() 返回列表中的下一个元素的索引
map的三种遍历方式
①: Collection
②:Set
③:Set<Map.Entry<K,V>> entrySet<> 把Map集合中的所有key和value按组一起取出来,并封装成Entry对象,在使用entry.getKey(),与entry.getValue()获取key跟value 最推荐,一次遍历拿到 key 和 value,效率最高
TreeSet和HashSet的区别
| 对比维度 | HashSet | TreeSet |
|---|---|---|
| 底层结构 | 哈希表(HashMap) | 红黑树(TreeMap) |
| 元素顺序 | 完全无序 | 自然排序或定制排序(有序) |
| 重复判断 | hashCode() + equals() | compareTo() 或 compare() 返回 0 |
| 是否允许 null | 允许(仅 1 个) | 不允许(比较时无法处理 null) |
| 性能 | 增删查 O(1),效率极高 | 增删查 O(log n),相对较慢 |
| 适用场景 | 快速存取,不关心顺序 | 需要有序输出,或需要范围查找 |
| 内存占用 | 较少(仅存元素) | 较多(红黑树额外维护指针) |
| 线程安全 | 均不安全 | 均不安全 |
HashSet
1. 核心特点
- 无序:迭代顺序不保证,且随时间可能改变。
- 允许 null:只能存 1 个。
- 非线程安全:多线程需手动包装(
Collections.synchronizedSet)。 - fail-fast:遍历时并发修改会抛
ConcurrentModificationException。
2. 构造函数关键参数
- 默认容量:16,负载因子:0.75。
- 扩容临界值:
容量 * 0.75。
3. 去重原理
- 先 hashCode,后 equals:
- 调用
hashCode()定位桶位置。 - 若桶空,直接插入。
- 若桶不空,调用
equals()逐一比对,若返回true则拒绝添加。
- 调用
- 铁律:重写
equals()必须重写hashCode(),保证相等对象哈希值一致。
4. 时间复杂度
- 增删查平均:O(1)(哈希分布良好)。
5. 注意事项
- 自定义对象存入必须重写
hashCode()和equals(),否则去重失效。
6. 常用方法
- add:添加元素
- remove:删除元素
- contains:判断是否包含某个元素
- clear:清空
- Iterator:使用迭代器遍历集合
- foreach:遍历集合
HashMap与HashTable 的区别
| HashMap | Hashtable | |
|---|---|---|
| 线程安全 | 不安全 | 安全(synchronized) |
| 底层结构 | 数组+链表+红黑树 | 数组+链表 |
| 索引定位 | 位运算与(极快) | 除法取模(较慢) |
| null key | 允许一个 | 不允许 |
| null value | 允许 | 不允许 |
| 性能 | 高 | 低(同步开销) |
| 初始容量 | 16 | 11 |
| 扩容方式 | 2 倍 | 2 倍 + 1 |
| 迭代器 | fail-fast | fail-fast,Enumeration |
| 诞生时间 | JDK 1.2 | JDK 1.0(基本被取代) |
ArrayList源码的关键点
ArrayList底层实现:可变长的数组,有索引,查询效率高,增删效率低
构造方法:
new ArrayList():
jdk6中,空参构造直接创建10长度的数组。
jdk7(新版)、jdk8中,默认初始容量0,在添加第一元素时初始化容量为10
new ArrayList(int initialCapacity):
指定初始化容量
添加元素:add(E e);
首次添加元素,初始化容量为10
每次添加修改modCount属性值
每次添加检查容量是否足够,容量不足时需要扩容,扩容大小为原容量的1.5倍
11 ==> 15
移除元素:remove(E e);
每次成功移除元素,修改modCount值
每次成功移除需要需要移动元素,以保证所以元素是连续存储的(删除操作效率低的原因)
求两个List的交集元素?
第一种是双层 for 循环,外层遍历第一个集合、内层遍历第二个,判断相等加入结果。但时间复杂度是 O (M*N),数据量稍微大一点性能很差
第二种是 HashSet 优化方案,先把长度更短的 List 转为 HashSet,利用 HashSet O (1) 的 contains 查询降低复杂度,整体时间复杂度 O (M+N)。遍历长集合,判断元素在 Set 中存在就加入交集,同时可以删除 Set 中已匹配的元素,自动给交集去重
第三种是 Java8 Stream 流式写法,代码最简洁。但直接用 list.contains 会有性能问题,所以先把第二个 List 转 HashSet 再过滤,搭配 distinct 去重,适合 JDK8 以上新项目。
常用方法
1、添加元素
(1)add();添加元素对象到当前集合中,把传入内容当成一整个对象添加,只 + 1 个元素;
(2)addAll():添加other集合中的所有元素对象到当前集合中
2、删除元素
(1) boolean remove(Object obj) :从当前集合中删除第一个找到的与obj对象equals返回true的元素。
(2)boolean removeAll(Collection<?> coll):从当前集合中删除所有与coll集合中相同的元素。即this = this - this ∩ coll
(3)boolean retainAll(Collection<?> coll):从当前集合中删除两个集合中不同的元素,使得当前集合仅保留与c集合中的元素相同的元素,即当前集合中仅保留两个集合的交集;
(4) void clear(); 清空集合
(5)boolean removeIf(Predicate<? super E> filter) :删除满足给定条件的此集合的所有元素。removeIf方法是Java8引入的。
3、查询与获取元素
(1)boolean isEmpty():判断当前集合是否为空集合。
(2)boolean contains(Object obj):判断当前集合中是否存在一个与obj对象equals返回true的元素。
(3)boolean containsAll(Collection<?> c):判断c集合中的元素是否在当前集合中都存在。即c集合是否是当前集合的“子集”。
(4)int size():获取当前集合中实际存储的元素个数
(5)Object[] toArray():返回包含当前集合中所有元素的数组
常用方法
1、添加元素
void add(int index, E ele):把元素添加到指定位置
boolean addAll(int index, Collection<? extends E> eles):把一组元素添加到指定位置
2、删除元素
E remove(int index):删除指定位置的元素
3、修改元素
E set(int index, E ele):替换[index]位置的元素
default void replaceAll(UnaryOperator
4、获取元素
E get(int index):返回[index]位置的元素
List subList(int fromIndex, int toIndex):返回[fromIndex, toIndex)范围的元素
int indexOf(Object obj):查询obj在列表中的位置,如果有重复,返回第1个
int lastIndexOf(Object obj):查询obj在列表中的位置,如果有重复,返回最后1个
boolean contains(E ele) 判断某个元素是否存在
clear()
boolean isEmpty()
常用方法
| 方法 | 说明 |
|---|---|
add(E e) | 添加元素,若已存在则返回 false |
remove(Object o) | 删除指定元素 |
contains(Object o) | 判断是否包含某元素 |
size() | 返回元素个数 |
isEmpty() | 判断集合是否为空 |
clear() | 清空集合 |
iterator() | 返回迭代器 |
toArray() | 转为数组 |
注意:TreeSet 还额外提供 first()、last()、headSet()、tailSet()、subSet() 等范围相关方法。 |
底层实现
1. 本质
- 内部持有
HashMap<E, Object> - 元素作为 Key,Value 统一为静态占位对象
PRESENT
private transient HashMap<E,Object> map;
private static final Object PRESENT = new Object();
2. 核心方法映射
| 方法 | 实际调用 | 结果判断 |
|---|---|---|
add(e) | map.put(e, PRESENT) | 返回 null → 添加成功 |
remove(o) | map.remove(o) | 返回 PRESENT → 删除成功 |
contains(o) | map.containsKey(o) | Key 存在 → true |
3. 底层数据结构(JDK 1.8+)
- 数组 + 链表 + 红黑树
| 转换 | 条件 |
|---|---|
| 链表 → 红黑树 | 链表长度 ≥ 8 且数组容量 ≥ 64 |
| 红黑树 → 链表 | 节点数 ≤ 6 |
4. 添加流程(去重原理)
- 计算
hashCode()→(n-1) & hash定位桶 - 桶空 → 直接插入
- 桶不空 → 遍历链表/红黑树,用
equals()比较- 相等 → 不添加,返回
false - 全部不等 → 挂载尾部,返回
true
- 相等 → 不添加,返回
5. 哈希计算
hash = (key == null) ? 0 : (h = key.hashCode()) ^ (h >>> 16)- 解释:高 16 位与低 16 位异或混合,减少冲突
6. 扩容机制
- 触发条件:元素数 > 容量 × 负载因子(默认 16 × 0.75 = 12)
- 新容量 = 旧容量 << 1(2 倍)
- 元素重新计算索引(rehash)
7. 核心特点
- 非线程安全 → 用
Collections.synchronizedSet()包装 - fail-fast → 遍历时并发修改抛异常
- 允许 1 个
null
8. 性能
- 增删查平均:O(1)
- 最坏(严重哈希冲突):O(log n)(红黑树优化)
9. 一句话总结
HashSet 本质就是 HashMap 的 Key 集合,所有操作都委托给 HashMap。
去重原理
1. HashSet / LinkedHashSet
- 先调用元素的
hashCode()计算哈希值,定位到桶位置(槽位)。 - 若桶内无元素,直接存入;若有元素,再通过
equals()比较:- 若
equals()返回true,则视为重复元素,不添加; - 若
equals()返回false,则以链表/红黑树形式挂载。
- 若
- 要求:重写
equals()时必须重写hashCode(),保证相等对象哈希值一致。
2. TreeSet
- 不依赖
hashCode()和equals(),而是通过 比较器(Comparator或元素的compareTo)判断重复。 - 当
compareTo()或compare()返回0时,认为两个元素相等,不添加。 - 因此,元素的 比较逻辑 决定了去重行为。
List 去重
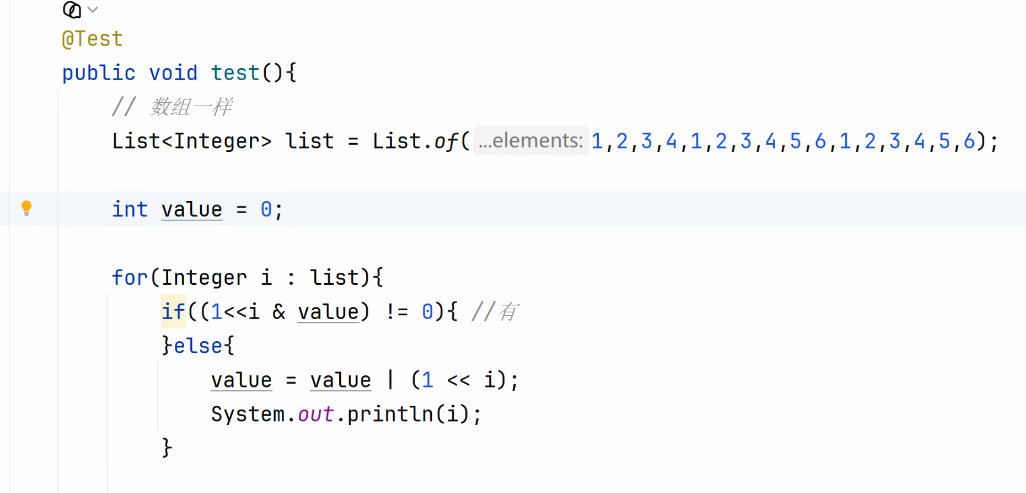
- new HashSet(list)
- list.stream().distinct() 3如果要问要求不使用这些工具类跟方法如何实现(如图)
int 有 32 个二进制位,每一位对应一个数字,第 i 位为 1 就代表数字 i 已经出现过,初始是 0,全部未标记。 遍历每个数字 i 的时候,先用 1 左移 i 位,生成只有第 i 位为 1 的二进制掩码;再和 value 做按位与,如果结果不为 0,说明这个数字之前出现过,直接跳过;如果等于 0 就是第一次出现,用按位或把 value 的第 i 位设为 1 做标记,同时打印这个数字。
对比 HashSet 去重,各自适用场景? 数字集中、量小用位运算,极致性能省内存;数字分散、有负数、业务通用场景用 HashSet,可读性和兼容性更强。
Map常用方法
添加操作: ①V put(K key, V value) 添加键值对。若key已存在,替换旧值并返回旧值;若 key 不存在,返回 null ②void putAll(Map<? extends K, ? extends V> m) 将另一个 Map 中的所有键值对添加到当前 Map
删除操作: ①V remove(Object key) 根据 key 删除键值对,返回被删除的 value;若 key 不存在,返回 null ②void clear() 清空所有键值对
查询操作:
①V get(Object key) 根据key获取value。key不存在则返回 null
②V getOrDefault(Object key, V defaultValue) 获取 key 对应的 value,若不存在则返回默认值 defaultValue
③boolean containsKey(Object key) 判断是否包含指定的 key
④boolean containsValue(Object value) 判断是否包含指定的 value ⑤boolean isEmpty() 判断 Map 是否为空
修改操作: ①V replace(K key, V newValue) 替换指定 key 的值为 newValue。key 不存在则不操作,返回 null
其他常用方法:
| 方法 | 说明 |
|---|---|
int size() | 返回键值对的数量 |
Set<K> keySet() | 获取所有 key 组成的 Set 集合 |
Collection<V> values() | 获取所有 value 组成的 Collection |
Set<Map.Entry<K,V>> entrySet() | 获取所有键值对(Entry)组成的 Set |
HashMap
HashMap —— 最常用、默认选择
特点
- 键无序(不保证存入和取出的顺序一致)
- 键不重复
- 键无索引
- 允许 key 和 value 为 null(key 最多一个 null)
- 线程不安全
底层原理
HashMap 的底层是 哈希表,在 JDK 8 之后是 数组 + 链表 + 红黑树 的结构。
核心流程:
- 创建 HashMap → 默认初始化一个长度为 16 的数组(Node[])
- 调用 put(key, value) →
a. 计算 key 的 hashCode(),得到哈希值
b. 通过哈希值计算在数组中的索引位置
c. 如果该位置为空 → 直接存入
d. 如果该位置不为空 → 调用 equals() 比较
- equals 返回 true → 替换旧值(key 已存在)
- equals 返回 false → 发生哈希冲突,以链表形式挂在后面
在 JDK 8 及以后,当你执行 new HashMap() 时,底层其实并没有立刻创建这个长度为 16 的数组。数组是在你第一次调用 put() 方法时才被真正创建出来的。为了节省内存使用懒加载
扩容机制
重要参数:
- 初始容量(capacity):默认 16
- 加载因子(load factor):默认 0.75
- 阈值(threshold):capacity × load factor = 16 × 0.75 = 12
当元素个数超过阈值(12)时 → 扩容为原来的 2 倍(16 → 32)
红黑树转换条件: 当链表长度 > 8 且 数组长度 ≥ 64 → 链表转红黑树(提高查询效率) 当链表长度 > 8 但 数组长度 < 64 → 先扩容数组(不转红黑树) 当红黑树节点数 < 6 → 红黑树退化为链表
面试题:为什么自定义对象做 Key 要重写 hashCode 和 equals
因为 HashMap 依赖这两个方法来判断 key 的唯一性: put(key, value) 的过程:
- hashCode() → 确定存储位置(数组索引)
- equals() → 判断该位置上是否有相同的 key
如果只重写 equals 不重写 hashCode: → 两个对象 equals 相等,但 hashCode 不同 → 被存到不同的位置 → 导致 Map 中出现了”重复的 key”
如果只重写 hashCode 不重写 equals: → hashCode 相同,但 equals 不相等 → 能定位到正确位置,但无法区分 key 是否重复 → 会一直在同一个位置追加链表(性能下降)
LinkedHashMap
LinkedHashMap —— 要顺序就用它
特点
- 键有序(保证存储和取出的顺序一致 —— 插入顺序)
- 键不重复
- 键无索引
- 是 HashMap 的子类
底层原理
哈希表 + 双向链表
在 HashMap 的基础上,额外维护了一个双向链表, 记录了每个 Entry 的插入顺序(或访问顺序), 所以遍历时能保持顺序。
特殊构造函数 public LinkedHashMap(int initialCapacity, float loadFactor, boolean accessOrder) { super(initialCapacity, loadFactor); this.accessOrder = accessOrder; } accessOrder = false(默认值:按插入顺序排序) accessOrder = true(按访问顺序排序)
- 链表头部(Head):存放的是最久没有被访问过的元素(最老、最该被淘汰)。
- 链表尾部(Tail):存放的是最近刚刚被访问过的元素(最热、最应该保留)
适用场景
- 需要一个 Map,又希望元素按插入顺序排列
- 如果要实现 LRU 缓存(最近最少使用淘汰),可以设置
accessOrder=true
TreeMap
TreeMap —— 要排序就用它
特点
- 键可排序(默认按 key 的自然顺序升序)
- 键不重复
- 键无索引
- 不允许 key 为 null(会抛 NullPointerException)
底层原理
红黑树(Red-Black Tree)
特点:插入时自动排序,查找、插入、删除的时间复杂度都是 O(log n)
排序规则
| 方式 | 说明 | 示例 |
|---|---|---|
| ① 自然排序 | Key 实现 Comparable 接口,重写 compareTo() | String、Integer 等已实现 |
| ② 比较器排序 | 创建 TreeMap 时传入 Comparator 比较器对象 | 灵活,不修改原类 |
优先级: 如果同时存在,以构造时传入的 Comparator 为准。
适用场景
- 需要对 key 进行排序的场景
- 需要范围查询(比如找出所有大于某个 key 的元素)
HasTable
Hashtable —— 古老、线程安全
特点
- 线程安全(方法用 synchronized 修饰)
- 不允许 key 或 value 为 null
- 比 HashMap 更早出现(JDK 1.0),现在基本被 HashMap + ConcurrentHashMap 取代
- 性能比 HashMap 差(全表锁)
主要实现类
集合跟数组的区别
数组:
- 优点:访问速度快,因为可通过索引直接访问元素。
- 缺点:大小固定,不适合在不知道数据量的情况下使用。
- 使用场景:当确定数据大小时,或者需要快速随机访问时。
集合:
- 优点:大小可动态变化,提供了更为广泛的功能,如添加、删除元素。
- 缺点:访问元素时通常需要迭代,速度相对较慢。
- 使用场景:当数据大小未知或需要方便的添加、删除操作时。
lambda
接口里只有一个抽象方法,可以使用lambda表达式
泛型类
一.泛型类: 1.定义:类型参数在类的定义中
泛型标识: T:任意类 type E:元素/异常 K:key V:value S:subtype 子类 R: return 返回值类型 不固定,本身算是一种参数名,随意起名
泛型的定义位置: 1)非静态的成员属性类型 2)非静态方法的形参类型和返回值类型
2.泛型类中的静态方法和静态变量不能用泛型类定义的泛型 静态在类加载时完成初始化,静态就不知道泛型的类型,报错.非静态在调用时加载,已经知道类型
3.可以接受多个参数类型 4.创建泛型类的对象时一定要指定泛型的具体数据类型,<>中不写就是Object
泛型接口
泛型接口 1.泛型接口中的类型参数,在该接口被继承或实现时确定 2.同泛型类 ,接口中的属性默认静态,静态变量和静态方法也不能用接口声明的泛型 3.在实现泛型接口时泛型不指定就为Object
泛型方法
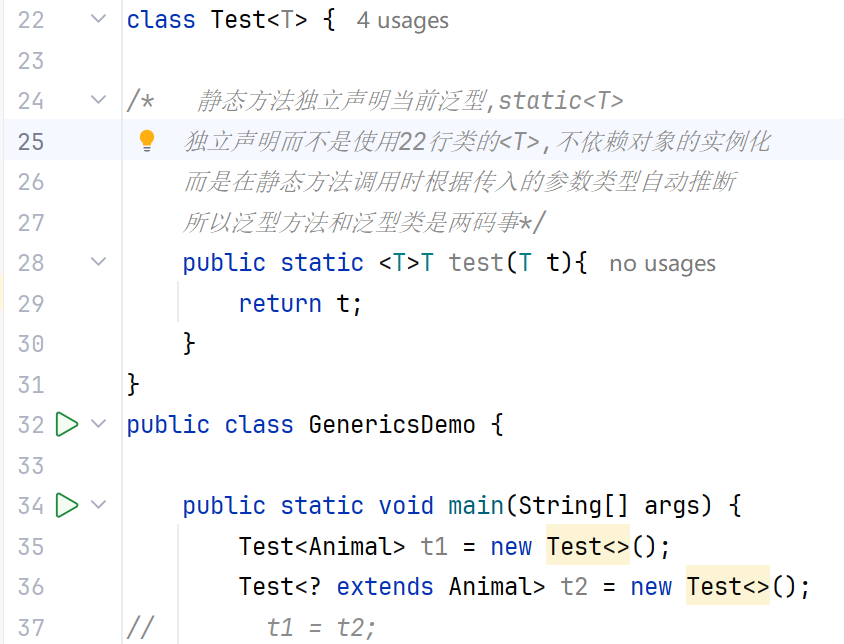
三.泛型方法 1.返回值前面声明了一个泛型,就是泛型方法,这个泛型只能在该方法中使用 2.泛型方法可以使用泛型类定义的泛型参数 3.仅使用泛型类定义的泛型参数的方法不是泛型方法 4.泛型方法可以声明多个参数类型 5.泛型方法中也可以使用泛型类定义的泛型参数,只要不是静态,就可以使用泛型类的泛型 6.特别注意,泛型类定义的泛型和泛型方法定义的泛型是相互独立的 7.使用:泛型方法在调用方法时确定具体参数类型. 泛型方法声明的泛型只能在方法里用 使用泛型类定义的泛型的静态方法报错,但使用自己定义的泛型的静态方法可以运行,因为调用才确定参数 8.调用泛型方法时,可以显示指定类型参数,也可以不指定 不指定&多个参数:类型参数为两个的最小共同父类,直到Object
类型擦除
四.类型擦除 1.定义:编译器在编译期间擦除代码中的泛型语法并做出相应的类型转换.泛型信息只存在于编译阶段,不会进入运行阶段,class文件里没有泛型信息 2.泛型擦除后默认Object替换,使用了泛型通配符的例外 3.擦除原理:编译器先检查代码传入的T的数据类型并记录,编译的同时进行擦除,之后在操作编译器就会自动将对象进行类型转换.
泛型通配符
非限定通配符
无限定通配符只能读不能写(null除外),读出来只能是object
不关心类型,只做与类型无关的事
大多数情况下
限定通配符 1.<? extend T>上界通配符 T代表类型的上界,这个表示的参数类型是T和T的子类 作用:不关心具体类型从集合里读取数据 限制:只能读不能写(null除外) 只能读不能写
2.<? super T>下界通配符 T代表类型的下界,表示参数类型是T和T的父类 作用:不关心具体数据类型往集合内写数据 限制:能写入 T 及子类,但读出只能到 Object 只能写不能读,读出来的只当做Object类型
PECS原则: 怎么选择泛式通配符
需要返回T,是生产者,用extend 需要写入T,是消费者,使用super
常见集合的线程安全
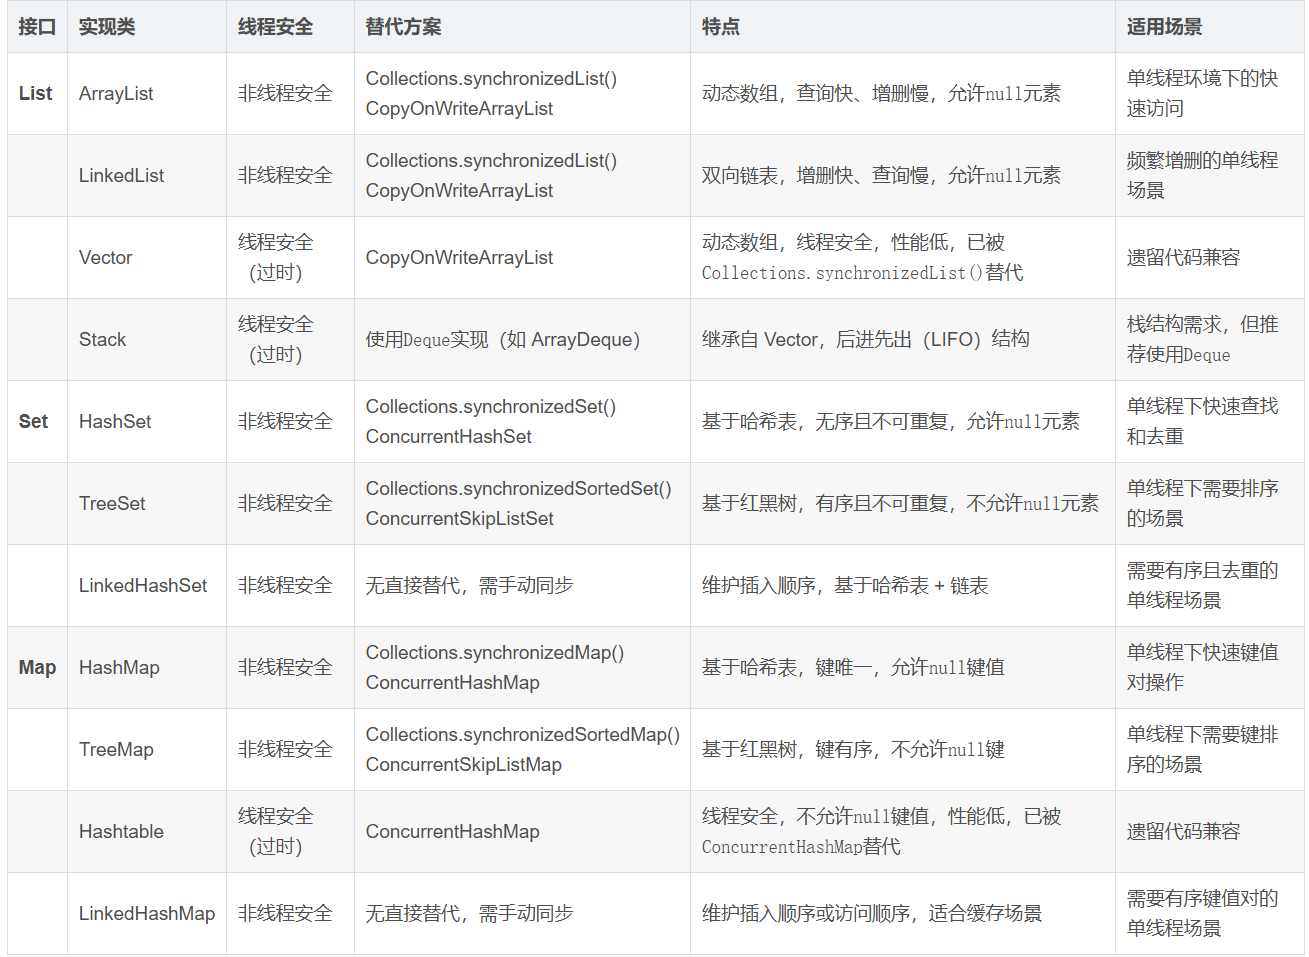
集合遍历过程中如何正确删除元素
1.Iterator迭代器的remove方法 2.反着删 3.removeif(jdk8)
线程
什么是线程
进程区别
进程是系统分配资源(内存)最小单位。一个应用程序运行起来至少有一个进程。线程共享进程分配到的资源(内存),线程是CPU最小调度的单位,一个进程至少有一个线程。 案例:植物大战僵尸这款游戏,启动后开启一个进程,里面的僵尸,植物,背景音乐都是并发的线程。
线程的创建方式
5种方式: 1.继承Thread类 2.实现Runnable接口 3.实现Callable接口 4.线程池 5.CompletableFuture线程编排
线程的生命周期
和状态切换
NEW: 线程未运行 | start() RUNNABLE:可运行状态
RUNNABLE:可运行状态 | 同步块中抢锁失败 _EntryList中 BLOCKED
RUNNABLE:可运行状态 | sleep()/wait()/join WAITING/TIMED_WAITING | 时间到/通知/唤醒 RUNNABLE
BLOCKED | 抢到锁回到可运行状态 RUNNABLE
RUNNABLE | run()结束 TERMINATED
线程传递数据
1.启动前传参 —— 最安全 在调用线程start()方法前,通过构造方法,Setter方法,匿名内部类/lambda中捕获的外部变量 传入参数。
2.运行时通信(共享内存,消息队列) —— 最常见 ①共享内存:volatile,synchronized同步块中的变量,每个线程共享的,可以获取到 ②一个线程发送到MQ,另一个线程监听来获取,异步解耦
3.结束后拿结果 —— Callable登场
可以使用Callable
0
线程池
为什么要使用线程池
优点: 1.降低开销 每次开始一个线程-> pthread_create() 从用户态直接请求内核态,各种消耗性能。节省了创建和销毁的时间,将性能开销从用户时间转移到应用的启动时间里,极大降低了响应延迟。
2.解耦了任务的提交和执行 new Thread().start();
3.防止资源耗尽 单线程处理高并发 10万个请求,线程就可能导致卡死状态 有界线程池+有界队列+拒绝策略=防止JVM崩溃的防线 100个线程+(一个队列10万个请求)+ 10万01个请求给拒绝
4.统一管理所有线程 getActiveCount() getTaskCount() getQueue().size() 观测流量指标
5.上下文切换 线程池的线程复用,减少了创建,CPU缓存命中率也高,单一的线程启动后cache没有数据导致性能下降
终极反杀题: 既然线程池这么好用,阿里手册上为什么说“newFixedThreadPool”和“newSingleThreadExecutor”不让用呢? 因为他们默认使用了LinkedBlockingQueue(无界队列),任务会堆积,最终撑爆内存。
有几种线程池
1.固定大小 —— 负载平稳 Executors.newFixedThreadPool(int n) 核心线程数=最大线程数,无界队列(致命)
2.单线程池 —— 保证可以按顺序执行 Executors.newSingleThreadExecutor() 核心=最大=1,无界队列(致命)
3.缓存线程池 —— 可以弹性伸缩 Executors.newCachedThreadPool() 核心=0,最大=Int最大值,同步移交队列(SynchronousQueue), 瞬间高并发会导致OOM和CPU 100%
4.定时任务线程池 —— 调度 Executors.newScheduledThreadPool(int corePoolSize) 延时执行,corePoolSize固定大小,DelayedWorkQueue按时间排序的堆结构。如果任务时间过长可能会阻塞后续的周期任务 Executors.newSingleScheduledThreadPool() 单一定时线程池
5.工作窃取池 —— java 8+ 并行计划 Executors.newWorkStealingPool(int parallelism) 每个线程有自己的双端队列Deque,如果自己的任务做完会偷其他线程队列的尾部任务。如百万级数组求和
自定义线程池
start和run的区别
如果直接调用run()方法,就相当于普通方法的一次调用。 线程要求必须使用start()方法调用才会创建新线程,并由JVM调用run()方法。
并发和并行区别
并发:CPU时间片轮询,操作系统通过时钟终端,频繁切换上下文(保存/恢复 CPU寄存器和程序计数器) 并行:依赖多核/多处理器CPU数量,程序在不同的CPU物理内核上跑。一个内核拿一个任务运行。
你开发中遇到哪些并发和并行的类或者包? 并发包:ConcurrentHashMap:内部使用了分段锁/CAS,本质就是并发设计结构 并行流:ParallelStream,这些Parallel开头的类专门为了并行设计,目的是利用多核CPU把大任务拆分成小任务同时计算
如何用代码判断当前是并发还是并行?(略) Runtime.getRuntime().availableProcessors()>1 核心数大于1 && 线程数>1 才能判断并行
sleep和wait区别
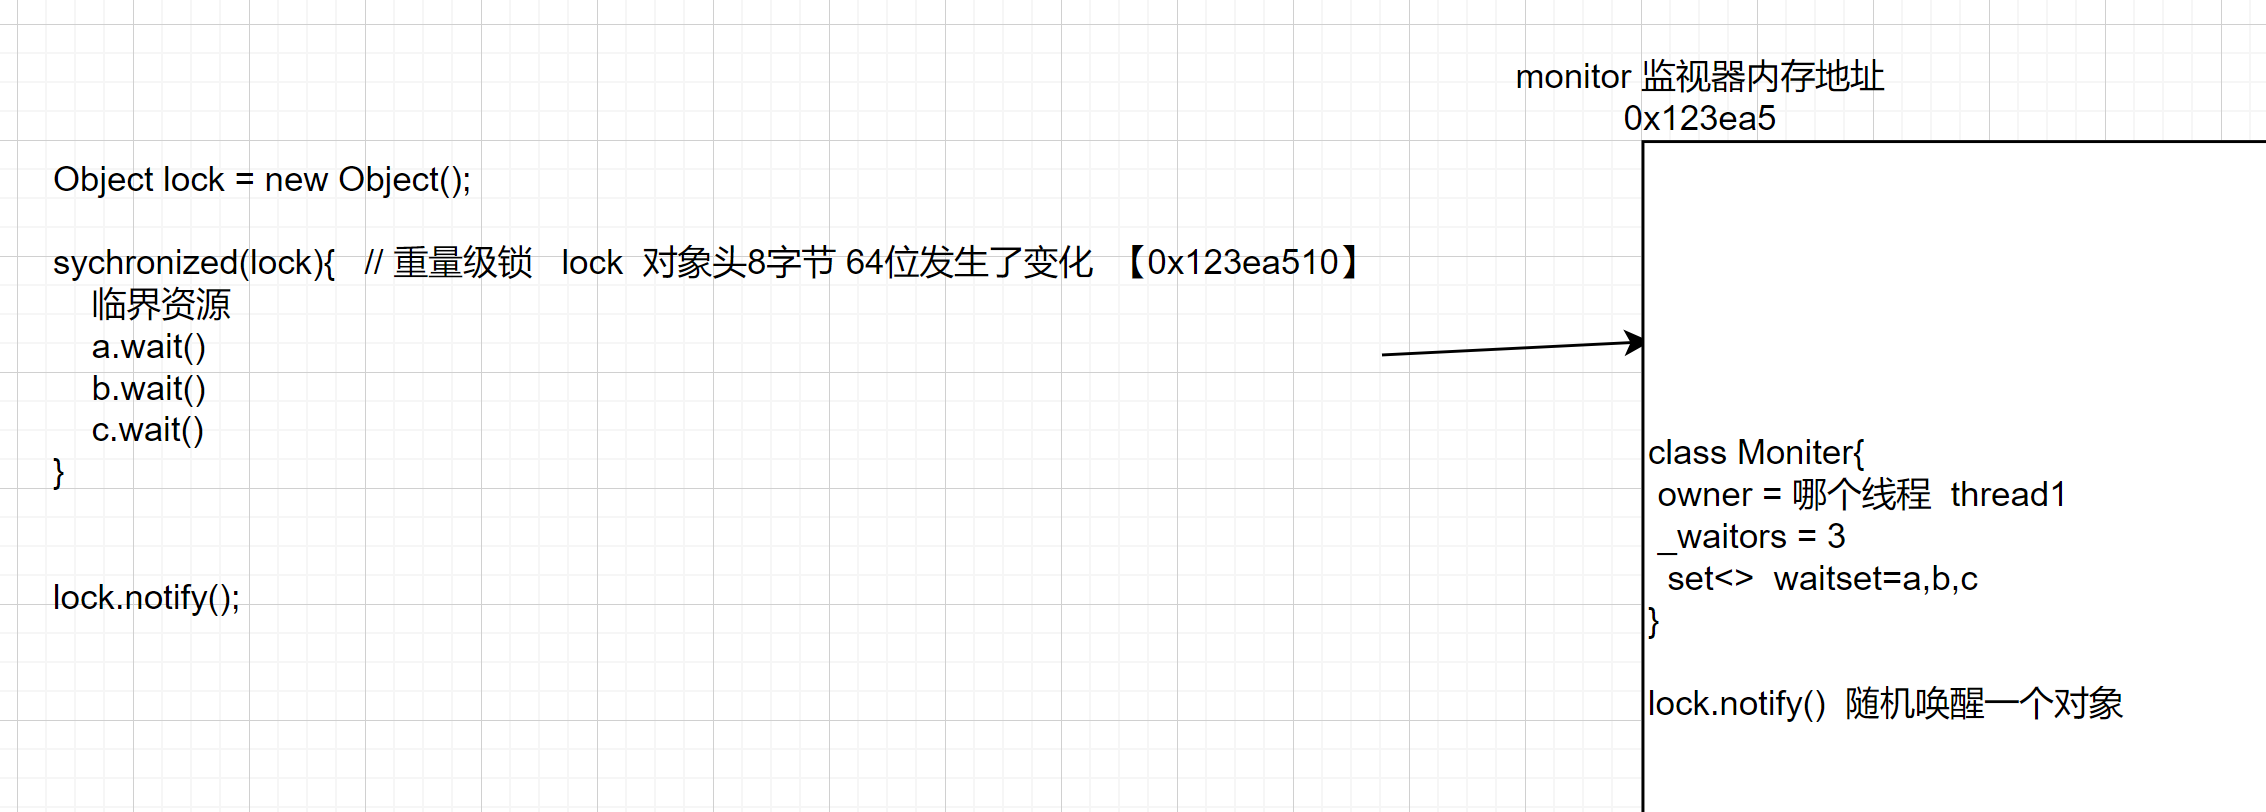
1.归属 Object.wait(); // 对象方法 Thread.sleep(); // 静态方法 2.释放锁 wait释放, sleep不释放 3.使用位置 wait只能在同步块/同步方法中 sleep任意位置 4.唤醒方式 sleep 超时唤醒,或interrupt wait 超时唤醒,或notify/notifyAll 5.线程状态不同 sleep(time): TIMED_WAITING wait(time) TIMED_WAITING /wait() WAITING 6.线程在哪里 sleep:等待CPU调度器的“定时等待队列”中 wait: 对象头的监视器中的等待池“wait set”
join和yield区别
main(){ a.join(); b.join(); } join是加入线程,当前的线程main要等待调用join的线程a,b死亡或超时。用于线程同步(等我做完了你再执行)
yield让出自己的CPU时间片给同级别的其他线程,但是CPU的调度器可能会忽视你的yield(提示性,并非强制)
notify和notifyAll区别
notify随机唤醒监视器_WaitSet中的一个线程 notifyAll唤醒所有等待池中的线程,把这些线程都移入到锁池(EntryList)
//被唤醒的线程要去抢锁,加入到_EntryList中等待抢锁
synchronized(lock){
this.notifyAll(); //Set
// this.wait(); // 各自线程中wait // this.wait(); // this.wait(); } 99%的场景使用notifyAll()
数据结构: _WaitSet: 循环双向链表 _EntryList:双向链表
一个线程结束后可以再次执行start吗?
不可以。 一个Thread只能被start一次,如果再次执行start就会抛异常 IllegalThreadStateException。(源码中告诉我们一个新的线程的threadStatus=0,一旦执行过start这个值就会被VM修改,而且不可逆)
Java线程设计状态是单项流转:NEW->RUNNABLE->TERMINATED(终点) 没有复活机制的。
线程编排
1.创建
CompletableFuture
2.回调/消费 thenApply / thenApplyAsync异步版本 映射T->U thenAccept/ thenAcceptAsync 消费T,无返回 thenRun / thenRunAsync 只运行,无返回
3.批量 allOf() 等待所有任务执行完 anyOf() 等待任意一个任务执行完
4.阻塞操作 get() 获取返回值,检测异常 join() 获取返回结果,不检测异常
5.异常处理 exceptionally 异常执行 handle 失败或者成功都处理 whenComplete 类似finally都完成了执行
方法相关
线程隔离
隔离是为了线程之间数据被污染,要隔离 ThreadLocal可以干这件事,每个线程中都有一个副本,不是传递而是隔离,ThreadLocal副作用是可能会产生内存泄漏,key是弱引用 value强引用
引用类型:
1.强:只要还用着就不会释放
2.软:内存不足OOM之前 OutOfMemory
3.弱:下一次GC发生,所有的弱引用都会被放着WeakHashMap中, 但是特殊情况:String s= “hello” //hello在常量池
WeakReference
GC: majorGC: (major主要的) 老年代GC minorGC:(minor次要的)新生代(Eden+Survior区) fullGC: (全堆GC) 整个堆+元空间/永久代(框架class)
线程传参的特殊案例
@Data public class User{ private String name; }
user.setName(“zs”);
new Thread(()->{ public void run(){ user.setName(“lisi”); } }).start();
Thread.sleep(100);
String name = user.getName(); // 问name现在是zs还是lisi? ①zs,因为主线程zs,子线程lisi,分别执行在自己的线程内,CPU缓存区,如果两个线程是由2个内核分别执行,分别把zs和lisi缓存在自己内核中,那么主线程可能拿到的还是zs ②lisi,主线程和子线程使用的是同一个CPU缓存,那么主线程拿到的就是lisi 解决方案是 ①使用volatile关键字修饰name ②User类定义为Record不可变对象 ③加锁使用 ④AtomicReference原子引用类
线程终止的方式
一 线程业务 1.过期处理 (永远不要使用此方式,会把共享对象的状态处于不一致的情况) stop() 停止 -> resume(); 停止,suspend()挂起给唤醒以后停止 2.线程的interrupt() + isInterrupted()检测 捕获异常 3.使用volatile关键字+标志位 volatile flag=true; // 监听标志位 new Thread(()->{ while(flag){…} }).start(); // 改标志位 new Thread(()->{… flag=false;}).start();
二 线程池 shutdown() 停止
三 IO阻塞 可以使用定时器线程,倒计时,到时间以后ioStream.close() /socket.close()
四 守护线程的自动消亡 thread.setDaemon(true) 主线程执行完后不会等待守护线程
死锁的四个条件
必须条件: 1.互斥 2.保持并请求 3.不可剥夺 4.循环等待
解决:打破2,3,4必要条件 2.保持并请求 ① 一次性请求所有的锁 (实际比较困难) ② 在你请求锁前,释放你持有的锁 3.不可剥夺 使用tryLock尝试获取,抢不到就不抢了 4.循环等待 按顺序加锁
7个核心参数
1.核心线程数 2.最大线程数 3.空闲时间 4.空闲时间单位 5.等待队列线程池工厂 6.线程工厂 7.拒绝策略
工作流程: 1.开始线程池是空的 2.任务来 -> 创建线程到核心线程数 3.核心满了 -> 等待队列 4.队列满了 -> 最大线程数 5.最大线程数满了 -> 拒绝策略处理
4个拒绝策略
AbortPolicy(中止策略)—— 默认行为,快速失败 抛异常,丢弃任务
CallerRunsPolicy(调用者运行策略)—— 生产环境最推荐 不丢也不抛异常,任务从哪来回它的调用者线程去执行
DiscardPolicy(丢弃策略)—— 静默杀手,极不推荐 啥也不干,直接丢,也不抛异常,不记录日志
DiscardOldestPolicy(丢弃最老策略)—— 最冤枉的策略 丢弃等待最久的任务,尝试提交当前新任务
大厂必杀: 自定义策略:目标任务持久化+补偿重试 1.任务存入redis/mysql 持久化了 2.记录失败日志,触发告警 3.启动一个补偿线程来执行任务,稍后重试
4个等待队列
ArrayBlockingQueue:有界队列 LinkedBlockingQueue:链表队列,可选有界/无界 SynchronousQueue:同步移交队列 (没有容量,放一个拿一个) PriorityBlockingQueue:优先级队列,无界堆结构,按优先级排序 DelayedWorkQueue用户处理ScheduledThreadPoolExecutor定时任务的内部专属队列
线程数到底应该多少
CPU密集型任务(加密/解密/大量数学运算) 核心=CPU内核数+1 (服务器挂了20个CPU/16核 = 320+1) 最大=CPU内核数+1 (服务器挂了20个CPU/16核 = 320+1)
IO密集型任务(文件,IO,数据库读写多) 核心=2CPU内核数 (640) 最大=4CPU内核数 (1280)
大厂公式: 核心=CPU核心/(1-阻塞系数),比如阻塞系数0.8,4个内核20个线程
理想化公式: 最佳线程数 = CPU核心数 × (1 + 线程等待时间 / 线程计算时间)
面试题: 核心线程数,最大线程数的指标如何得到的? 压力测试/冒烟测试等根据流量来得到的最佳值,而且不同的业务类型匹配不同的策略
JUC
ConcurrentHashMap的原理
ConcurrentHashMap的原理
JDK7:segment锁段+Lock
主要组成:主要是由分段锁(Segment)和链表数组(Entry[])组成,Segment 本质上是一个 “子哈希表”,它继承自 ReentrantLock(可重入锁),因此每个 Segment 自身就是一把锁。将整个存储空间分成多个段Segment,每个段都维护着一个独立的链表数组。每个段都拥有自己的锁,因此不同的线程可以同时对不同的段进行操作,从而实现并发访问。
访问流程:当一个线程需要访问某个元素时,首先需要根据元素的哈希值定位到对应的段,然后获取该段的锁。获取锁后,线程会在该段对应的链表上进行插入、删除或者查找操作。这样做的好处是,不同线程对于不同段的操作不会相互阻塞,提高了并发性能。
缺点:并没有解决并发访问时链表造成的性能问题。当多个线程同时修改同一个段的链表时,可能会导致链表成为热点,并发性能下降
JDK8:;它摒弃了Segment(锁段)的概念,利用 volatile + CAS 实现;JDK8还引入了Node 和 TreeBin 来表示键值对的存储。Node 是链表节点,TreeBin 是红黑树节点。这些节点都通过 CAS(Compare and Swap) 操作来保证并发安全性。
扩容机制:JDK8还引入了一种新的扩容机制,使用了无锁算法来提高并发性能。同HashMap
ForwardingNode 节点:表示这个桶的数据已经全部搬迁完毕了。其哈希值固定为 -1。应用场景:在多线程协同扩容(Help Transfer)**时,线程每迁移完一个桶,就会在老数组对应位置放一个 ForwardingNode。
ReservationNode 节点:一个临时的“哨兵”锁定节点。其哈希值固定为 -3。作用:在执行计算函数的耗时期间,先往空桶里塞入这个节点占位。防止其他线程趁虚而入抢写这个空桶,保证了原子性计算的绝对安全。
线程安全
JUC辅助类
锁降级
从写锁降级成为读锁。在当前线程拥有写锁的情况下,再次获取到读锁,随后释放写锁的过程。 获取写锁->获取读锁->释放写锁->释放读锁 在获取读锁后直接释放写锁 对于ReentrantReadWriteLock,支持锁降级,不支持锁升级。不可以在读锁没有关闭的情况直接上写锁。
阻塞队列
阻塞队列主要在生产者/消费者的场景使用 当一个线程试图对一个已经满了的队列进行入队列操作时,它将会被阻塞,除非有另一个线程做了出队列操作;同样,当一个线程试图对一个空队列进行出队列操作时,它将会被阻塞,除非有另一个线程进行了入队列操作
1.ArrayBlockingQueue:由数组结构组成的有界阻塞队列 2.LinkedBlockingQueue: 由链表结构组成的有界阻塞队列 3.PriorityBlockingQueue: 支持优先级排序的无界阻塞队列 4.DelayQueue:使用优先级队列实现的延迟无界阻塞队列 5.SynchronousQueue:不存储元素的阻塞队列,也叫做单个元素队列 6.LinkedTransferQueue:有链表组成的无界阻塞队列
CAS
CAS: compare and swap 比较并交换 CAS主要是用来保证原子性的技术,基于乐观锁实现的
CAS操作主要有3个参数: 内存地址A, 旧值B,新值C 将指定内存A的内容 跟 旧值B 进行一个比较, 如果相等,则替换为 C, 如果不等,自旋。
CAS底层采用 native方法(C/C++来实现的),具体为 sun.misc.Unsafe 类,他的操作是原子性的,CAS只能保证单个变量的原子性,如果同时修改多个字段,就不能直接用CAS,此时可以用AtomicReference包装一个不可变对象,通过 CAS 整体替换
副作用: 1.ABA问题: 场景: 线程 P1 读取变量值为 A。 P1 被切换出去,线程 P2 将 A 改成 B,又改回 A。 P1 回来继续执行,发现值还是 A,CAS 成功。 针对这种情况,可以采取 加版本号(或者时间戳)
2.自旋开销 CAS失败后, 他就会进行 循环处理(自旋), 产生极大开销 解决方案: 升级为锁, 极端竞争场景下, 先内部进行CAS乐观尝试,失败后,此时坚持无锁CAS就是负优化,之后让线程挂起等待(阻塞),让出CPU给其他真正干活的线程,整体效率更高, 不是一上来就是挂起的,有过程: 偏向锁-> 轻量级锁(自旋)->重量级锁(挂起)
AQS
一、AQS是什么 AbstractQueuedSynchronizer,抽象队列同步器,是用来构建锁或其他同步组件的基础框架,核心思想:用一个 volatile int state 表示同步状态,通过一个内置的 FIFO 双向队列 管理等待线程,使用 CAS 原子修改状态。
二、核心三要素 state: volatile int,表示同步状态(锁是否被持有、信号量剩余许可数等),通过 getState(), setState(), compareAndSetState() 操作。
CLH 队列变种: 一个虚拟的双向链表,存放获取锁失败的线程;头节点是当前持有锁的线程,新节点通过 CAS 插入队尾。
CAS 操作:修改 state 的唯一途径,配合自旋实现无锁队列操作。
三、state 核心同步状态变量,volatile保证多线程间变量可见性; 不同同步器语义不同; ReentrantLock:state=0 无锁,>0 代表锁重入次数; Semaphore:state 代表剩余许可数量; CountDownLatch:state 代表剩余需要倒数的次数。
四、等待队列: 存放竞争资源失败、需要阻塞等待的线程,是FIFO 双向阻塞队列,底层由 Node 节点构成,包含 4 个关键点: ①Node 节点双向链表 ②Node 内部存储: ③head:持有资源或哨兵节点 ④tail:新节点入队位置
五、设计模式(模板方法模式) AQS 采用模板方法模式,父类定义完整获取 / 释放锁流程,子类只需要实现差异化逻辑,包含 3 个关键点: ①AQS 定义通用模板 AQS 提供acquire()、release()、acquireShared()、releaseShared()等final 模板方法,封装完整流程:竞争 state → 失败入队阻塞 → 唤醒后重试竞争 → 释放资源唤醒后继,流程固定不可重写。 ②子类实现钩子方法 AQS 定义空的抽象钩子方法,由子类重写实现自身同步逻辑: 独占:tryAcquire(int arg)、tryRelease(int arg); 共享:tryAcquireShared(int arg)、tryReleaseShared(int arg)。 tryAcquire/tryRelease 等 ③tryAcquire/tryRelease 等 核心子类钩子方法: tryAcquire:尝试独占获取资源,返回 true 代表抢占成功; tryRelease:尝试独占释放资源,返回 true 代表释放后需要唤醒后继线程; 共享配套tryAcquireShared/tryReleaseShared,适用于信号量、倒计时门栓。
六、工作流程 ①线程调用锁的lock()/acquire(),执行 AQS 模板方法; ②调用子类tryAcquire,通过 CAS 修改 state 竞争资源: 成功:直接执行业务代码; 失败:封装线程为 Node,CAS 插入等待队列 tail 尾部; ③队列内线程循环阻塞,等待前驱节点释放资源唤醒; ④线程释放锁时调用release(),子类tryRelease修改 state; ⑤state 释放完成后,唤醒 head 后继等待节点,被唤醒线程重新竞争 state。
七、 两种资源共享模式 独占模式(Exclusive):只有一个线程能获取资源。如 ReentrantLock。
共享模式(Share):多个线程可同时获取资源。如 Semaphore, CountDownLatch, ReadLock。
可同时存在(如 ReentrantReadWriteLock:写锁独占,读锁共享)。
锁
并发容器
volatile关键字
三大特性: 1.可见性:对 volatile 变量的写操作会立即刷新到主内存,读操作会从主内存读取最新值,保证一个线程修改后其他线程立即可见 2.禁止指令重排序:volatile 变量前后加内存屏障,防止编译器和 CPU 对指令重新排序,保证代码执行顺序与书写顺序一致 3.不保证原子性:volatile 只保证单次读/写的原子性,但不保证复合操作(如 i++)的原子性
核心用法: 1.状态标志位:用于线程间共享的布尔状态变量.控制线程停止 2.双重检查锁(DCL)单例:配合 synchronized 实现懒加载单例模式,防止指令重排序导致的未初始化对象引用 3.轻量级读多写少场景
内存屏障(底层原理): volatile 通过插入内存屏障实现 1.写屏障:在 volatile 写之后插入,强制将写缓冲区刷新到主内存 2.读屏障:在 volatile 读之前插入,强制使本地缓存失效,从主内存重新读取 3.禁止重排序屏障:在 volatile 变量操作前后插入屏障,阻止特定类型的指令重排序
注意事项: 1.不适用于 i++ 等复合操作 2.不能修饰数组元素:volatile修饰数组时,只保证数组引用可见,不保证数组元素可见 3.不保证最终一致性:写操作无法回滚,不适合事务性场景 4.性能开销:仍存在一定的开销(禁止缓存优化、内存屏障),比普通变量慢,但比 synchronized 快 5.64位变量特殊注意:对 long和 double 的读写本身可能分两次 32 位操作,但 JVM 规范保证 volatile 修饰的 64 位变量读写是原子操作
CopyOnwriteArraylist的原理
设计思想:读写分离,写时复制 CopyOnWriteArrayList 1.每次对集合进行写操作,不会对原容器进行修改,会复制一份副本,对副本进行写操作,再将容器的引用指向新副本;读操作时访问原来的容器 核心原则:读无锁,写加锁;读快写慢;最终一致性 2.技术细节 底层维护了一个不可变的数组(用volatile)private transient volatile Object[] array;
迭代器(弱一致性)迭代的是快照,所以迭代过程中新增删除的元素不会被迭代到 试用场景 1.读操作多于写操作 2.允许读取到旧数据(最终一致性即可) 3.不需要高并发写操作,且数组元素数量不宜过多(避免复制开销和内存占用过大)。
原子类
JUC原子类位于atomic包下,是Java并发编程中无锁并发的核心工具,解决多线程下基本数据类型、引用类型、数组、对象字段的复合赋值操作线程安全问题,全程无锁、自旋重试,保证操作的原子性、可见性、有序性
底层实现: 所有JUC原子类的底层核心均为CAS + volatile关键字
总体架构: 1.原子类: 无锁原子操作,保证线程安全
2.锁: 显式锁,提供比 synchronized 更灵活的锁机制
3.同步工具: 线程间协调与通信
4.线程池: 管理线程生命周复用期,线程资源
5.阻塞队列: 线程安全的生产者-消费者队列
6.并发集合: 线程安全的容器
7.Fork/Join: 分治并行计算框架
原子类整体分类:
- 基本类型原子类*:操作基本数据类型数值
- 数组类型原子类:操作数组中元素的数值
- 引用类型原子类:操作对象引用,实现对象整体原子更新
- 对象字段原子更新器:精准更新对象的某个成员字段,节省内存
- 累加器/计数器原子类(JDK8+):高并发场景专用高性能计数器
优点:
- 无锁操作,不触发线程阻塞、上下文切换,并发性能优异;
- 基于CAS自旋重试,线程活跃度高,响应速度快;
- 使用简单,无需手动加锁解锁,线程安全不易出错。
缺点:
- 高并发竞争激烈时,CAS自旋会消耗大量CPU资源;
- 仅支持单个变量原子操作,无法实现多变量复合原子逻辑;
- 基础原子类存在ABA问题,需额外使用带版本戳的原子类解决;
- LongAdder等累加器不保证实时数据精准性。
高频面试核心要点
- 原子类底层是CAS+volatile,非锁机制属于乐观锁 2.CAS三大问题:CPU自旋、多变量不支持、ABA 3.JDK8 LongAdder分段锁思想是高并发计数最优方案 4.原子类仅保证操作原子性,不保证业务整体事务一致性,复杂并发场景仍需锁
JMM
一、JMM是什么 JMM,Java内存模型,抽象规范,屏蔽硬件差异,定义共享变量的访问规则
二、三大问题 可见性:一个线程的修改,另一个线程能立即看到。 有序性:指令重排导致多线程执行顺序错乱。 原子性:非 JMM 核心目标,但 JMM 规定了基本原子操作范围。
三、内存抽象结构
主内存:共享变量存储区。
工作内存:线程私有,持有变量副本
线程操作变量必须经过主内存↔工作内存的交互。
两个规定:
- 线程对共享内存的所有操作都必须在自己的工作内存中进行,不能直接从主内存中读写;
- 不同线程无法直接访问其他线程工作内存中的变量,因此共享变量的值传递需要通过主内存完成。
四. Happens-Before 规则 JMM 判定数据竞争和排序的核心依据 程序次序规则 监视器锁规则 volatile 变量规则 传递性 A hb B, B hb C ⇒ A hb C。 start() 规则 join() 规则 线程中断规则 对象终结规则
五. 两个核心关键字 volatile:保证可见性 + 禁止指令重排(通过内存屏障)。不保证原子性。典型用法:状态标志、DCL 单例。 synchronized(锁):同时保证原子性、可见性、有序性。释放锁时刷新主内存,获取锁时清空工作内存。
六、关键内存屏障 volatile用到 4 种屏障,理解“写后刷新、读前失效”即可 StoreStore、StoreLoad、LoadLoad、LoadStore。(store:写,load:读 ) volatile 写插入 StoreStore + StoreLoad;volatile 读插入 LoadLoad + LoadStore。
七、一个经典案例:DCL 单例为什么要 volatile private volatile static Singleton instance; 防止 instance = new Singleton() 被重排为“先分配内存引用,后初始化对象”,导致其他线程拿到未完成的对象
虚拟线程(Virtual Threads)
HashMap原理
1.基本定义 HashMAP:是基于哈希表的 Map 接口实现,存储键值对(Key-Value)数据结构,允许 null 键和 null 值
HahMap底层就是通过一个数组,来储存我们所有的元素。数组初始大小为16,也可以通过new HashMap的时候指定大小。
JDK7是entry对象;JDK8是node对象
四个属性:hash,key,value,next(当前元素指向下一个元素的指针)
影响hash性能原因1 哈希算法的优劣2 加载因子的大小3 碰撞后的处理方式
升级;条件:只有当前链表长度达到8个,数组长度达到64个才会升级,
扩容:条件:链表长度到达八个,数组长度未达64。 这时,再往链表长度为8的桶上放元素,就会进行扩容,或者到达扩容阈值(默认12),就是达到数组长度*加载因子(默认0.75),具体是老数组长度翻一倍形成新数组
扩容机制:JDK1.7:hash值重新取模你的新数组长度,就是rehash,优点:分布均匀;JDK1.8会通过位运算符跟老数组长度进行运算,如果等于16,认为是高位元素,小于16就算低位元素,地位元素会保留原来位置,高位元素是元位置加上扩容的的长度,优点:性能高一点)
降级:从红黑树降到链表:当 HashMap 进行翻倍扩容时,原本挂在同一个红黑树下的节点会被重新分配(Rehash)到新数组的高位桶和低位桶中: 拆分结果:一棵树会被拆分成两条新的节点链(低位链、高位链)。 退化判定:拆分后,如果其中某一条链上的节点数量 小于等于 6(UNTREEIFY_THRESHOLD = 6),那么这个分支就不会再保持红黑树结构,而是直接调用 untreeify() 方法,退化还原为普通的单向链表。
在“删除元素(remove())”时 如果您不断地从 HashMap 中 remove 元素,导致原本已经是红黑树的桶(Bucket)里的节点越来越少,红黑树也会触发退化。
JDK 1.7:并发扩容时采用头插法,会颠倒原有链表的顺序。多线程同时扩容时,极易形成环形链表(死循环),导致下一次 get() 时 CPU 直接飙死到 100%。 JDK 1.8:改用尾插法,保持了链表的原有相对顺序,彻底解决了死循环问题。
特殊的 null 键存放位置 当 Key 为 null 时,它的 hash 值被硬编码强制设为 0。因此,null 键对应的节点永远固定存放在数组的第一个位置(即 table[0] 的桶里)。
线程同步
线程同步:用来控制多个线程访问共享资源的“先后顺序”和“动作时序”,从而保证程序在并发环境下能得出正确的结果 1.sync锁 方法1:使用synchronized代码块: 语法结构: synchronized(同步监视器){ 同步代码 } 同步监视器:1.引用类型 2.可以改变锁对象的值,不能改变引用,可以final修饰锁 3.String和包装类不能用 最好用共享资源做锁对象 同步代码块中能发生CPU切换吗?能 但是后续的被执行的线程也无法执行同步代码块(锁仍旧close)
方法2:使用synchronized方法: 用锁把整个方法锁住 synchronized实现同步的基础:Java中的每一个对象都可以作为锁。具体表现为以下3种形式:
- 对于普通同步方法,锁是当前实例对象this。
- 对于静态同步方法,锁是当前类的Class对象。
- 对于同步方法块,锁是synchonized括号里配置的对象
2.lock:三个实现:ReentrantLock、ReentrantReadWriteLock.ReadLock、ReentrantReadWriteLock.WriteLock Lock接口里获取锁的方法: lock()\unlock:获取锁,已被获取需要等待,,需要主动释放锁,将释放锁的操作放在finally块中进行,以保证锁一定被被释放,防止死锁. trylock():有返回值Boolean,表示尝试获取锁,不会一直等待 tryLock(long time, TimeUnit unit)拿不到锁时会等待一定的时间,在时间期限之内如果还拿不到锁,就返回false。如果如果一开始拿到锁或者在等待期间内拿到了锁,则返回true lockInterruptibly():通过这个方法去获取锁时,如果线程正在等待获取锁,则这个线程能够响应中断,即中断线程的等待状态
ReentrantLock可重入锁: ReentrantLock内部维持一个锁的计数器,初始值为0。每次执行lock()后,计数加1,每次执行unlock()时计数减1。可以通过ReentrantLock的getHoldCount()获取当前计数器的值
ReentrantReadWriteLock读写锁:针对这种读多写少 读写锁允许同一时刻被多个读线程访问,但是在写线程访问时,所有的读线程和其他的写线程都会被阻塞 从一个ReadWriteLock中多次获取的ReadLock、WriteLock是同一把读锁,同一把写锁,都是重入锁,读共享,写独占
线程通信
线程通信:多个线程间怎么把活干完 1.生产者与消费者;wait(),notify()唤醒 1)先线程同步,再通信 2)生产者消费者被wait()阻塞,被唤醒是从wait()下继续执行,不是从同步块开始
多个线程出现的问题 虚假唤醒:唤醒条件没满足,但是唤醒了 原因: 1.if进行判断 解决方法:while循环 2.notify()生产后又生产,消费后又消费(生消在同一队列等待) 解决方法:notifyAll() 法2:lock接口里newCondition(),Condition接口里有await(),signal(), signalAll()更加清楚的控制多线程的休眠和唤醒。 对于同一个锁;可以定义不同的conditon,在不同的情况下用不同的conditon。 一个condition包含一个等待队列。 调用await(),signal(),signalAll()需要在lock的临界区里
CountDownLatch
核心:一等多
CountDown是计数递减的意思,Latch是门闩的意思,CountDownLatch是一个非常实用的多线程控制工具类,底层是基于AQS实现
工作流程:它内部维护一个递减的计数器,比如刚开始有n个门闩,当它递减到0的时候就会阻塞执行后续的操作
常用方法: 1.new CountDownLatch(int count) 实例化一个倒计数器,count指定初始计数 2.countDown() 每调用一次,计数减一 3.getCount() 获取当前计数器的值 4.await(时间) 等待,当计数减到0时,阻塞线程并行执行
注意事项: countDown() 方法应在 finally 块中调用,以确保即使在任务执行异常时也能递减计数器,避免主线程永远阻塞
优点:
1.解耦灵活:不关心谁调用countDown(),任意线程或外部事件都可触发,无需持有具体线程引用
2.支持使用线程池
3.超时控制:await(timeout) 避免永久阻塞,支持超时降级处理。
4.同时唤醒多个线程:所有等待线程在计数器归零时被一次性唤醒
5.轻量高效:底层基于AQS实现
缺点; 1.不可重置:门闩只能使用一次 2.无法获取已完成数量:无法查询已有多少个任务完成,只能获取剩余计数 3.不区分完成状态:无法知道哪些任务成功、哪些失败,只能知道“计数归零”这一事件 4.线程中断不自动递减:等待线程被中断时,计数器不会自动减少,需业务代码自行处理
面试:CountDownLatch 与 join 方法的区别
CountDownLatch 等待的是计数器归零这一事件,解耦灵活,支持线程池和超时,但不可重置。 join()等待的是具体线程对象死亡,必须持有线程引用,只能等线程结束,不支持线程池,但可多次调用等待不同线程
CyclicBarrier
核心:多等多
这个类的中文意思是“循环栅栏”。意思就是一个可循环利用的屏障,它的主要作用是在多个线程相互等待达到某个共同点之后再一起继续执行
它内部也有一个计数器,初始值是在构造时指定。CyclicBarrier 是一个同步辅助类,通常用于协调多个线程之间的任务分配和执行
核心方法: 1.CyclicBarrier(int parties):构造方法,指定需要等待的线程数量 2.await():当前线程到达屏障点并等待,直到所有线程都到达 3.wait(long timeout, TimeUnit unit):带超时的等待,超时后抛出 TimeoutException,同时屏障被破坏 4.reset():手动重置屏障到初始状态,正在等待的线程会抛出 BrokenBarrierException 5.getNumberWaiting():获取当前正在屏障处等待的线程数 6.isBroken():判断屏障是否被破坏
使用场景: 1.并行计算分阶段汇总:多个子线程各自计算一部分,全部到达屏障后由屏障动作汇总结果,然后继续下一阶段计算 2.多线程分步处理:将一个大任务拆分为多个阶段,每个阶段所有线程完成后再进入下一阶段
特点: 1.可重用:计数器归零后自动重置,可反复使用,适合分阶段任务 2.屏障动作:最后一个到达的线程负责执行预定义的 Runnable,可用于聚合结果或执行收尾操作 3.互相等待:所有线程都在等待彼此,任何一个线程在等待过程中被中断或超时,屏障会被标记为“破坏”(broken),其他线程会抛出 BrokenBarrierException 4.基于 ReentrantLock + Condition实现
注意事项: 1.线程数必须匹配:await() 调用次数必须达到 parties 值,否则所有线程永久阻塞 2.屏障破坏处理:当某个线程在 await()时被中断或超时,屏障进入“broken”状态, reset()恢复
Semaphore
核心:限制并发数量
CountDownLatch和CyclicBarrier的计数器递减的,而Semaphore的计数器是既可以递增也可以递减,并可指定计数器的初始值
Semaphore可以控制同时访问的线程个数。非常适合需求量大,而资源又很紧张的情况。底层是基于AQS实现的
核心方法: 1.Semaphore(int permits, boolean fair):构造方法,permits指定初始许可证数量 ,fair指定公平/非公平锁, true 代表公平锁,false 代表非公平锁 ,默认是非公平锁 2.acquire():获取一个许可证,若无则阻塞 ,里面可以放数字 3.release():归还一个许可证 ,里面可以放数字 4.tryAcquire():尝试获取,成功返回 true,失败立即返回 false(不阻塞) ,里面可以放时间以及时间单位
使用场景: 1.数据库连接池限流:控制最大并发连接数 2.接口限流/QPS控制:限制同时处理请求数,保证系统不会被压垮 3.多资源并发访问控制:限制同时访问某个共享资源的线程数量
注意事项: 1.许可证归还必须匹配:release() 次数必须等于 acquire() 次数,否则许可证数量会逐渐累积或耗尽 2.finally 块释放:确保获取许可证后一定释放,避免泄漏 3.批量获取需谨慎:acquire(10)要求一次性获取 10 个许可证,若不足则阻塞,可能降低并发度。通常用单个许可证循环获取更灵活
虚拟线程的价值
虚拟线程Java21 推出的JVM 轻量级线程,由 JVM 自己管理,在java中线程跟系统线程是一一对应的。不跟操作系统内核线程一对一绑定;少量操作系统真实线程,就能承载几十万、上百万虚拟线程。在jdk21升级之后是最重要的一个功能。
核心价值
-
抹平并发编程复杂度
不用再手动调线程池核心数、队列、拒绝策略,不用 CompletableFuture、响应式编程(Reactor/RxJava)就能轻松实现十万、百万级并发,保持同步阻塞编码习惯。
-
大幅提升 IO 密集型服务吞吐量
数据库、RPC、HTTP、消息队列等等待型业务,传统平台线程受操作系统线程上限限制,虚拟线程几乎无数量瓶颈。
-
降低高并发系统运维成本 省去线程池参数调优、线程泄露排查、阻塞线程耗尽等线上故障;栈追踪、ThreadLocal、同步锁
4.统一同步编程范式,抛弃响应式学习成本
传统高并发两条路:
- 线程池同步:并发量上不去;
- 响应式异步:代码晦涩、调试难、学习成本极高;
相关面试题
有了虚拟线程还需要线程池嘛
先说结论:不能完全替代,两种线程池依然必不可少
使用场景 虚拟线程:Web 接口、RPC 调用、DB 查询、文件 IO、批量推送等 IO 密集业务
平台线程池:大数据计算、加密、循环运算、离线同步等 CPU 密集任务、需要限流场景
二者最佳搭配方案 接口、RPC、数据库查询(IO 密集):用虚拟线程执行器,简化开发,提升吞吐量
基本类型原子类
核心类:AtomicInteger、AtomicLong、AtomicBoolean,仅支持int、long、boolean三种基本类型。
核心方法: 1.get():获取当前最新值 2.set():直接设置新值(非原子,不推荐并发使用) 3.getAndIncrement():先获取值,再自增(等价于i++,原子操作) 4.incrementAndGet():先自增,再获取值(等价于++i,原子操作) 5.getAndDecrement()/decrementAndGet():原子自减操作 5.compareAndSet(int expect, int update):核心CAS方法,预期值匹配则原子更新 6.getAndAdd()/addAndGet():原子累加指定数值
数组类型原子类
核心类:AtomicIntegerArray、AtomicLongArray、AtomicReferenceArray
作用:实现数组单个元素的原子更新,数组整体不保证线程安全,仅针对下标元素操作原子。
特点:无需遍历加锁,可精准对数组指定下标元素做原子增减、更新操作,并发处理数组数据效率更高
引用类型原子类
核心类:AtomicReference、AtomicStampedReference、AtomicMarkableReference
AtomicReference:通用对象引用原子类,实现任意对象引用的CAS更新,仅对比引用地址,无法解决ABA问题。 -AtomicStampedReference:带版本戳的引用原子类,通过「引用值+版本号」双重校验,彻底解决ABA问题,每次更新版本号自增。 AtomicMarkableReference:带标记位的引用原子类,通过布尔标记位记录对象是否被修改,无需记录版本次数,节省内存,仅判断状态不判断次数。
对象字段原子更新器
核心类:AtomicIntegerFieldUpdater、AtomicLongFieldUpdater、AtomicReferenceFieldUpdater
作用:动态更新普通对象的volatile成员字段,无需创建原子类对象,直接操作原有对象字段,节省内存开销。
使用硬性条件:
- 被更新字段必须被volatile*修饰
- 字段必须是非static、非final
- 字段访问权限需匹配(通常为public)
适用场景:对象仅个别字段需要并发更新,无需整体原子包装,轻量化并发场景
累加器/计数器原子类
核心类:LongAdder、DoubleAdder、LongAccumulator、DoubleAccumulator
作用:解决AtomicLong高并发下CAS自旋频繁、CPU消耗高的问题,是超高并发计数器的最优选择
核心原理: 分段累加 摒弃单一value变量,将数据拆分到多个Cell数组分段存储,多线程并发修改不同Cell,减少CAS竞争;最终汇总所有Cell值得到最终结果,大幅提升并发吞吐量。
理解虚拟线程
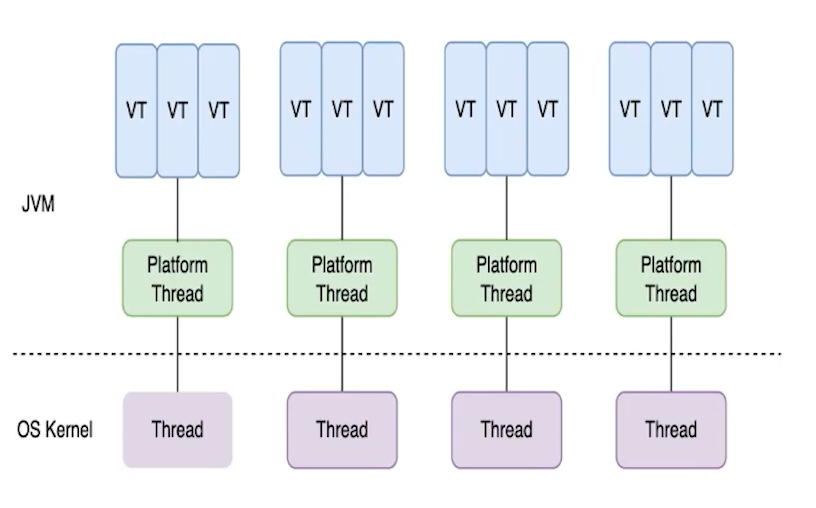
案例,学校接到一个任务写一万份学生评语,传统的Thread的线程一个任务交给一个人干,现在有了虚拟线程然后把任务分发成一个个小任务,每个学生老师都分一部分任务。如果有人干不了的话就换其他人去干,对外还是一个任务。
虚拟线程
底层:图结构底层:OS 内核线程(紫色框)= 工厂真实工位
-
机器 CPU 只认它,操作系统给工位分配干活时间;
-
工位成本极高,工厂不能随便建几百上千个,一般就几十个、几百个封顶;
-
一个工位同一时间只能有 1 个人干活。 中层:Platform 平台线程(绿色框 = 载体)= 固定工人
-
每个工人永久占一个工位,1 个人绑定 1 个工位;
-
传统代码就是直接让这些工人干业务:
工人去仓库拿货(IO / 查数据库)等待的时候,工位空着也没法给别人用,纯浪费。
上层:VT 虚拟线程(浅蓝色)= 无数张任务工单
- 工单超级轻,打印一张几乎不花钱,想印十万张都没问题;
- 工单本身不能直接上工位干活,必须交给中层固定工人拿着工单去工位执行。
虚拟线程执行器算不算线程池?和传统线程池差异
算特殊调度器,但和线程池完全不同:
-
不复用虚拟线程,每条任务新建 VT,用完销毁;仅复用底层载体
-
无并发上限,无核心 / 最大线程、队列、拒绝策略配置
-
虚拟线程执行器:每提交一个任务,新建一条独立虚拟线程,执行完毕直接销毁,不存在线程复用、无核心 / 最大线程概念,没有池化复用逻辑。
-
传统线程池:复用固定数量平台线程,主动限制并发,线程是池内资源,反复回收复用,有最大容量限制
同步锁和Lock锁
一、JVM级别的锁 二、JDKAPI级别的锁 同步锁(synchronized) Lock锁 可重入锁 可重入锁 隐式锁 显式锁 取决于JVM底层的实现,不灵活 可以提供多种锁方案供选择,更灵活 发生异常会自动释放锁 发生异常不会自动释放锁,需要在finally中释放锁 独占锁 WriteLock 独占锁 ReadLock 共享锁 同步监视器对象头里面的markword字段 底层是AQS(state属性+双向链表) 可以锁方法、可以锁代码块 只可以锁代码块 仅支持非公平锁 可支持公平锁、非公平锁
锁升级
sync锁在JDK1.6之前是重量级锁,之后引入了如下锁 其中偏向锁在JDK15之后被淘汰 锁升级不可逆,只能升级不能降级
无锁(001) 对象刚被创建时,没有线程对其进行同步访问时的状态。
偏向锁(101) 只有一个线程访问同步资源 修改对象头的MarkWord 标志位,并写入线程ID
轻量级锁(00) 轻度竞争,自旋锁 使用CAS尝试将MarkWord中的所标志位修改为00,如果成功则获得锁,反之自旋
重量级锁(10) 重度竞争、操作系统内核态、Monitor对象及其等待队列、阻塞 多个线程同时激烈竞争同步资源时,从轻量级锁升级为重量级锁, 对象头的 MarkWord 会指向一个 “重量级锁对象(Monitor)”。 未获取到锁的线程会被阻塞(进入操作系统内核态),放入 Monitor 的等待队列 直到持有锁的线程释放锁后,由操作系统唤醒队列中的线程重新竞争。
平台线程和虚拟线程的核心区别
核心区别
-
映射:平台 1:1 绑定 OS 内核线程;虚拟 M:N 动态复用载体 M:N就是多条虚拟线程共享少量 OS 平台线程;虚拟线程阻塞时让出载体,载体去执行其他就绪虚拟线程。
-
资源:平台栈固定 1MB、重量级;虚拟栈动态伸缩、百万级无 OOM
-
阻塞:平台阻塞占死 OS 线程;虚拟阻塞释放载体线程
-
数量:平台上限几千;虚拟支持数十万、百万级
锁的分类
JVM级别的锁 同步锁(synchronized) 无锁、偏向锁、轻量级锁、重量级锁
自旋锁
循环+不阻塞=自旋,CAS 就是典型自旋
自旋次数:一、jdk1.6之前是默认10次
二、jdk1.6及以后是自适应策略动态变化 决策由上一次历史决定,若上一次成功,本次会增加自旋次数,若上次失败,则会减少自旋,甚至跳过自旋升级为重量级锁
可重入锁 定义:同一把锁可以使用多次。比如说多层同步块使用同一把锁。 基于 AQS 的state字段。state=0无锁,同一线程加锁 state++,释放 state—。
公平锁 定义:线程严格按照请求顺序获取锁,先到先得。 AQS 中维护 CLH 队列,新线程必须检查是否有前驱节点,有则入队等待,不会尝试抢锁。
非公平锁 定义:新线程允许在释放锁的瞬间直接抢锁(插队),不必先入队。 先进行抢锁,抢锁失败后到队列中排队
独占锁 定义:同一时刻仅允许一个线程持有。 synchronized ReentrantLock WriteLock
共享锁 定义:多个线程可以同时持有,只要没有写操作。 特性:允许多个读线程并发,提升读多写少性能。 ReadLock
悲观锁
定义:总是假设最坏情况,认为冲突一定会发生,访问资源前先加锁。
synchronized、ReentrantLock、ReentrantReadWriteLock
先锁后操作。
乐观锁 定义:假设冲突很少,直接操作,提交时再检查冲突,失败则重试或回滚。 无锁化,高并发下避免阻塞。 先操作后检查。
虚拟线程的优缺点
虚拟线程优点
- IO 场景吞吐量大幅提升,无线程数量瓶颈
- 同步编码,无需回调 / 响应式,改造成本极低
- 零参数配置,不用调试线程池参数
- 内存开销极小,硬件资源利用率更高
虚拟线程的缺点
- 不适合 CPU 密集型任务
- 原生未改造的 native 阻塞方法不会释放载体,丧失优势
- 无线程优先级,JVM 会忽略设置
- ThreadLocal 极易内存泄漏,推荐 ScopedValue 替代
- 无内置限流,突发流量会打垮下游服务
ThreadLocal 在虚拟线程有什么坑?怎么解决?
坑:VT 可达百万级,每个线程持有大对象会造成严重内存泄漏。 方案:
- 使用完手动 remove ();
- Java21 配套 ScopedValue;
代码
EntryList和CLH变种双向队列的区别是什么
EntryList CLH
所属 同步sync的monitor JUC并发包
代码 C++ Java
数据结构 双向链表 双向链表
并发控制 操作系统的互斥量+线程阻塞 CAS自旋+unpark/park
线程状态不同 BLOCKED WAITING/TIMED_WAITING
公平 不公平 都可
JVM
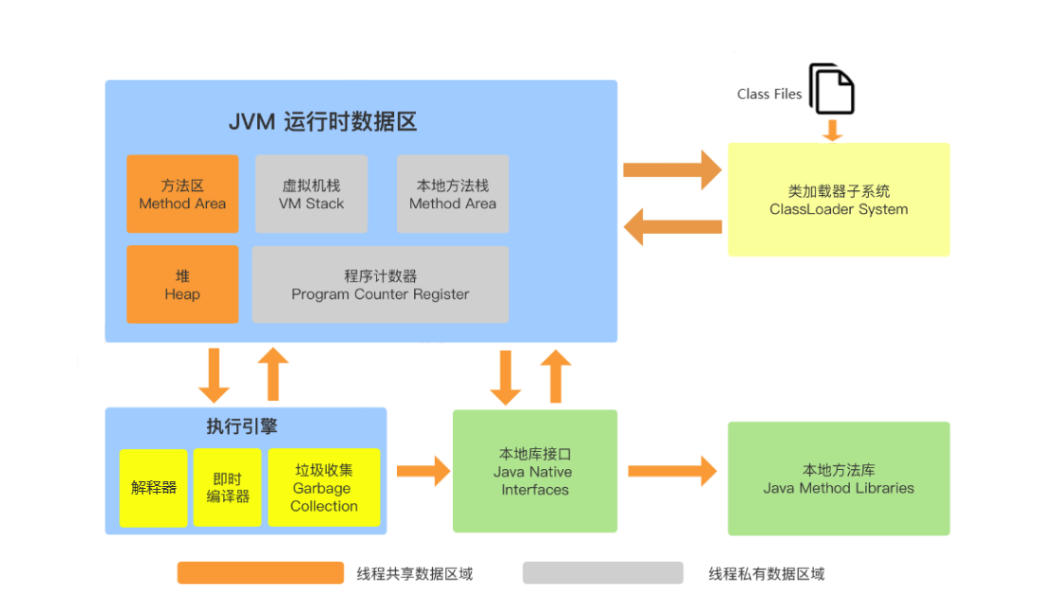
java virtual machine java程序的运行环境
Java虚拟机在执行字节码时,把字节码解释成具体平台上的机器指令执行。“一次编译,到处运行”
- JDK java 程序的开发
- JRE 运行 class文件
- JVM
- JRE 运行 class文件
运行过程:Java代码->字节码->类加载器->运行时数据区->执行引擎->交给cpu执行 过程中需要调用其他语言的本地库接口来实现整个程序的功能
类加载子系统:ClassLoader:由类加载器执行 执行引擎子系统:ExecutionEngine
五部分组成
堆
功能:JVM中最大的内存区域,用于存储对象实例和数组。所有线程共享,适合动态分配内存。堆分为新生代(堆内存的1/3,伊甸园区和存活区8:1:1,年龄15再清进入老年代) 老年代(堆内存的2/3)
初始堆大小:实际物理内存的1/64,最大:1/4
内容: 创建对象实例:通过new关键字创建的对象。 存储数组:存储所有类型的数组 GC:堆中的内存管理是JVM的主要任务之一,使用不同的垃圾回收算法来回收不再使用的对象。
堆可以处于物理上不连续的内存空间中,逻辑上要连续
拓展:几乎所有对象都存在堆中,什么不会 逃逸分析+标量替换,不存在堆中,栈上分配
JDK1.6及之前:堆里放对象和数组 JDK1.6后:字符串常量池和静态变量
方法区/永久代/元空间
JVM规范中并不区分方法区和堆,只把方法区描述为堆的逻辑部分
功能:用于存储类信息、常量、静态变量、即时编译后的代码等。它是所有线程共享的内存区域。
内容: 1.类信息:存储类的结构,如类的名称、访问修饰符、父类信息、接口信息等。 2.常量池:存储编译时生成的常量,包括字符串字面量和其他基本数据类型的常量。 3,静态变量和字符串常量池:存储用static修饰的变量,这些变量在整个类的生命周期内是共享的。 4.即时编译代码
JDK1.6及之前:方法区 ,1234都有 JDK1.7:永久代+堆混合存,124在永久代,3在堆 JDK1.8及之后:元空间,弃用永久代,124都在元空间使用物理内存,3在堆中
方法区也会进行垃圾回收,特别是对于常量池中的无用常量。
虚拟机栈
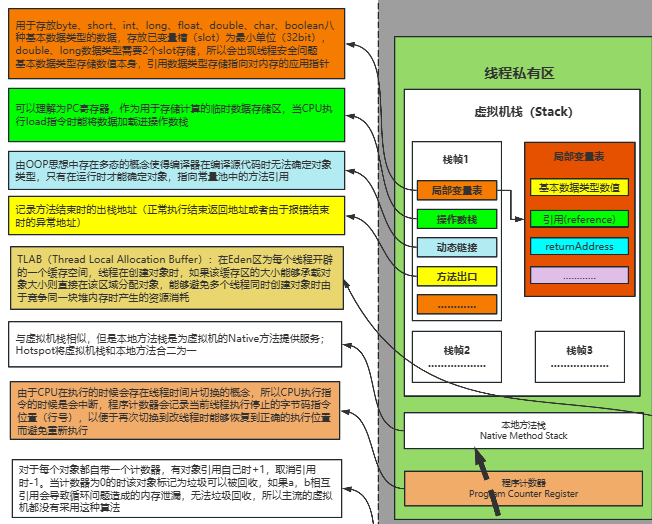
功能:每个线程都有独立的虚拟机栈,存储局部变量、方法调用和返回值。栈的生命周期与线程相同。
内容: 1.局部变量表:存储方法参数和局部变量,包括基本数据类型和对象引用。 2.操作数栈 3.动态链表 4.方法调用:每次方法调用时会创建一个栈帧,保存当前方法的信息和状态。
栈溢出:如果栈深度超过JVM允许的最大值,将会抛出StackOverflowError。
对于win/max64位:堆和栈默认1024K(1M) 1K=1024Byte
本地方法栈
功能:本地方法栈用于处理 Java 程序中调用的本地方法(Native修饰的方法)。
内容: 本地方法调用:存储本地方法的参数和局部变量。 JNI支持:可以直接调用 C/C++ 等语言编写的底层方法。 栈溢出:类似于虚拟机栈,如果本地方法栈的深度超过JVM设定的最大值,将会抛出StackOverflowError。
hotspot虚拟机把虚拟机栈和本地方法栈合二为一
程序计数器
功能:每个线程都有一个独立的程序计数器,用于指示当前执行的字节码指令的位置。它是线程私有的。
内容: 指令地址:记录当前线程正在执行的字节码指令地址。执行Native方法程序计数器为空 线程切换:当线程切换时,程序计数器的值可以帮助恢复执行状态。
jvm加载对象
解释器
解释器:当Java字节码被加载到内存中时,解释器逐条解析和执行字节码指令。解释器逐条执行字节码,将每条指令转换为对应平台上的本地机器指令。由于解释器逐条解析执行,因此执行速度相对较慢。但解释器具有优点,即可立即执行字节码,无需等待编译过程。
为什么要解释器,而不是直接执行机器码
Java的核心设计是”一次编写,到处运行”。如果编译成机器码,Windows的机器码和Linux的不一样,就得为每个平台单独编译。解释器解决了这个问题: 1.编译阶段:统一编译成平台无关的字节码。 2.运行阶段:解释器负责把字节码翻译成当前平台的机器码。 换平台只需要换解释器实现,字节码不用变,平台无关性就实现了。
两个阶段:编译和解释
编译: 1.词法分析 2.语法分析 3.抽象语法树 4.语义分析 5.注解抽象语法树 6.字节码生成器
即时编译器
一、运行流程: 核心是热点探测和性能优化 1.编译成字节码: 2.加载:虚拟机加载字节码,初期由解释器逐行执行(编译成机器码执行) 3.热点代码探测:这段代码运行时分析器进行探测,以前是1000次变成热点数据 4.即时编译优化:这段热点字节码会被编译成机器码存入缓存 5.缓存与替换:如果后续再次调用热点字节码就直接从缓存中拿机器码,不会重新编译
二、两种JIT编译器(Just in time) HotSpot JVM里有两种JIT编译器,分别对应不同的优化策略。
C1编译器(Client Compiler) 编译速度快,优化程度低。 适合启动速度快、响应时间敏感的客户端程序。
C2编译器(Server Compiler) 编译速度慢,优化程度极高(方法内联、逃逸分析、锁消除等)。 适合长期运行、追求峰值性能的服务器程序。
三、分层编译(Tiered Compilation)(分层编译是一种运行策略:决定什么时候用C1、什么时候用C2) Java 8默认开启分层编译,兼顾启动速度和峰值性能。
结合C1和C2的优势:先用C编1快速译一个版本,让程序先跑起来并收集运行数据;然后C2基于收集的数据做深度优化,编译出更优秀的机器码,替换掉C1的版本。
四、即时编译器的优化手段(面试亮点) JIT编译器之所以比解释器快得多,核心是做了大量运行时优化:
1.把小方法的调用替换成方法体中的代码 2.不逃逸的对象直接在栈上分配甚至标量替换 3.如果锁对象没有被多线程竞争,直接去掉锁。 4.重复计算的结果复用 5.根据运行时统计,调整分支执行顺序。
GC
为什么需要GC
在 C/C++ 时代,内存的申请和释放是完全由程序员手工控制的。这种方式效率高,但极易出现两个致命问题:
- 内存泄漏(Memory Leak):忘记释放,导致内存耗尽。
- 悬挂指针(Dangling Pointer):提前释放了内存,但还有指针指向那里,后续访问会导致程序崩溃或数据错乱。 Java等现代语言引入了自动内存管理。从 1995 年发布的第一个版本开始,Java 就彻底抛弃了 C/C++ 中的手动内存管理机制,直接内置了自动垃圾回收器(GC)。垃圾回收器主要负责对堆上的内存进行回收
对象内存结构
JVM 对象内存结构(HotSpot 实现)
在 HotSpot 虚拟机中,Java 对象在堆内存中的布局由三个连续部分组成:对象头(Header)、实例数据(Instance Data) 和 对齐填充(Padding)。
1. 对象头(Header)
对象头存储对象的元数据信息。在 64 位 JVM 中,其大小通常为 12 或 16 字节(开启/关闭压缩指针)。
对象头包含以下内容:
1.1 Mark Word(标记字段)
- 作用:存储对象自身的运行时数据,如哈希码(
hashCode)、GC 分代年龄、锁状态标志、线程持有的锁、偏向线程 ID 等。 - 大小:64 位 JVM 中固定占 8 字节。
- 特性:Mark Word 被设计为动态数据结构,可根据对象状态(未锁定、轻量级锁定、重量级锁定等)复用存储空间,以节省内存。
1.2 Klass Pointer(类型指针)
- 作用:指向对象的类元数据(方法区中的 Klass 结构),虚拟机通过它确定对象属于哪个类。
- 大小:
- 未开启压缩指针(
-XX:-UseCompressedOops):8 字节 - 开启压缩指针(
-XX:+UseCompressedOops):4 字节
- 未开启压缩指针(
1.3 数组长度(可选)
- 仅当对象为数组时存在,用于记录数组的元素个数(因为从元数据无法推断数组长度)。
- 大小:4 字节。
2. 实例数据(Instance Data)
这部分存储对象真正持有的有效信息,即类中定义的所有非静态成员变量的值。
- 继承顺序:父类的字段优先于子类的字段出现。
- 分配策略:HotSpot 默认将相同宽度的字段(如所有
long/double、所有int等)分配在一起,以优化内存对齐和访问效率。 - 字段重排序:编译器可能对字段顺序进行调整(在不影响语义的前提下)来减少填充浪费。
3. 对齐填充(Padding)
- 目的:HotSpot 要求对象的大小必须是 8 字节的整数倍。若对象头 + 实例数据的总长度不满足该条件,则通过填充额外的空字节来补齐。
- 作用:纯粹作为占位符,不存储任何有意义的数据。
4. 内存占用示例(64 位 JVM,开启压缩指针)
| 对象类型 | 对象头大小 | 实例数据大小 | 总大小(未对齐) | 对齐后实际占用 |
|---|---|---|---|---|
new Object() | 8 + 4 = 12 字节 | 0 字节 | 12 字节 | 16 字节 |
new Student(int id, String name) | 8 + 4 = 12 字节 | int 4 字节 + String 引用 4 字节 = 8 字节 | 20 字节 | 24 字节 |
5. 关键影响因素
- JVM 实现:不同虚拟机(如 OpenJ9、GraalVM)的内存布局策略可能不同。
- JVM 参数:
- 压缩指针(
-XX:+UseCompressedOops):可压缩 Klass Pointer 和对象引用,减少内存占用。 - 字段压缩(
-XX:+CompactFields):允许子类字段插入父类字段的空隙中,进一步节省空间。
- 压缩指针(
双亲委派机制
使用它的好处: 1.它通过委派父加载器优先加载类的方式,实现了两个关键的安全目标:避免类的重复加载和防止核心 API 被篡改。
2名.JVM 区分不同类的依据是类加上加载该类的类加载器,即使类名相同,如果由不同的类加载器加载,也会被视为不同的类。 双亲委派模型确保核心类总是由 BootstrapClassLoader 加载,保证了核心类的唯一性。
执行流程: 1.如果一个类加载器收到了类加载的请求,它首先不会自己去尝试加载这个类,会首先判断当前类是否被加载过。已经被加载的类会直接返回
2.类加载器在进行类加载的时候,它首先不会自己去尝试加载这个类,而是把这个请求委派给父类加载器去完成(调用父加载器 loadClass()方法来加载类)。这样的话,所有的请求最终都会传送到顶层的启动类加载器 BootstrapClassLoader 中。
3.只有当父加载器反馈自己无法完成这个加载请求(它的搜索范围中没有找到所需的类)时,子加载器才会尝试自己去加载(调用自己的 findClass() 方法来加载类)。
4.如果子类加载器也无法加载这个类,那么它会抛出一个 ClassNotFoundException 异常。
打破双亲委派机制:重写loadClass()方法
OOM问题
一、 OOM 类型总表
| 错误类型 | 所属内存区域 | 核心原因(一句话概括) |
|---|---|---|
Java heap space | 堆内存 (Heap) | 创建了太多对象,且无法被垃圾回收(GC)。 |
GC overhead limit exceeded | 堆内存 (Heap) | GC 一直在拼命工作,但几乎回收不了任何内存。 |
Metaspace | 元空间 (Metaspace) | 加载了太多的类,导致存储类信息的元空间被占满。 |
Direct buffer memory | 直接内存 (Direct Memory) | NIO 操作(如 ByteBuffer.allocateDirect())分配的堆外内存耗尽。 |
Unable to create new native thread | 本地内存 (Native Memory) | 系统无法再创建新的线程,通常因为线程数量已达上限。 |
StackOverflowError | 线程栈 (Stack) | 方法调用层次太深(如递归没有终止条件)。 |
PermGen space | 永久代 (PermGen) | (Java 8 之前) 存储类信息的永久代空间被占满。 |
三、通用排查思路
面对 OOM,无论哪种类型,都可以遵循以下标准步骤:
- 看日志:首先确认具体的 OOM 错误类型。
- 加参数:在 JVM 启动参数中加入
-XX:+HeapDumpOnOutOfMemoryError -XX:HeapDumpPath=/path/to/dump.hprof
以便在 OOM 发生时自动保存内存快照。 - 分析 Dump:使用 Eclipse MAT、JProfiler 或 VisualVM 等工具分析
.hprof文件,定位内存占用大户或泄漏点。 - 修代码/调参数:根据分析结果,修复代码逻辑或调整 JVM 参数。
二、深入解析
1. java.lang.OutOfMemoryError: Java heap space
- 根本原因:这是最常见的 OOM。堆内存用于存储所有创建的对象实例。当 JVM 无法为新生对象分配内存,且 GC 尝试后也无法腾出足够空间时,就会抛出此错误。
- 典型场景:
- 内存泄漏 (Memory Leak):对象被无意中长期引用,例如静态集合类(
static List/Map)只增不减、未关闭的 IO 资源(如Connection、InputStream)、未正确清理的ThreadLocal。 - 内存溢出 (Memory Overflow):应用程序确实需要处理超大规模数据,如一次性从数据库加载所有记录到内存。
- 内存泄漏 (Memory Leak):对象被无意中长期引用,例如静态集合类(
- 解决方案:使用
jmap生成堆转储(Heap Dump)文件,然后利用 Eclipse MAT、JProfiler 或 VisualVM 等工具分析,找到内存占用最大的对象及其 GC Root 引用链,定位到具体代码并修复。
2. java.lang.OutOfMemoryError: GC overhead limit exceeded
- 根本原因:这是一个预警信号。JVM 检测到 GC 一直在运行(超过了 98% 的时间),但只能回收极少(不到 2%)的堆内存。这意味着应用程序已经在内存崩溃的边缘垂死挣扎。
- 典型场景:通常是
Java heap space问题的前兆或强烈信号,表明存在严重的内存泄漏或堆内存配置严重不足。 - 解决方案:
- 紧急处理:可以临时增大堆内存(
-Xmx),或关闭此检查机制(-XX:-UseGCOverheadLimit),但这只是治标不治本。 - 根本解决:核心方案与
Java heap space相同,即分析堆转储文件,找到并修复根本的内存问题。
- 紧急处理:可以临时增大堆内存(
3. java.lang.OutOfMemoryError: Metaspace (Java 8 及以后)
- 根本原因:元空间(Metaspace)用于存储类的元数据信息,如类名、方法、字段等。当应用加载的类总数超出了元空间容量时,就会抛出此错误。
- 典型场景:
- 动态生成类:大量使用 CGLIB、Javassist 等库创建动态代理或字节码(常见于 Spring AOP、MyBatis 等框架)。
- 类加载器泄漏:在热部署场景(如 OSGi、应用服务器)中,旧的类加载器(ClassLoader)未被回收,导致其加载的类也无法卸载。
- 解决方案:
- 适当增大元空间大小:
-XX:MaxMetaspaceSize=256m。 - 检查是否存在类加载器泄漏或过度使用动态代理的情况。
- 适当增大元空间大小:
4. java.lang.OutOfMemoryError: Direct buffer memory
- 根本原因:直接内存(Direct Memory)位于堆外,用于提高 I/O 操作的性能。通过
ByteBuffer.allocateDirect()分配,其回收不依赖常规 GC,可能导致内存累积。 - 典型场景:大量使用 NIO、Netty 等框架进行网络通信或文件操作时,如果直接缓冲区使用不当或未正确释放,就容易引发此错误。
- 解决方案:
- 增大直接内存上限:
-XX:MaxDirectMemorySize=256m。 - 审查代码,确保直接缓冲区被正确释放,避免频繁创建大型直接缓冲区。
- 增大直接内存上限:
5. java.lang.OutOfMemoryError: Unable to create new native thread
- 根本原因:当 JVM 向操作系统请求创建一个新线程,但操作系统无法满足时抛出。这通常是因为线程总数已达到操作系统或进程的限制。
- 典型场景:
- 线程数爆炸:程序无限制地创建线程(如不恰当使用
new Thread())。 - 堆内存过大:为 JVM 分配的堆内存(
-Xmx)过大,挤压了操作系统留给线程栈的内存空间。
- 线程数爆炸:程序无限制地创建线程(如不恰当使用
- 解决方案:
- 检查并优化线程池配置,限制最大线程数。
- 如果堆内存确实设置过大,可适当降低
-Xmx的值。 - 检查操作系统层面的限制,如 Linux 的
ulimit -u或/etc/security/limits.conf文件。
6. java.lang.StackOverflowError
- 根本原因:线程请求的栈深度超过了 JVM 允许的最大深度。虽然它严格来说是错误(
Error)而非OutOfMemoryError的子类,但常与 OOM 问题一同讨论。 - 典型场景:无限递归(递归调用没有正确终止)是最常见的原因。
- 解决方案:检查并修复递归逻辑,确保有正确的终止条件。也可以适当增大线程栈大小(
-Xss),但这通常不是根本解决办法。
7. java.lang.OutOfMemoryError: PermGen space (Java 7 及以前)
- 根本原因:这是
Metaspace在 Java 8 之前的“前辈”。永久代(PermGen)空间被类定义、字符串常量池等信息占满。 - 解决方案:增大永久代大小:
-XX:MaxPermSize=256m。
八种垃圾收集器
JVM 八大垃圾回收器分项总结
-
Serial(年轻代串行回收器) 定位:最老,单线程,单核 算法:复制算法,全程 STW 缺点:堆越大 STW 停顿越长,多核下单线程效率差 参数:-XX:+UseSerialGC,开启后老年代配套 Serial Old 适用:JDK8 前客户端、物联网单核设备、老旧小型项目
-
Serial Old(老年代串行回收器) 定位:Serial 配套老年代回收器,CMS 失败兜底方案 算法:标记 - 整理,全程 STW 优点:回收后内存连续无碎片,稳定性强 缺点:单线程遍历全堆更新指针,大堆 STW 可达数分钟 参数:启用 SerialGC 自动生效,无需单独配置 适用:桌面小内存程序;CMS 并发失败时降级 Full GC 兜底
-
ParNew(年轻代并行回收器) 定位:Serial 多线程版本,CMS 专属新生代搭档 算法:复制算法,多线程并行 STW 优点:多核下年轻 GC 停顿远短于 Serial,适配 CMS 跨代扫描 缺点:仍存在 STW;单核下多线程切换开销性能不如 Serial 参数:-XX:+UseConcMarkSweepGC自动启用;ParallelGCThreads控制线程数 适用:多核服务端、搭配 CMS 的 Java8 及以前 Web 业务
-
Parallel Scavenge(年轻代吞吐量优先回收器) 定位:并行复制,但核心目标为高吞吐量,和 ParNew 低延迟路线区分 算法:复制算法,支持堆内存自适应调节 特色自适应机制:自动调整新生代大小、Survivor 比例、晋升年龄,无需手动配置 优点:批处理场景整体吞吐量高,自动调参降低运维成本 缺点:停顿时间不可控,限制最大停顿易引发频繁 Full GC 参数:-XX:+UseParallelGC;MaxGCPauseMillis预期停顿;GCTimeRatio控制 GC 时间占比 适用:大数据批处理、科学计算、报表后台等不敏感响应、追求整体速度场景
-
Parallel Old(老年代吞吐量优先回收器) 定位:Parallel Scavenge 配套老年代回收器,解决旧组合老年代回收瓶颈 算法:多线程标记 - 整理,全程 STW 流程:并行标记→并行计算压缩偏移→并行移动对象更新引用 优点:多核加速老年代回收,整理后无内存碎片,全堆吞吐量最优 缺点:仍为 STW,堆越大整理耗时越高 参数:JDK8 开启 UseParallelGC 自动启用 适用:离线计算、高负载批量任务系统
-
CMS(老年代并发低延迟回收器) 定位:主打低停顿,首款并发回收器,JDK9 起废弃 算法:标记 - 清除,产生内存碎片 四大阶段 初始标记(STW,极短):标记 GC Roots 直接对象 并发标记(无 STW):GC 与业务线程同步遍历对象图 重新标记(STW):修复并发阶段新增引用漏标 并发清理(无 STW):释放垃圾内存,产生碎片 核心缺陷 标记清除无压缩,碎片过多分配大对象触发 Full GC 浮动垃圾本次无法回收,堆占用过高触发并发失败降级 Serial Old 并发抢占 CPU,降低整体吞吐量 参数:-XX:+UseConcMarkSweepGC 适用:Java8 及以前 4-8GB 中小堆、延迟敏感 Web 服务,高版本被 G1 替代
-
G1(全堆区域化可预测停顿回收器) 定位:CMS 替代方案,可控 STW 停顿,平衡延迟与吞吐量,JDK9 + 默认 内存模型:堆划分为固定大小 Region,动态充当 Eden/Survivor/Old/Humongous 大对象区 核心组件 RSet:记录跨 Region 引用,无需全堆扫描老年代 SATB 快照标记:解决并发漏标,存在浮动垃圾 GC 流程 Young GC:Eden 满触发,并行复制存活对象 并发标记周期:初始标记→根分区扫描→并发标记→最终标记→筛选可回收 Region Mixed GC:同时回收新生代 + 部分高收益老年代 Region,控制停顿 优点:内存整理无碎片,大堆性能优于 CMS,停顿可自定义 缺点:RSet 占用 10%-20% 堆内存,参数复杂,配置不当易频繁 Full GC 参数:-XX:+UseG1GC、MaxGCPauseMillis设定目标停顿 适用:6GB 以上大堆,需要兼顾延迟和吞吐的复杂线上业务
-
ZGC(全堆近乎零停顿并发回收器) 定位:极致低延迟回收器,停顿稳定 < 10ms,支持 TB 级超大堆,JDK21 新增分代优化 核心技术 染色指针:复用 64 位指针高位存储 GC 状态,无需访问对象头 读屏障 + 指针自愈:访问迁移对象时自动修正引用,分摊 STW 压力 完整流程:初始标记 (微秒 STW)→并发标记→重新标记 (微秒 STW)→并发预备重分配→初始重分配 (微秒 STW)→并发重分配→延迟并发重映射 优点:停顿极低且不随堆增大变长,支持 TB 堆,适配 NUMA 架构 缺点:读屏障增加对象访问开销,吞吐量弱于 G1;JDK21 前无分代,晋升压力大 适用:JDK17 + 几十 GB 至 TB 级超大堆,超低延迟要求系统(量化交易、实时中间件、AI 推理)
常用命令/工具
1、JDK 自带命令行工具
这些工具通常位于 $JAVA_HOME/bin/ 目录下,是线上问题排查的首选。
| 命令 | 主要用途 | 常用示例 | 注意事项 |
|---|---|---|---|
| jps | 列出当前系统所有 Java 进程的 PID 和主类信息 | jps -l 显示完整主类名或 JAR 路径jps -v 显示 JVM 启动参数 | 排查问题的第一步,用于找到目标进程的 PID。 |
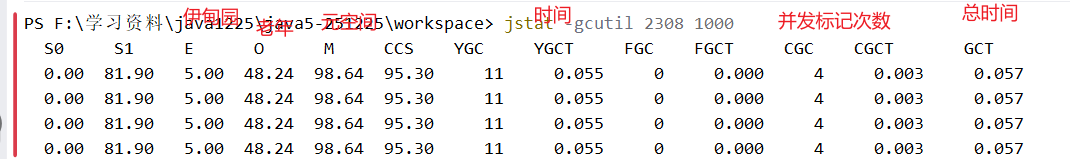
| jstat | 监控 JVM 的类加载、内存、GC、JIT 编译等运行数据 | jstat -gcutil <pid> 1000 每秒输出一次 GC 概况jstat -gc <pid> 2000 5 每 2 秒输出一次 GC 详情,共 5 次 | 线上首选的轻量级监控工具,对性能影响小。 |
| jinfo | 查看或动态修改 JVM 的运行参数 | jinfo -flags <pid> 查看所有 JVM 参数jinfo -flag <name> <pid> 查看指定参数值 | 可用于动态调整部分参数,对线上服务友好。 |
| jmap | 生成堆转储 (Heap Dump) 文件,或查看堆内存详细信息 | jmap -histo:live <pid> Select-Object -First 20 查看存活对象内存直方图 (只要20个) jmap -dump:format=b,file=heap.hprof <pid> 生成堆转储文件 | 生产环境谨慎使用!尤其是 -histo:live 和 -dump 会触发 Full GC,导致 STW。 |
| jstack | 生成 JVM 当前时刻的线程快照 (Thread Dump),用于分析死锁、线程阻塞等 | jstack -l <pid> > thread_dump.txt 打印线程栈并包含锁信息 | 排查线程问题(如死锁、高 CPU 占用)的核心工具。 |
| jcmd | 多功能诊断命令,官方推荐用于替代 jstack、jinfo、jmap 的部分功能 | jcmd <pid> VM.flags 查看 VM 参数jcmd <pid> GC.heap_dump heap.hprof 生成堆转储 | 功能更强大,线上排查建议优先使用。 |
| jhat | 分析堆转储文件,内置 HTTP 服务器,可在浏览器查看 | jhat heap.hprof | JDK 9 起已移除,不推荐使用,建议用 MAT 或 VisualVM 替代。 |
2、图形化监控与诊断工具
图形化工具能提供更直观的实时数据和历史趋势,适合日常监控和深入分析。
| 工具 | 主要用途 | 特点 |
|---|---|---|
| JConsole | 基础的 JVM 实时监控 | JDK 自带,轻量级,适合快速查看内存、线程、类加载等概览信息。 |
| VisualVM | 功能强大的可视化分析工具 | JDK8 自带(JDK9+版本版本需单独安装),功能比 JConsole 更丰富,可分析堆转储、CPU / 内存采样等。 |
| JMC (Java Mission Control) | 企业级的性能剖析和诊断工具 | 需要单独下载,对生产环境性能损耗极小,配合 JFR (Java Flight Recorder) 可收集细粒度运行事件数据。 |
GC算法
四种引用
1.强:只要还用着就不会释放
2.软:内存不足OOM之前 OutOfMemory
3.弱:下一次GC发生,所有的弱引用都会被放着WeakHashMap中, 但是特殊情况:String s= “hello” //hello在常量池
WeakReference
| 引用类型 | 回收时机 | 能否获取对象 | 典型应用 |
|---|---|---|---|
| 强引用 | 永不回收(OOM也不收) | 能 | 普通 new 对象 |
| 软引用 | 内存不足(OOM前) | 能(可能为null) | 本地内存缓存(图片、文件) |
| 弱引用 | 下一次GC发生时 | 能(可能为null) | ThreadLocal、WeakHashMap |
| 虚引用 | 任何时候(GC时入队) | 不能(get为null) | 堆外内存回收、对象回收跟踪 |
类加载器
类加载器,说白了就是负责把.class文件加载进JVM内存的那个东西。
类加载器干三件事 找文件 读字节码 生成Class对象
对象回收算法
Java 堆中待回收对象的两种分类维度
- 语义上的垃圾:从业务逻辑上看,这个对象程序以后绝对不会再用到了。
- 语法上的垃圾:从代码结构上看,这个对象没有任何引用指向它了。 JVM 的判定算法,只能识别“语法垃圾”,无法识别“语义垃圾”。
垃圾判定的核心哲学:宁可放过,绝不杀错
- 把活对象误判为垃圾: 绝对不可以。程序还在用这个对象,但 JVM 把它的内存回收并分配给了别人,程序会立刻发生不可预知的崩溃或数据损坏。
- 把垃圾误判为活对象: 可以接受(为了降低算法复杂度和系统停顿,现代 GC 经常在这一点上做妥协)。产生所谓的“浮动垃圾”,暂时的内存浪费,大不了留到下一次 GC 再回收。
分类
1.启动类加载器(Bootstrap ClassLoader):用C++写的,不继承ClassLoader类,负责加载JDK核心库如java.lang包,存储在/jre/lib目录下 。
2.扩展类加载器(Extension ClassLoader):用Java实现,加载jre/lib/ext目录或java.ext.dirs指定路径的扩展库, JDK9后改名为平台类加载器(Platform ClassLoader),加载一些平台的一些相关类。
3.应用程序类加载器(Application ClassLoader):也叫系统类加载器,加载用户类路径ClassPath上的类,包括你写的代码和第三方JAR包,可通过ClassLoader.getSystemClassLoader()获取 。
4.自定义类加载器:继承ClassLoader类并重写findClass方法实现,用于热部署、类隔离、从网络或数据库加载类等特殊场景 。
引用计数法
引用计数法是最简单、最直观的垃圾判定算法。其核心思想是:为每个对象维护一个整型计数器,记录当前有多少个引用指向它。当计数器归零时,对象即为垃圾。
基本思路:
给对象中添加一个引用计数器,每当有一个地方引用它时,计数器值就加1;当引用失效时,计数器值就减1;任何时刻计数器为0的对象就是不可能再被使用的。 优点:
| 优点 | 详细说明 |
|---|---|
| 实时性高 | 计数器归零的瞬间即可回收,无需等待 GC 线程,内存释放及时 |
| 实现简单 | 逻辑直观,不需要复杂的图遍历算法 |
| 暂停时间短 | 回收操作分散在每次引用变更中,不需要”Stop The World”式的全局暂停 |
| 局部性好 | 回收操作在引用变更的局部发生,对缓存友好 |
缺点:
| 缺点 | 详细说明 |
|---|---|
| 循环引用无法解决 | 两个或多个对象互相引用形成环,即使外部已无引用,计数器也不归零 |
| 空间开销 | 每个对象都需要额外的字段存储计数器(通常 4 或 8 字节) |
| 时间开销 | 每次引用赋值都需要更新计数器,频繁的增减操作消耗 CPU |
| 原子性问题 | 多线程环境下,计数器的增减需要原子操作或加锁,影响并发性能 |
| 级联回收问题 | 一个对象被回收时,它持有的所有引用都需要减计数,可能引发级联的大量回收操作 |
因此目前主流的Java虚拟机都摒弃掉了这种算法。
可达性分析算法
实现简单,执行高效,解决引用计数算法中循环引用的问题,是Java和C#选择的算法。
基本思路: 可达性分析将对象分为两类:垃圾回收的根对象(GC Root)和普通对象,对象与对象之间存在引用关系。将一系列GC Root的集合作为起始点,按照从上至下的方式搜索所有能够被该合集引用到的对象(是否可达),并将其加入到该和集中,这个过程称之为标记(mark),被标记的对象是存活对象。 最终,未被探索到的对象便是死亡的,是可以回收的,标记为垃圾对象。
在Java语言中,可以作为GC Root的对象包括下面几种:
- 静态变量(Static Variables):静态变量属于类,而不是实例对象。它们在整个程序执行期间都存在,并且被认为是 GC Root 对象。
- 活动线程(Active Threads):正在运行的线程也被视为 GC Root 对象。因为线程是程序执行的控制流,如果一个线程还在运行,那么它引用的对象也应该被保留。
- 栈帧(Stack Frames)中的局部变量和输入参数:栈帧中的局部变量和输入参数也是 GC Root 对象。它们在方法调用期间创建,并且随着方法的结束而销毁。
- JNI 引用(JNI References):通过 Java Native Interface (JNI) 在 Java 代码和本地代码之间传递的对象也被视为 GC Root 对象。这些对象的生命周期由本地代码管理。
发展历程 : 远古时代(Serial / Parallel GC): 做法:纯粹的STW。让所有业务线程停下,GC 慢慢顺着 GC Roots 遍历。 缺点:堆内存越大,卡顿越久。 近代(CMS / G1 收集器): 做法:引入三色标记法和写屏障。实现了并发标记,GC 线程和业务线程一起跑。 进化:大大缩短了停顿时间。 现代(ZGC / Shenandoah 收集器): 做法:不仅并发标记,还实现了并发搬运(Concurrent Relocation)。引入了染色指针(Colored Pointers)和读屏障(Read Barrier)。 进化级别:即使服务器有 上百 TB 的内存,ZGC 顺着 GC Roots 找完并清理完毕,全过程的停顿时间也能控制在 1 毫秒以内(亚毫秒级)
标记清除
2个阶段
- **标记:**使用
可达性分析算法,标记出可达对象。 - **清除:**对堆内存从头到尾进行线性便遍历,如果发现某个对象没有被标记为可达对象,则将其回收。
缺点:
-
效率问题(两次遍历)
-
空间问题(标记清除后会产生大量不连续的碎片。JVM就不得不维持一个
内存的空闲列表,这又是一种开销。而且在分配数组对象的时候,寻找连续的内存空间会不太好找。)
复制算法
核心思想: 将内存平均分成两部分,然后每次只使用其中的一部分,当这部分内存满的时候,将内存中所有存活的对象复制到另一个内存中,然后将之前的内存清空,只使用这部分内存,循环下去。
优点:
- 实现简单
- 不产生内存碎片
缺点:
-
将内存缩小为原来的一半,浪费了一半的内存空间,代价太高;如果不想浪费一半的空间,就需要有额外的空间进行分配担保,以应对被使用的内存中所有对象都100%存活的极端情况,所以在老年代一般不能直接选用这种算法。
-
如果对象的存活率很高,我们可以极端一点,假设是100%存活,那么我们需要将所有对象都复制一遍,并将所有引用地址重置一遍。复制这一工作所花费的时间,在对象存活率达到一定程度时,将会变的不可忽视。 所以从以上描述不难看出,复制算法要想使用,最起码对象的存活率要非常低才行,而且最重要的是,我们必须要克服50%内存的浪费。
标记压缩
也叫标记整理算法。
标记整理算法是标记-清除法的一个改进版。同样,在标记阶段,该算法也将所有对象标记为存活和死亡两种状态;不同的是,在第二个阶段,该算法并没有直接对死亡的对象进行清理,而是通过所有存活对像都向一端移动,然后直接清除边界以外的内存。
优点: 标记整理算法不仅可以弥补标记清除算法中,内存区域分散的缺点,也消除了复制算法当中,内存减半的高额代价。
缺点: 如果存活的对象过多,整理阶段将会执行较多复制操作,导致算法效率降低。
加载流程
加载流程: 1.加载:将类的字节码数据加载到 JVM 内存.并创建一个 Class 对象 2.链接: 1)验证 :文件格式,元数据,字节码,符号引用 2)准备:分配静态变量内存,并赋默认值 3)解析:类和接口,字段,方法,方法类型和方法句柄 3.初始化:执行静态代码赋值 4.使用 5.卸载
一、第一阶段:加载(Loading)—— “找到字节码,读入内存”
加载是类加载的第一步,由 ClassLoader 直接负责,核心是将类的字节码数据加载到 JVM 内存,==并创建一个 java.lang.Class 对象。
核心操作:
- 定位字节码来源:
- 读取字节码并验证格式:
- 创建 Class 元数据对象(类的配方):
关键特点:
- 加载阶段仅负责 “读入数据、创建 Class 对象”,不执行任何字节码指令,也不初始化类的静态变量。
- 同一个类只会被加载一次
二、第二阶段:链接(Linking)—— “处理字节码,准备运行”
链接是加载后的中间阶段,核心是对加载到内存的类元数据进行处理,确保其能正确运行,分为三个子步骤:验证(Verification)、准备(Preparation)、解析(Resolution),按顺序执行。
1. 子步骤 1:验证(Verification)—— “确保字节码合法安全”
这是 JVM 安全的核心环节,目的是校验类的字节码是否符合 JVM 规范,避免恶意或非法字节码导致 JVM 崩溃。若验证失败,抛出 VerifyError 及其子类异常。
核心验证内容:
- 文件格式
- 元数据
- 字节码
- 符号引用
2. 子步骤 2:准备(Preparation)—— “分配静态变量内存,设置默认值”
核心是为类的静态变量(static 修饰)分配内存,并设置默认初始值(而非代码中定义的初始值),内存分配在方法区。
关键细节:;
-
仅处理 “静态变量”
-
默认值规则:按变量类型分配默认值
-
特殊情况:
static final常量(编译期常量):若常量值是编译期可确定的(如static final int MAX = 100),准备阶段会直接将常量值写入常量池,无需设置默认值;若为运行期确定的值(如static final String UUID = UUID.randomUUID().toString()),仍会设置默认值null,最终值在初始化阶段赋值。
3. 子步骤 3:解析(Resolution)—— “将符号引用转为直接引用”
==核心是将类元数据中的 “符号引用”(如类名、字段名、方法名的字符串标识)替换为 “直接引用”(如内存地址、偏移量),让 JVM 能直接定位到目标资源。
符号引用 和 直接引用:
- 符号引用:字节码中用字符串表示的 “间接引用”,与 JVM 内存布局无关。
- 直接引用:指向内存中实际对象的 “直接指针”,依赖 JVM 内存布局。
核心解析内容:
- 类 / 接口解析
- 字段解析
- 方法解析
- 方法类型 / 方法句柄解析
关键特点:
- 解析阶段可 “延迟执行”:JVM 规范允许解析在 “初始化阶段之前” 或 “首次使用该引用时” 执行(如懒加载),目的是优化性能(避免提前解析未使用的引用)。
- 解析失败会抛出
NoSuchFieldError、NoSuchMethodError、ClassNotFoundException等异常。
三、第三阶段:初始化(Initialization)—— “执行静态代码,赋初始值”
初始化是类加载的最后一步,核心是执行类的静态初始化代码(静态代码块、静态变量赋值语句)==,为静态变量赋予开发者定义的初始值,而非准备阶段的默认值。
核心操作:
-
执行静态初始化逻辑:
-
按代码编写顺序执行静态变量赋值语句(如
static int num = 10;)。 -
执行静态代码块中的代码
-
-
递归初始化父类:
- 初始化当前类之前,必须先初始化其父类(父类的初始化同样遵循 “静态变量 + 静态代码块” 的执行顺序),直到
java.lang.Object(Object 是所有类的父类,其初始化由 JVM 完成)。 - 注意:接口不需要初始化父接口
- 初始化当前类之前,必须先初始化其父类(父类的初始化同样遵循 “静态变量 + 静态代码块” 的执行顺序),直到
初始化的触发条件(主动使用场景):
JVM 规范规定,只有 “主动使用” 类时才会触发初始化(被动使用不会),主动使用场景包括:
- 创建类的实例(
new Test())。 - 调用类的静态方法(
Test.method())。 - 访问类的静态变量(
Test.num,不包括static final编译期常量)。 - 反射调用类(
Class.forName("com.example.Test"))。 - 初始化子类时(子类初始化前必须先初始化父类)。
- 启动类(
main方法所在的类)。
关键特点:
- 初始化阶段是 “按需执行”:仅当满足主动使用条件时才执行,且同一个类只会初始化一次
- 初始化失败会抛出
ExceptionInInitializerError(如静态代码块中抛出未捕获的异常)
分代处理
核心逻辑: 基于“绝大多数对象在创建后很快就会消亡”这一经验规律(分代假说)
分代回收算法实际上是复制算法和标记整理法、标记清除的结合,并不是真正一个新的算法
一般分为老年代(Old Generation)和年轻代(Young Generation)老年代就是很少垃圾需要进行回收的,年轻代就是有很多的内存空间需要回收,所以不同代就采用不同的回收算法,以此来达到高效的回收算法。
年轻代(Young Gen)
年轻代特点是区域相对老年代较小,对像存活率低。
这种情况复制算法的回收整理,速度是最快的。复制算法的效率只和当前存活对像大小有关,因而很适用于年轻代的回收。而复制算法内存利用率不高的问题,通过hotspot中的两个survivor的设计得到缓解。
老年代(Tenure Gen)
老年代的特点是区域较大,对像存活率高。
这种情况,存在大量存活率高的对像,复制算法明显变得不合适。一般是由标记清除或者是标记清除与标记整理的混合实现。
JVM调优参数
一、参数分类
| 分类 | 核心参数(含义) |
|---|---|
| 堆内存 | -Xms(初始堆大小), -Xmx(最大堆大小), -Xss(线程栈大小), -XX:MaxMetaspaceSize(元空间上限) |
| 垃圾回收器 | -XX:+UseG1GC(启用G1), -XX:+UseParallelGC(启用Parallel), -XX:+UseZGC(启用ZGC) |
| GC 调优 | -XX:MaxGCPauseMillis(暂停目标), -XX:ParallelGCThreads(并行线程数) |
| OOM 排查 | -XX:+HeapDumpOnOutOfMemoryError(自动Dump), -XX:HeapDumpPath(Dump路径), -Xlog:gc*(GC日志) |
| 容器适配 | -XX:MaxRAMPercentage(堆内存百分比), -XX:+UseContainerSupport(容器感知) |
| 防坑 | -XX:+DisableExplicitGC(禁用System.gc), -XX:+UseStringDeduplication(字符串去重) |
二、面试场景模拟话术
面试官问:“你们线上 JVM 怎么配置的?”
回答结构:
- 定内存:“首先固定堆大小,
-Xms和-Xmx设为相同(如 4G),防止动态扩缩容;-Xss设为 256k~512k,节省线程内存。”- 选 GC:“我们用的是 G1(
-XX:+UseG1GC),因为对 RT 敏感。设置-XX:MaxGCPauseMillis=200作为目标。”- 保命:“最关键的是开启
-XX:+HeapDumpOnOutOfMemoryError并指定路径,方便出问题后复盘。”- 容器适配:“由于我们是 K8s 部署,用
-XX:MaxRAMPercentage=75.0替代固定 Xmx,避免容器 OOM。serverless服务,根据访问量”- 防坑:“加一个
-XX:+DisableExplicitGC,防止框架误触 Full GC”
三、科普介绍
1.堆内存基石
| 参数 | 解释 | 示例 | 面试核心考点 |
|---|---|---|---|
-Xms | 设置 JVM 堆内存的初始大小。 | -Xms2g | 生产环境必须与 -Xmx 相等。为什么? 防止 JVM 在运行时频繁向操作系统申请/归还内存,这会触发 OS 内核态切换,造成系统抖动和额外停顿。 |
-Xmx | 设置 JVM 堆内存的最大值。 | -Xmx2g | 同上,两者建议设为相同值。 |
-Xss | 设置 每个线程的栈大小,影响方法调用的深度和线程数量。 | -Xss256k | 陷阱题:线程数过多导致栈溢出(StackOverflowError)时调大;如果创建大量线程(如 10 万并发),反而要调小,否则会 OOM(每个线程占用独立内存)。 |
-XX:MaxMetaspaceSize | 设置 元空间(Metaspace)的最大值,元空间用于存储类元数据。 | -XX:MaxMetaspaceSize=512m | 必须设置上限!Spring Boot + CGLIB 动态代理会不断生成类,不设上限容易导致 java.lang.OutOfMemoryError: Metaspace。 |
2.垃圾回收器选择
| 参数 | 解释 | 示例 | 面试核心考点 |
|---|---|---|---|
-XX:+UseG1GC | 启用 G1 垃圾回收器,将堆划分为多个 Region,可预测停顿。 | -XX:+UseG1GC | JDK 9+ 默认。适合堆内存 > 4GB 且对响应时间(RT)敏感的 Web 服务。加分回答:G1 将堆分成 Region,可预测停顿,不用再设置新生代/老年代大小(-Xmn 失效)。 |
-XX:+UseParallelGC | 启用 Parallel 垃圾回收器(又称吞吐量优先回收器),使用多线程并行回收。 | -XX:+UseParallelGC | JDK 8 默认。适合后台批处理、对吞吐量要求极高、能接受几秒 STW(Stop The World)的场景(如数据报表、离线计算)。 |
-XX:+UseZGC | 启用 ZGC 垃圾回收器,一款可扩展的低延迟回收器。 | -XX:+UseZGC | 低延迟王者(停顿 < 1ms)。JDK 11+ 支持,适合**内存极大(上百 GB)**且要求极快响应的场景(如金融风控、实时推荐)。 |
3.GC 核心调优
| 参数 | 解释 | 示例 | 面试核心考点 |
|---|---|---|---|
-XX:MaxGCPauseMillis | 设置 期望的最大 GC 暂停时间目标(毫秒),JVM 会尽量达成。 | -XX:MaxGCPauseMillis=200 | 注意陷阱:这是个软目标(Hint),不是硬性保证。设得太小(如 10ms)会导致 JVM 频繁调整堆大小,反而增加 GC 总次数,降低吞吐量。 |
-XX:ParallelGCThreads | 设置 并行 GC 的线程数,用于控制垃圾回收并行阶段的并发度。 | -XX:ParallelGCThreads=4 | 经验公式:1.CPU < 8 核,设为 CPU 数;2. CPU > 8 核,设为 5/8 * CPU 数,防止 GC 线程抢占业务线程 CPU。 |
4.OOM 故障排查
| 参数 | 解释 | 示例 | 面试核心考点 |
|---|---|---|---|
-XX:+HeapDumpOnOutOfMemoryError | 启用 OOM 时自动导出堆转储快照(Heap Dump),用于事后分析。 | 直接使用 -XX:+HeapDumpOnOutOfMemoryError | 导出后用 MAT(Memory Analyzer)或 JProfiler 分析,直接看大对象(Leak Suspects)定位内存泄漏代码行。 |
-XX:HeapDumpPath | 指定 Heap Dump 文件的存储路径,可自定义目录。 | -XX:HeapDumpPath=/data/dump/ | 指定 Dump 文件存放路径,防止因磁盘空间不足导致 Dump 失败。 |
-XX:+PrintGCDetails(旧) | |||
-Xlog:gc*(新) | 输出 详细的 GC 日志信息,包括各区域回收前后数据。JDK 9+ 改用统一日志选项。 | -Xlog:gc*:file=/path/gc.log | 记住升级点:JDK 9+ 废弃了 PrintGCDetails,统一改用 -Xlog:gc*:file=/path/gc.log。面试时提一句,瞬间拉高好感度。 |
5.容器/云原生
| 参数 | 解释 | 示例 | 面试核心考点 |
|---|---|---|---|
-XX:MaxRAMPercentage | 设置 堆内存占容器总内存的最大百分比,用于容器环境自适应。 | -XX:MaxRAMPercentage=75.0 | 痛点:以前用 -Xmx 固定值,容器内存缩容后 JVM 不知道,导致被 K8s OOMKilled。高情商回答:设置堆内存占容器总内存的 70%~80%,留 20%~30% 给元空间、堆外内存和操作系统,既利用弹性资源,又防止超限被杀。 |
-XX:+UseContainerSupport | 让 JVM 正确识别容器(如 Docker)的 CPU 和内存限制,而不是读取宿主机资源。 | 默认开启(JDK 10+) | 让 JVM 正确识别 CGroup 限制(CPU 核数和内存),而不是读取宿主机的物理资源。 |
6.踩坑避雷
| 参数 | 解释 | 示例 | 面试核心考点 |
|---|---|---|---|
-XX:+DisableExplicitGC | 禁止代码中显式调用 System.gc(),避免人工触发 Full GC。 | -XX:+DisableExplicitGC | 为什么? 很多框架(如 RMI、NIO)会主动调用,这会触发 Full GC(尤其是 CMS 时),极易造成应用卡顿。加上这个参数,让 GC 完全由 JVM 自身策略控制。 |
-XX:+UseStringDeduplication | 自动去重堆中内容相同的字符串对象,节省内存(仅对 G1 回收器有效)。 | -XX:+UseStringDeduplication | 自动去重堆中 内容相同的字符串。高并发 Web 应用下,能节省 10%~30% 的内存,面试时提到是亮点。 |
三色标记
是“标记-清除”算法的一种改进,旨在解决停顿时间过长的问题
三种颜色区别
-
白色: 初始状态: 所有对象刚开始都是白色的。 终局状态: 如果一次标记结束仍为白色,说明该对象不可达,可以被回收。
-
灰色: 中间状态: 对象已被扫描(标记为灰色),但该对象引用的其他对象尚未被扫描过。 意义: 灰色对象作为“波阵面”,代表了标记工作正在向其下游扩展
-
黑色: 完成状态: 该对象已被扫描,且其引用的所有其他对象也已被扫描(即已标记完毕)。 特性: 黑色对象不能直接指向白色对象(如果在标记过程中发生了指向,则需要处理)。
执行流程:
- 初始化: 所有对象设为白色。
- 根搜索: 将所有“根对象”(GC Roots,如线程栈中的局部变量等)标记为灰色,放入待处理队列。
- 扫描: 循环取出灰色对象,将其转为黑色,并将其直接引用的所有白色对象转为灰色。
- 终止: 当没有灰色对象剩余时,标记结束。所有剩余的白色对象即为垃圾,执行清理。
为确保标记的正确性,三色标记法必须维护以下不变式:
| 不变式 | 内容 | 强弱 |
|---|---|---|
| 强三色不变式 | 黑色对象绝对不能直接引用白色对象 | 强 |
| 弱三色不变式 | 黑色对象可以引用白色对象,但必须存在一条从灰色对象到该白色对象的引用路径 | 弱 |
在并发标记阶段(GC 线程和用户程序同时运行),会出现两个严重的一致性问题,导致错误的回收:
- 漏标: 一个黑色对象指向了一个本来应该是存活的白色对象,但由于黑色对象不再扫描,导致该白色对象被错误回收。
- 错漏: 标记过程被破坏,导致本该回收的对象未被识别。
解决方案
- 增量更新:当一个黑色对象插入一个指向白色对象的引用时,将该黑色对象变回灰色。这意味着重新扫描该对象,确保其引用的白色对象能被“捞回来”。(典型代表:CMS 垃圾收集器)。
- 原始快照:当灰色对象删除指向白色对象的引用时,将这个白色对象记录下来。在标记结束时,即便该对象引用丢失,依然将其视为存活。(典型代表:G1 垃圾收集器)。
方法区GC
方法区中能回收的内容主要就是不再使用的类。判定一个类可以被回收。需要同时满足下面三个条件:
- 1、此类所有实例对象没有在任何地方被引用,在堆中不存在任何该类的实例对象以及子类对象。
- 2、该类对应的 .Class 对象没有在任何地方被引用。
- 3、加载该类的类加载器没有在任何地方被引用。
废弃的常量的回收:
- 只要当前系统里没有任何地方引用这个常量,它就是废弃常量,就可以被回收
方法区的回收通常情况下很少发生,但是如果通过自定义类加载器加载特定的少数的类,那么可以在程序中释放自定义类加载器的引用,卸载当前类,当前对象置空,垃圾回收会对这部分内容进行回收
GC分类
前置知识:分代收集理论
Minor GC(又称 Young GC / YGC)
- 清理范围:仅针对年轻代(Eden 区 + Survivor 区)。
- 执行特点: 极其频繁:因为绝大多数对象很快就不用了,Eden 区很快就会满。 速度极快:年轻代主要采用“复制算法”。因为 90% 以上的对象都是垃圾,JVM 只需要把少量存活的对象复制到 Survivor 区,然后直接清空 Eden 区即可,效率极高。 有停顿(STW):会发生 Stop-The-World(暂停所有业务线程),但因为存活对象少、复制快,这个停顿时间通常在几毫秒到几十毫秒级别,用户根本感知不到。
- 结果:活着的对象年龄 +1,熬过一定次数(默认 15 次)的对象会被晋升(Promote)到老年代。
Major GC(又称 Old GC / OGC)
- 清理范围:仅针对老年代
- 触发条件:老年代空间不足时触发
- 执行特点:速度较慢:老年代对象存活率高,不能用复制算法,通常采用标记-清除或标记-整理算法。其速度通常比 Minor GC 慢 10 倍以上。
Full GC(FGC)
- 清理范围:整个 Java 堆(年轻代 + 老年代) + 元空间(Metaspace / 方法区)。
- 触发条件:
| 类别 | 具体触发条件 | 机制说明 |
|---|---|---|
| 老年代空间不足 | 老年代连续空间用完 | 最常见原因 |
| 元空间不足 | Metaspace 使用达到 MaxMetaspaceSize | 会触发 Full GC 卸载类 |
| 空间分配担保失败 | 老年代剩余空间 < 新生代存活对象大小 | Minor GC 前检查失败 |
| System.gc() 显式调用 | 代码调用 System.gc() 或 Runtime.getRuntime().gc() | 建议 JVM 执行 Full GC(可通过 -XX:+DisableExplicitGC 禁用) |
| CMS 收集器失败 | Concurrent Mode Failure / Promotion Failed | CMS 并发阶段出错时回退到 Full GC |
| 大对象分配失败 | 巨型对象在老年代直接分配失败 | |
| MinGC 后 Survivor 放不下 | 晋升对象过多,老年代也放不下 | |
| 历次晋升平均大小判断 | Minor GC 前判断:老年代剩余空间 < 历次晋升老年代对象的平均大小 | 由分配担保策略触发 |
- 执行特点: 极度昂贵:因为要扫描整个堆和元空间,涉及海量对象。 致命的停顿(Long STW):Full GC 发生时,所有的业务线程都必须暂停。根据堆的大小,停顿时间可能从几百毫秒到几秒,甚至几十秒。 业务影响:如果 Full GC 频繁发生(比如一分钟一次),你的接口就会经常超时,用户体验极度卡顿,这在生产环境中被称为GC 抖动或系统假死。
Mixed GC (G1 收集器特有)
执行过程:
- 触发全局并发标记:当整个堆的内存占用率达到一个阈值时(默认是 45%),G1 会启动一个“全局并发标记”过程。把所有老年代 Region 里的存活对象找出来
- 计算价值:Region 的价值 ≈ 可以回收的垃圾空间大小 / 预估的回收耗时
- 执行 Mixed GC:它会把 所有的年轻代 Region和排名最靠前、收益最高的几个老年代 Region放在一起作为一个回收集合(Collection Set, CSet)。 使用 标记-复制算法,把这些 Region 里的活对象复制到空闲的 Region 中,然后把原来的 Region 全部清空。
- 分批回收(控制停顿时间):如果老年代垃圾太多,一次 Mixed GC 搬运不完(因为要保证 STW 不超过设定的 200 毫秒),G1 会把老年代的回收分摊到接下来的连续几次 Minor GC 中(默认最多分 8 次)
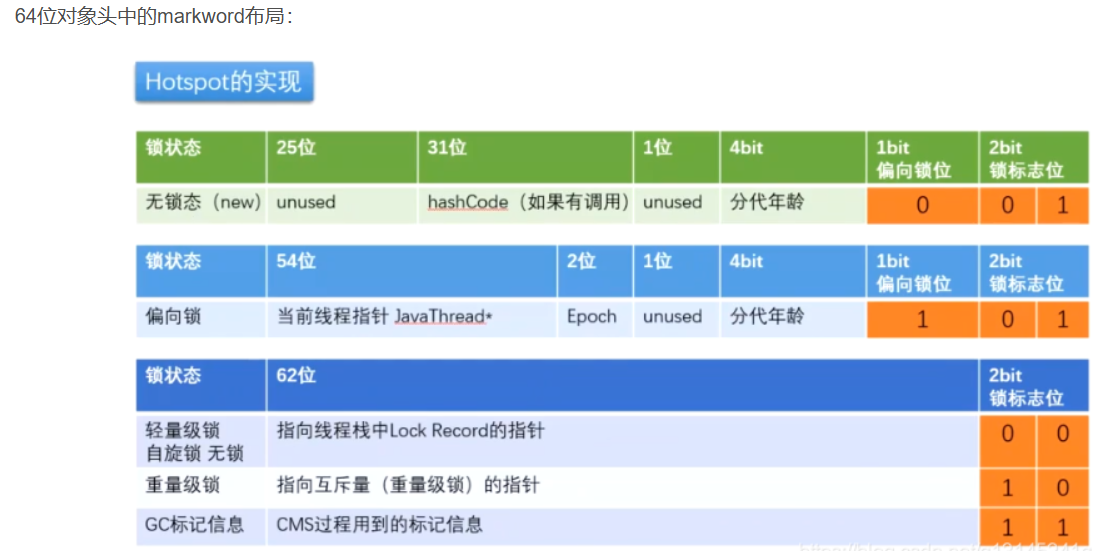
64位对象头
常量池
JDK 6 及之前 字符串常量池:存放在 永久代(PermGen) 里,属于方法区的一部分。 运行时常量池:同样在永久代。 缺点:永久代大小固定,大量使用 String.intern()很容易导致OOM且永久代的 GC 不高效。 String.intern() 是一个本地方法,作用:从字符串常量池中拿回一个“保证内容唯一”的字符串引用。
JDK 7 字符串常量池:被移到了 Java 堆中。 运行时常量池:仍然在永久代。 字符串常量池会参与正常的堆 GC,不再受限于永久代大小,OOM 风险降低。 大量 intern() 现在可能导致OOM
JDK 8 及之后 永久代被彻底移除,方法区改用元空间(Metaspace),位于本地内存。 运行时常量池:移到了元空间中。 字符串常量池:依然在Java堆。
jstat参考图
对象头
一、对象头的组成
1. Mark Word(标记字)
- 存储对象自身的运行时数据
- 64位JVM占64位(8字节)**
2. Klass Pointer(类型指针)
- 指向方法区中该对象所属类的元数据
- 32位JVM占4字节;64位JVM默认占8字节,开启指针压缩后占4字节
3. 数组长度(仅数组对象)
- 如果是数组对象,额外占用4字节存储数组长度
- 普通对象没有此字段
二、 Mark Word 详解
1. 64位JVM下Mark Word的位布局
Mark Word会根据对象状态动态复用存储空间:
| 锁状态 | 25 bit | 31 bit | 1 bit | 4 bit | 1 bit | 2 bit |
|---|---|---|---|---|---|---|
| 无锁 | unused | hashCode | unused | 分代年龄 | 0 | 01 |
| 偏向锁 | 线程ID(54 bit) | epoch(2 bit) | 分代年龄 | 1 | 01 | |
| 轻量级锁 | 指向栈中锁记录的指针(62 bit) | 00 | ||||
| 重量级锁 | 指向互斥量(Monitor)的指针(62 bit) | 10 | ||||
| GC标记 | 空 | 11 |
- 分代年龄最大为15,取值范围0-15,0时直接进入老年区,通过-XX:MaxTenuringThreshold=15进行初始化设置
2. 各字段含义
- lock(锁标志位):2位,与biased_lock共同表示锁状态
| biased_lock | lock | 锁状态 |
|---|---|---|
| 0 | 01 | 无锁 |
| 1 | 01 | 偏向锁 |
| - | 00 | 轻量级锁 |
| - | 10 | 重量级锁 |
| - | 11 | GC标记 |
- biased_lock(是否偏向):1位,1表示启用偏向锁
- age(分代年龄):4位,对象在Survivor区每熬过一次GC就+1
→ 最大值15,这就是-XX:MaxTenuringThreshold最大为15的原因
面试陷阱:为什么年龄阈值最大是15?因为age只有4位! - hashCode:31位,延迟加载,调用
System.identityHashCode()后才写入 - thread:54位,持有偏向锁的线程ID
- ptr_to_lock_record:轻量级锁时,指向栈中锁记录的指针
- ptr_to_heavyweight_monitor:重量级锁时,指向Monitor的指针
3. 锁状态变化时Mark Word的变化
synchronized锁升级过程中对象头怎么变? 无锁(01) → 偏向锁(01) → 轻量级锁(00) → 重量级锁(10)
| 阶段 | Mark Word中存储的内容 |
|---|---|
| 无锁 | hashCode + 分代年龄 |
| 偏向锁 | 偏向线程ID + epoch + 分代年龄 |
| 轻量级锁 | 指向栈中Lock Record的指针 |
| 重量级锁 | 指向Monitor的指针 |
关键点:
- 锁只能升级,不能降级
- 当对象加锁后,Mark Word没有足够空间保存hashCode,hashCode会移动到线程的Monitor中
四、Klass Pointer(类型指针)
4.1 作用
指向方法区中的类元数据(Klass),JVM通过它确定对象是哪个类的实例
4.2 大小
| 场景 | 大小 |
|---|---|
| 32位JVM | 4字节 |
| 64位JVM(默认开启指针压缩) | 4字节 |
| 64位JVM(关闭指针压缩) | 8字节 |
4.3 指针压缩(Compressed OOPs)
- 默认开启:
-XX:+UseCompressedOops - 关闭:
-XX:-UseCompressedOops - 从Java 8开始,Klass Pointer指向Metaspace(元空间),之前指向Permanent Generation
五、数组对象的对象头
数组对象在对象头中额外包含4字节的数组长度: +---------------------+ | Mark Word (8B) | +---------------------+ | Klass Pointer (4B) | +---------------------+ | Array Length (4B) | ← 数组特有 +---------------------+ | Element[0] | | Element[1] | | … | +---------------------+
- 长度字段固定4字节 → 数组最大长度受限于
Integer.MAX_VALUE(2³¹-1) - 普通对象:对象头 = 8 + 4 = 12字节(64位开启压缩)
- 数组对象:对象头 = 8 + 4 + 4 = 16字节
六、对象头大小速查表
| 场景 | Mark Word | Klass Pointer | 数组长度 | 对象头总大小 |
|---|---|---|---|---|
| 32位JVM | 4B | 4B | 4B(数组) | 8B / 12B |
| 64位JVM(开启压缩) | 8B | 4B | 4B(数组) | 12B / 16B |
| 64位JVM(关闭压缩) | 8B | 8B | 4B(数组) | 16B / 20B |
面试常见计算:
new Object()在64位开启压缩下占多少内存?
对象头12B + 实例数据0B + 对齐填充4B = 16字节(对齐到8的倍数)
七、面试常见追问
Q1:为什么对象头要设计成动态变化?
为了节省内存。同一个64位空间,在不同状态下存储不同信息,不需要为每个对象额外分配锁相关字段的内存。
Q2:hashCode和锁信息怎么共存?
- 无锁时存hashCode
- 加锁后hashCode被移动到Monitor中
- 解锁后hashCode不会恢复到Mark Word
mysql
增删改查语句
一、查(SELECT)—— 最常用
-
基础查询 SELECT * FROM 表名; — 查询所有列 SELECT 列1, 列2 FROM 表名; — 查询指定列
-
条件过滤 SELECT * FROM 表名 WHERE 条件; — 示例:年龄大于18且名字叫”张三” SELECT * FROM users WHERE age > 18 AND name = ‘张三’;
-
模糊查询(LIKE:% 任意多个字符,_ 单个字符) SELECT * FROM users WHERE name LIKE ‘张%’; — 张开头
-
排序(ORDER BY,默认 ASC 升序,DESC 降序) SELECT * FROM products ORDER BY price DESC;
-
分页查询(LIMIT 偏移量, 数量) SELECT * FROM users LIMIT 0, 10; — 第1页(跳过0条,取10条) SELECT * FROM users LIMIT 10, 10; — 第2页(跳过10条,取10条)
-
聚合统计(COUNT / SUM / AVG / MAX / MIN) SELECT COUNT(*) AS 总数 FROM users; SELECT AVG(score) FROM scores WHERE subject = ‘数学’;
-
分组查询(GROUP BY + HAVING) SELECT sex, COUNT() FROM users GROUP BY sex; SELECT sex, COUNT() FROM users GROUP BY sex HAVING COUNT(*) > 5;
二、增(INSERT)—— 插入数据
-
插入完整一行(列顺序与表结构一致) INSERT INTO 表名 VALUES (值1, 值2, 值3);
-
插入指定列(推荐写法,更安全) INSERT INTO 表名 (列1, 列2) VALUES (值1, 值2);
-
批量插入多条(性能极高) INSERT INTO users (name, age) VALUES (‘王五’, 25), (‘赵六’, 30), (‘孙七’, 22);
-
插入查询结果(复制数据到另一张表) INSERT INTO 备份表 (name, age) SELECT name, age FROM users WHERE age < 18;
三、改(UPDATE)—— 更新数据
-
基础更新(务必加 WHERE,否则全表更新!) UPDATE 表名 SET 列1 = 新值1, 列2 = 新值2 WHERE 条件;
-
示例:将 id=5 的用户年龄改为 20 UPDATE users SET age = 20 WHERE id = 5;
-
在原值上修改(如工资涨 10%) UPDATE employees SET salary = salary * 1.1 WHERE department = ‘技术部’;
-
多表联合更新(关联其他表) UPDATE users u JOIN orders o ON u.id = o.user_id SET u.level = ‘VIP’ WHERE o.total_amount > 10000;
四、删(DELETE)—— 删除数据
-
基础删除(务必加 WHERE,否则全表清空!) DELETE FROM 表名 WHERE 条件;
-
示例:删除 id=10 的用户 DELETE FROM users WHERE id = 10;
-
删除年龄小于 18 岁的所有用户 DELETE FROM users WHERE age < 18;
-
清空整张表(保留结构)—— 推荐 TRUNCATE,比 DELETE 快得多 TRUNCATE TABLE 表名; — 重置自增ID,无法恢复(慎用) — 等价于(但不重置自增ID,且可加 WHERE) DELETE FROM 表名;
-
多表删除(同时删除两张表的数据) DELETE u, o FROM users u INNER JOIN orders o ON u.id = o.user_id WHERE u.id = 1;
五、注意事项
【UPDATE / DELETE 的致命陷阱】 陷阱:忘记写 WHERE,整张表的数据全部丢失! 解决方案: ① 执行前先用 SELECT * 查看将要影响的数据; ② 生产环境强烈建议开启 sql_safe_updates 模式 (强制要求 WHERE 条件带索引)。
【INSERT 中文乱码】 陷阱:插入中文显示为乱码。 解决方案: ① 建表时设置 CHARSET=utf8mb4; ② 连接 URL 添加参数: ?useUnicode=true&characterEncoding=utf-8。
【性能问题:循环单条插入】 陷阱:用循环一条一条 INSERT 上万条数据,速度极慢。 解决方案:改用批量插入(一条 SQL 插入多行),速度提升几十倍。
【分页性能】 陷阱:使用 LIMIT 1000000, 10 时,越往后查询越慢。 解决方案:改用“游标分页”——记录上次查询的最大 id, 使用 WHERE id > 上次最大id LIMIT 10。
语法
窗口函数
1. 什么是窗口函数?
窗口函数(Window Functions)是 MySQL 8.0 引入的一种数据分析利器。它允许你在不改变原始数据行数的前提下,对数据集的一个特定子集(即“窗口”)执行计算。
与传统的 GROUP BY 聚合函数(如 SUM、AVG)不同,后者会将多行折叠为一行汇总结果,而窗口函数会为结果集中的每一行都保留自己的计算结果,因此非常适合做排名、累计、移动平均、环比分析等任务。
2. 核心语法:OVER() 子句
窗口函数通过 OVER() 子句定义其作用的“窗口”。基本格式如下:
<窗口函数> OVER (
    [PARTITION BY <分组列>]   -- 1. 分区:定义分组,每个分区独立计算
    [ORDER BY <排序列>]       -- 2. 排序:定义窗口内的顺序(排名函数必须)
    [<行或范围子句>]          -- 3. 框架:精确控制窗口包含的行(可选)
)
2.1 PARTITION BY(分区)
- 将数据按指定列分成多个独立分区。
- 窗口函数在每个分区内独立计算(例如按部门分别排名)。
- 若省略,则整个结果集视为一个分区。
- 注意:
PARTITION BY不会减少结果集行数,与GROUP BY有本质区别。
2.2 ORDER BY(排序)
- 定义数据在窗口内的处理顺序。
- 对于排名函数(如
ROW_NUMBER()、RANK()、DENSE_RANK())以及LAG/LEAD等,ORDER BY 是必须的。 - 对于聚合窗口函数(如
SUM),排序会影响默认框架的范围。
2.3 窗口框架(Frame Clause)
通过 ROWS 或 RANGE 关键字进一步限定窗口包含的行范围,常用于移动平均、累计和等。
ROWS:基于当前行的物理位置(前/后固定行数)。RANGE:基于当前行的逻辑值范围(例如与当前行值相同的所有行)。
常见边界关键字:
UNBOUNDED PRECEDING– 分区内第一行n PRECEDING– 当前行之前的 n 行CURRENT ROW– 当前行n FOLLOWING– 当前行之后的 n 行UNBOUNDED FOLLOWING– 分区内最后一行
默认框架规则(非常重要):
- 如果
OVER()中有ORDER BY,默认框架为:
RANGE BETWEEN UNBOUNDED PRECEDING AND CURRENT ROW
(即从分区开头到当前行,按逻辑值范围) - 如果
OVER()中没有ORDER BY,默认框架为:
ROWS BETWEEN UNBOUNDED PRECEDING AND UNBOUNDED FOLLOWING
(即整个分区所有行)
3. 常用窗口函数分类
3.1 序号 / 排名函数
| 函数 | 描述 | 示例场景 |
|---|---|---|
ROW_NUMBER() | 为每一行分配唯一且连续的序号(1, 2, 3…),相同值不会并列 | 为各部门员工按工资生成唯一序列号 |
RANK() | 相同值排名相同,但下一个排名会跳号(如 1, 2, 2, 4…) | 竞赛排名,允许并列但名次空缺 |
DENSE_RANK() | 相同值排名相同,下一个排名连续(如 1, 2, 2, 3…) | 绩效评级,并列且不空缺名次 |
示例:查询每个班级学生的成绩排名
SELECT
    name,
    class,
    score,
    ROW_NUMBER() OVER (PARTITION BY class ORDER BY score DESC) AS row_num_rank,
    RANK()       OVER (PARTITION BY class ORDER BY score DESC) AS rank_rank,
    DENSE_RANK() OVER (PARTITION BY class ORDER BY score DESC) AS dense_rank_rank
FROM students;
3.2 分析 / 聚合函数
| 函数 | 描述 | 示例场景 |
|---|---|---|
SUM(), AVG(), MAX(), MIN() | 窗口内的总和、平均值、最大/最小值 | 计算部门工资总和、累计销售额 |
LAG() | 访问当前行之前的某一行数据(可指定偏移量) | 计算环比增长率(与上月比较) |
LEAD() | 访问当前行之后的某一行数据 | 计算与下月的销售差额 |
FIRST_VALUE() | 返回窗口框架中第一行的值 | 获取部门最高工资的员工姓名 |
LAST_VALUE() | 返回窗口框架中最后一行的值(注意默认框架范围) | 获取部门最低工资的员工姓名(需调整框架) |
NTILE(n) | 将分区内行尽可能均匀地分配到 n 个桶中,返回桶号(1~n) | 员工工资四分位数等级 |
示例:计算累计销售额与环比增长率
SELECT
    month,
    amount,
    SUM(amount) OVER (ORDER BY month) AS cumulative_sales,
    (amount - LAG(amount, 1) OVER (ORDER BY month))
    / LAG(amount, 1) OVER (ORDER BY month) * 100 AS growth_rate
FROM sales;
4. 窗口框架实战
需求:计算近 3 笔销售记录的移动平均销售额(当前行及前两行)。
SELECT
    sale_date,
    amount,
    AVG(amount) OVER (ORDER BY sale_date
                      ROWS BETWEEN 2 PRECEDING AND CURRENT ROW) AS moving_avg_3days
FROM sales;注意:若使用 RANGE 而非 ROWS,则会基于 sale_date 的值范围,可能导致包含多天同一值,结果不同,需根据业务选择。
5. 重要注意事项
| 项目 | 说明 |
|---|---|
| 版本要求 | 窗口函数仅在 MySQL 8.0+ 中可用,5.7 及以下版本不支持。 |
| 使用位置 | 窗口函数只能出现在 SELECT 列表和 ORDER BY 子句中,不能用于 WHERE、GROUP BY、HAVING。 |
| 执行顺序 | 窗口函数的计算发生在 WHERE、GROUP BY、HAVING 子句之后,但在 ORDER BY、LIMIT、SELECT DISTINCT 之前。这意味着窗口函数可以使用过滤后的结果集,但无法在 WHERE 中直接引用窗口函数别名。 |
| NULL 值处理 | 目前 MySQL 仅支持 RESPECT NULLS(默认,即计算时包含 NULL 值),IGNORE NULLS 虽然语法能解析,但实际执行会报错(截至 8.0 版本)。 |
6. 总结与最佳实践
窗口函数为 MySQL 带来了强大的数据分析能力,尤其适用于以下场景:
- 排名与分组统计(ROW_NUMBER, RANK, DENSE_RANK)
- 滚动聚合(移动平均、累计和、累计计数)
- 跨行引用(LAG/LEAD 做环比、同比)
- 分位数分析(NTILE 做十分位、四分位)
使用建议:
- 始终明确
PARTITION BY和ORDER BY,避免意外全局计算。 - 当使用
LAST_VALUE或自定义框架时,务必显式声明框架边界,避免默认框架带来的误解。 - 结合
EXPLAIN查看执行计划,窗口函数可能影响性能,大数据集上要注意索引优化。
常用函数
1. 聚合函数 (Aggregate Functions)
对一组值进行计算,返回单一汇总值,常与 GROUP BY 配合使用。
| 函数 | 描述 | 示例 |
|---|---|---|
COUNT() | 统计行数。COUNT(*) 统计所有行,COUNT(列名) 忽略 NULL。 | SELECT COUNT(*) FROM users; |
SUM() | 计算数值列总和,忽略 NULL。 | SELECT SUM(salary) FROM employees; |
AVG() | 计算平均值,忽略 NULL。 | SELECT AVG(score) FROM exams; |
MAX() | 返回最大值。 | SELECT MAX(price) FROM products; |
MIN() | 返回最小值。 | SELECT MIN(price) FROM products; |
GROUP_CONCAT() | 将分组内的值连接为字符串。 | SELECT GROUP_CONCAT(name) FROM students; |
2. 字符串函数 (String Functions)
用于处理和操作文本数据。
| 函数 | 描述 | 示例 |
|---|---|---|
CONCAT() | 连接多个字符串。 | SELECT CONCAT('Hello', ' ', 'World'); |
LENGTH() / CHAR_LENGTH() | 前者返回字节长度,后者返回字符数。 | SELECT CHAR_LENGTH('数据库'); → 3 |
SUBSTRING() | 提取子串,位置从 1 开始。 | SELECT SUBSTRING('Hello World', 1, 5); → ‘Hello’ |
UPPER() / LOWER() | 转换大小写。 | SELECT UPPER('mysql'); → ‘MYSQL’ |
TRIM() | 去除首尾空格或指定字符。 | SELECT TRIM(' text '); → ‘text’ |
REPLACE() | 替换子串。 | SELECT REPLACE('MySQL is great', 'great', 'awesome'); |
LPAD() / RPAD() | 左/右填充至指定长度。 | SELECT LPAD('01', 5, '-'); → ‘---01’ |
3. 日期和时间函数 (Date and Time Functions)
处理日期时间类型的数据。
| 函数 | 描述 | 示例 |
|---|---|---|
NOW() | 返回当前日期和时间。 | SELECT NOW(); |
CURDATE() / CURTIME() | 返回当前日期或时间。 | SELECT CURDATE(); → ‘2026-07-20’ |
DATE_FORMAT() | 按格式字符串格式化日期。 | SELECT DATE_FORMAT(NOW(), '%Y-%m-%d'); |
DATE_ADD() / DATE_SUB() | 日期加减运算。 | SELECT DATE_ADD('2026-07-20', INTERVAL 10 DAY); |
DATEDIFF() | 计算两个日期的天数差。 | SELECT DATEDIFF('2026-07-30', '2026-07-20'); → 10 |
YEAR() / MONTH() / DAY() | 提取年、月、日。 | SELECT YEAR('2026-07-20'); → 2026 |
4. 数学函数 (Mathematical Functions)
执行常用数学运算。
| 函数 | 描述 | 示例 |
|---|---|---|
ABS() | 返回绝对值。 | SELECT ABS(-123); → 123 |
ROUND() | 四舍五入,可指定小数位数。 | SELECT ROUND(123.456, 2); → 123.46 |
CEIL() / FLOOR() | 向上/向下取整。 | SELECT CEIL(3.14), FLOOR(3.99); → 4, 3 |
RAND() | 返回 0~1 的随机数。 | SELECT RAND(); |
MOD() | 取模(余数)。 | SELECT MOD(10, 3); → 1 |
POWER() / SQRT() | 幂运算和平方根。 | SELECT POWER(2, 3), SQRT(16); → 8, 4 |
5. 控制流函数 (Control Flow Functions)
实现条件判断逻辑。
| 函数 | 描述 | 示例 |
|---|---|---|
IF() | 条件成立返回一个值,否则返回另一个。 | SELECT IF(1 > 0, 'true', 'false'); → ‘true’ |
IFNULL() | 若表达式为 NULL,返回默认值。 | SELECT IFNULL(column_name, '默认值') FROM table; |
CASE | 多条件分支,功能类似 switch。 | SELECT CASE WHEN score >= 60 THEN '及格' ELSE '不及格' END; |
6. 类型转换函数 (Type Conversion Functions)
转换数据类型。
| 函数 | 描述 | 示例 |
|---|---|---|
CAST() | 将表达式转为指定类型。 | SELECT CAST('123' AS SIGNED); → 整数 123 |
CONVERT() | 类似 CAST(),额外支持字符集转换。 | SELECT CONVERT('2026-07-20', DATE); → 日期 |
7. 其他实用函数
- 系统信息:
VERSION()返回数据库版本,DATABASE()返回当前数据库名。 - 加密函数:
MD5()、SHA1()等用于哈希加密。
索引
概念:对数据表中所有记录的引用指针(书的目录,加快查询效率)
作用:1.加快对表中记录的查找或排序,降低数据库的IO成本,排序成本 2.通过创建唯一性索引,保证数据表中每一行数据的唯一性
副作用:1.索引需要占用额外的磁盘空间 InnoDB引擎的表数据文件本身就是索引文件,MyISAM索引文件和数据文件分离,索引文件用于保存数据记录的地址 2.插入和修改数据时索引需要变动
事务
事务将一组 SQL 语句捆绑在一起,要么全部执行成功(提交 Commit),要么全部不执行(回滚 Rollback),从而保证数据的完整性和一致性。
事务的生命周期
- 开始事务(BEGIN / START TRANSACTION): 显式开启一个新事务。InnoDB 中也可通过设置
autocommit=1来隐式开启。 - 执行操作: 在事务中执行一系列的 DML(INSERT、UPDATE、DELETE)操作。
- 提交(COMMIT): 将事务中所有的修改持久化到磁盘,使其永久生效且对其他事务可见。
- 回滚(ROLLBACK): 撤销事务中所有的修改,数据库恢复到事务开始前的状态。
- 保存点(SAVEPOINT): 在事务内部设置标记点,可以部分回滚到某个保存点而不回滚整个事务。
MVCC
MVCC(Multi-Version Concurrency Control)是 InnoDB 实现事务隔离的核心机制。它使得读操作不用加锁也能读取到一致性的数据,从而实现读不阻塞写,写不阻塞读。
1 MVCC 核心概念
基本思想: 为每一行数据维护多个版本,每个事务根据其开始的时机,看到对应的数据快照。
核心要素:
-
隐藏列: InnoDB 的每行数据都有三个隐藏列:
DB_TRX_ID(6字节):最后一次插入或更新该行的事务 ID。DB_ROLL_PTR(7字节):回滚指针,指向该行的上一个版本(存储在 Undo Log 中)。DB_ROW_ID(6字节):隐含的自增 ID,当表没有显式主键时使用。
-
Undo Log(回滚日志): 存储数据的历史版本链表。每次修改数据时,先将当前数据复制到 Undo Log,然后修改原始数据。多个 Undo Log 通过
DB_ROLL_PTR连接形成版本链。 -
ReadView(读视图 / 快照): 决定了事务在某一时刻能看到哪些版本的数据。
2 ReadView 详解
ReadView 是 MVCC 的核心判断工具,它包含以下关键信息:
| 字段 | 含义 |
|---|---|
m_ids | 创建 ReadView 时,系统中活跃的(未提交的)事务 ID 列表 |
min_trx_id | m_ids 中的最小事务 ID |
max_trx_id | 创建 ReadView 时,系统下一个将分配的事务 ID |
creator_trx_id | 创建该 ReadView 的事务 ID |
版本可见性判断规则——访问某行数据时,根据其 DB_TRX_ID 做判断:
- 如果
DB_TRX_ID == creator_trx_id: 可见。这是事务自己修改的数据。 - 如果
DB_TRX_ID < min_trx_id: 可见。修改该行的事务在 ReadView 创建前已提交。 - 如果
DB_TRX_ID >= max_trx_id: 不可见。修改该行的事务在 ReadView 创建后才开始。 - 如果
min_trx_id <= DB_TRX_ID < max_trx_id: 检查DB_TRX_ID是否在m_ids中。- 如果 在 m_ids 中:不可见。修改该行的事务尚未提交。
- 如果 不在 m_ids 中:可见。修改该行的事务在 ReadView 创建时已提交。
如果当前版本不可见,则沿着 Undo Log 版本链回溯,直到找到第一个可见的版本。
3 ReadView 在不同隔离级别下的生成时机
这是理解隔离级别和 MVCC 关系的关键。
-
READ COMMITTED: 事务中每次执行 SELECT 语句时,都生成一个新的 ReadView。因此每次读取都能看到最新的已提交数据,导致不可重复读。
-
REPEATABLE READ: 事务第一次执行 SELECT 语句时生成 ReadView,整个事务期间复用。因此无论其他事务是否提交,本事务读到的始终是同一份快照,实现可重复读。
-
READ UNCOMMITTED: 不使用 MVCC 的快照读,直接读最新版本(不管是否已提交)。
-
SERIALIZABLE: 所有读操作加共享锁,通过锁而非 MVCC 保证一致性。
5 MVCC 的适用场景与限制
MVCC 生效的场景: 普通 SELECT 语句(一致性非锁定读 / 快照读)。
MVCC 不生效的场景(当前读):
SELECT ... FOR UPDATE(排他锁读)SELECT ... FOR SHARE(共享锁读,MySQL 8.0 前为LOCK IN SHARE MODE)UPDATE、DELETE、INSERT等 DML 操作
当执行当前读时,必须读取最新已提交的版本,并加锁防止并发修改。
锁
一、锁的基本分类
-
MySQL 中有哪些锁? 可以从三个角度分类: 按粒度:全局锁、表锁、页锁、行锁。 按类型:共享锁、排他锁。 InnoDB 特有或常见锁:记录锁、间隙锁、临键锁、意向锁、自增锁、MDL 锁。
-
表锁和行锁有什么区别? 表锁锁住整张表,加锁速度快、开销小,但并发能力较低。 行锁只锁定相关记录,并发能力更高,但加锁和维护成本更大。 InnoDB 主要使用行锁,MyISAM 主要使用表锁。
-
共享锁和排他锁有什么区别? 共享锁也叫读锁。多个事务可以同时持有共享锁并读取数据,但不能修改被锁定的数据。 排他锁也叫写锁。事务持有排他锁后,其他事务不能再对相关数据加共享锁或排他锁,通常用于修改和删除数据。
-
什么是全局锁? 全局锁会锁住整个数据库实例,主要用于全库备份,保证备份期间数据处于相对一致的状态。 全局锁影响范围很大,会阻塞数据库的写操作,因此生产环境中通常要谨慎使用。
-
什么是意向锁? 意向锁是表级锁,用来表示事务准备给表中的某些行加锁。 主要有: 意向共享锁:表示事务准备给某些行加共享锁。 意向排他锁:表示事务准备给某些行加排他锁。 意向锁的作用是协调表锁和行锁之间的冲突,使数据库不需要逐行检查表中是否存在行锁。
-
什么是记录锁? 记录锁是锁住索引上的某一条记录,防止其他事务修改或删除这条记录。 InnoDB 的行锁本质上是加在索引记录上的。
-
什么是间隙锁? 间隙锁锁住索引记录之间的范围,不锁定具体记录,主要用于阻止其他事务在这个范围内插入数据。 它主要用于防止幻读。
-
什么是临键锁? 临键锁等于记录锁加间隙锁。 它既锁住当前索引记录,也锁住记录前面的索引间隙,是 InnoDB 在 RR 隔离级别下进行范围查询时常见的锁。
-
什么是自增锁? 自增锁用于控制自增列的值分配,保证多个事务并发插入时能够正确生成自增值。 它主要影响自增字段的并发插入行为。
-
什么是 MDL 锁? MDL 是元数据锁,用于保护表结构和表定义。 普通查询、更新通常会持有 MDL 读锁;修改表结构的 DDL 操作通常需要 MDL 写锁。 如果存在长事务没有提交,DDL 可能长时间等待 MDL 锁。
二、索引与加锁 11. InnoDB 行锁为什么依赖索引? 因为 InnoDB 的锁是加在索引记录上的,而不是直接加在数据行的物理位置上。 如果查询条件没有合适索引,数据库可能扫描大量记录并锁住大量索引记录,导致并发能力下降,效果上接近表锁。
-
主键查询一定只锁一条记录吗? 不一定。 需要结合查询条件、索引情况、事务隔离级别、记录是否存在以及查询是快照读还是当前读来判断。 如果是唯一索引等值查询并且记录存在,通常锁定范围较小;如果是范围查询或没有命中合适索引,锁定范围可能扩大。
-
唯一索引和普通索引加锁有什么区别? 唯一索引能够准确定位记录,通常锁定范围较小。 普通索引可能匹配多条记录,InnoDB 可能同时锁定二级索引记录和对应的聚簇索引记录,锁的数量和范围可能更大。
-
等值查询和范围查询的加锁有什么区别? 等值查询通常锁定匹配的记录。 范围查询除了锁定已有记录,还可能锁定索引间隙,从而阻止其他事务插入范围内的新记录。 在 RR 隔离级别下,范围查询更容易涉及临键锁。
-
为什么一条更新语句会阻塞很多事务? 常见原因包括: 查询条件没有合适索引; 更新范围过大; 事务没有及时提交; 使用了范围条件并产生间隙锁或临键锁; 多个事务同时修改相同热点数据; 表结构变更受到 MDL 锁阻塞。
三、隔离级别、MVCC 与锁 16. 什么是快照读和当前读? 快照读读取事务可见的数据版本,主要依赖 MVCC,通常不会加锁。 当前读要求读取最新版本的数据,并且通常需要加锁。修改、删除以及带锁的查询都属于当前读。
-
MVCC 和锁有什么关系? MVCC 主要解决普通读和写之间的并发冲突,让读操作尽量不阻塞写操作。 锁主要用于控制当前读、数据修改和并发写入。 两者配合实现事务隔离:普通查询主要依靠 MVCC,修改和加锁查询主要依靠锁。
-
RC 和 RR 隔离级别下加锁有什么区别? RC,也就是读已提交,通常只锁定实际匹配到的记录,间隙锁使用较少。 RR,也就是可重复读,是 InnoDB 默认隔离级别。当前读时可能使用间隙锁和临键锁,以防止其他事务插入数据造成幻读。
-
普通查询为什么通常不加锁? 普通查询一般使用 MVCC 读取快照版本,不需要阻塞其他事务的修改,因此通常不会加锁。 但是带有加锁读取语义的查询会读取最新版本并获取相应锁。
-
间隙锁解决了什么问题? 间隙锁阻止其他事务在索引范围内插入新记录,从而避免同一个事务前后两次范围查询得到不同数量的记录。 它主要用于防止 RR 隔离级别下的幻读。
四、锁升级 22. 什么是锁升级? 锁升级通常指锁的粒度变大,例如从行锁升级为页锁或表锁。 这样可以减少锁对象数量,降低锁管理成本,但会降低并发能力。
-
MySQL InnoDB 会自动把行锁升级为表锁吗? 通常不会。 InnoDB 一般不会因为锁住的记录太多,就自动把行锁升级成表锁。 但是如果没有合适索引、锁定范围过大,或者主动使用表锁,最终表现可能类似于表锁,导致大量事务被阻塞。
-
什么是锁转换或锁类型升级? 锁转换是指同一个事务持有的锁类型发生变化,例如从共享锁转换为排他锁。 多个事务都持有共享锁并同时尝试转换为排他锁时,可能产生互相等待,进而导致死锁。
五、死锁与锁等待 25. 什么是锁等待? 一个事务持有某个锁,另一个事务需要这个锁,只能等待前一个事务释放锁,这就是锁等待。 锁等待不一定是死锁,前一个事务提交后,后一个事务仍然可以继续执行。
-
什么是死锁? 死锁是多个事务互相持有对方需要的锁,并形成循环等待。 例如事务 A 等待事务 B 释放锁,事务 B 又等待事务 A 释放锁。
-
MySQL 发生死锁后如何处理? InnoDB 会检测死锁,并选择一个事务进行回滚,释放它持有的锁,让其他事务继续执行。 应用程序需要捕获死锁异常,并根据业务情况进行重试。
-
如何预防死锁? 常见方法包括: 多个事务按照相同顺序访问数据; 缩短事务执行时间; 减少事务中处理的数据量; 为查询条件建立合适索引; 避免大范围更新和删除; 尽量避免事务中执行耗时操作; 对热点数据进行合理拆分; 对死锁异常进行有限次数重试。
六、事务与实际场景 30. 事务提交后锁什么时候释放? InnoDB 的记录锁、间隙锁等事务锁通常在事务提交或回滚时释放,而不是一条语句执行结束后立即释放。 因此事务开启后长时间不提交,可能持续阻塞其他事务。
-
长事务有什么危害? 长事务会长时间持有锁,增加锁等待和死锁风险。 同时还可能导致 undo 日志无法及时清理、历史版本堆积、数据库空间增长以及性能下降。
-
如何排查锁等待? 可以从以下方面排查: 当前正在执行的事务; 哪个事务持有锁; 哪个事务正在等待; 锁住了哪些表和索引; 事务持续了多长时间; 是否存在未提交的长事务。 常用工具包括进程列表、InnoDB 状态信息以及 Performance Schema 中的锁等待信息。
-
如何避免库存超卖? 应当让“判断库存”和“扣减库存”在数据库中以一个原子操作完成,并通过受影响行数判断扣减是否成功。 如果库存大于零才允许扣减,这个判断必须和扣减动作一起执行,不能先查询库存,再单独执行扣减。
-
如何避免热点数据被频繁锁阻塞? 可以采用以下方式: 缩短事务时间; 减少单次更新范围; 优化索引; 将热点数据拆分; 使用队列削峰; 合理控制并发; 必要时采用乐观锁或版本号机制。
面试时可以重点记住这一条主线: MySQL 锁的核心是锁的粒度、锁的类型、索引对加锁范围的影响,以及隔离级别对记录锁、间隙锁和临键锁的影响;实际问题通常表现为锁等待、死锁、长事务和大范围锁定。
MySQL优化
主键策略
常见主键策略对比
| 策略 | 生成方式 | 优点 | 缺点 | 适用场景 |
|---|---|---|---|---|
| 自增 ID (AUTO_INCREMENT) | 数据库自动维护的递增整数 | 性能极佳,写入快,索引紧凑;存储空间小(INT 4字节 / BIGINT 8字节);简单易用,开发成本低 | 分布式下 ID 可能冲突;ID 可预测,存在安全风险;不携带任何业务信息 | 单库单表的 OLTP 系统,适合后台管理、内容管理等对性能和简洁性要求高的场景 |
| UUID | 由时间、时钟序列等生成的 128 位全局唯一标识符 | 全局唯一,无需中心节点协调;安全性高,ID 不可预测 | 写入性能差,随机插入易引发页分裂;存储空间占用大;可读性差 | 分布式系统中需要离线生成 ID、对安全性要求高,写入性能非首要诉求的场景(如日志表) |
| 雪花算法 (Snowflake) | 基于时间戳、机器 ID、序列号组成的 64 位唯一 ID | 分布式友好,全局唯一且趋势递增;性能与存储均衡,占用 8 字节;高并发性能优异 | 依赖系统时钟,时钟回拨易造成 ID 重复;需手动分配维护机器 ID,部署复杂 | 分布式、高并发业务系统,适用于订单、用户、日志、支付等核心业务场景 |
| 业务字段组合 | 采用一个或多个具备唯一性的业务字段组合作为主键 | 自带业务语义,可读性强;可减少关联查询,查询效率更高 | 与业务高度耦合,业务变更易导致主键失效;组合字段过长会影响索引性能 | 具备稳定、唯一固定业务标识的场景,如设备 MAC 地址、专属业务编码、关联中间表等 |
分布式环境下的主键方案
当系统进入分布式、分库分表阶段,自增 ID 就无法保证全局唯一了。这时,主要有以下几种解决方案:
-
设置自增步长
为不同数据库实例设置不同的auto_increment_increment和auto_increment_offset。但这种方式扩展性较差,节点数量固定后难以调整。 -
雪花算法 (Snowflake)
应用层生成,是分布式系统中最受欢迎的方案之一。 -
数据库分段号段
应用从数据库批量获取 ID 段,用完再取。此方案减少了数据库访问,性能较好,但引入了新的组件和维护复杂度。 -
分布式 ID 生成器
使用如 ZooKeeper、Etcd 等协调服务,或专门的 ID 生成服务(如美团的 Leaf)来统一发放 ID。
总结与选型建议
如何选择,可以参考以下建议:
- 单机 / 小型项目:首选自增 ID。它简单、高效,是绝大多数情况下的最优解。
- 分布式 / 分库分表:
- 追求高性能和可运维性:雪花算法 (Snowflake) 是很好的平衡选择。
- 追求极致简单:可考虑 UUID,但必须清楚它在写入性能上的代价。
- 需要隐藏业务量:选择 UUID 或 雪花算法。
- 特殊业务需求:若存在 稳定且唯一 的业务字段,可考虑直接使用 业务字段组合。
总的来说,没有“最好”的策略,只有“最合适”的策略。你需要根据业务场景、系统架构、性能要求和未来发展规划来综合权衡和选择。
数据库设计优化
表设计原则: 1.存储引擎 默认用 InnoDB(支持事务、行锁),不用MyISAM 2.字符集 统一 utf8mb4(支持emoji,真正的UTF-8) 3.字段类型 够用就行,越小越好(TINYINT > INT > BIGINT) 4.禁止三无 无主键、无索引、无外键(外键在应用层保证) 5.NOT NULL 字段尽量 NOT NULL + DEFAULT,NULL会让索引失效、统计不准
索引设计核心: 1.区分度高的列建索引:性别(区分度50%)建索引没用,身份证(区分度100%)才有价值 2.最左前缀原则:联合索引必须从索引的最左列开始匹配,且不,否能跳过中间列则后续列的索引全部失效 3.覆盖索引:查询只走索引不回表
不可以做的事: 1.select * 2.隐式类型转换 3.索引列使用函数 4.like %abc 5.大表alter 6.枚举用enum,要用 tinyint + 字典表
命名规范: 1.表明和字段: 小写 + 下划线,不可以使用驼峰 2.主键: id(自增BIGINT) 3.通用字段: create_time、update_time(DATETIME,自动更新) 4.索引命名:idx_字段名(普通)、uniq_字段名(唯一)
联合索引口诀:WHERE等值放左边,ORDER BY紧跟后,范围查询放最后
索引优化
导致索引失效的情况: 1.使用计算或者函数 2.使用前模糊查询 3,使用 != 或者 < 或者 > 4.使用 is not null 或者 is null
EXPLAIN解读 (只需要看这五个): 在sql前加上 explain 1.type: const > ref > range > index > ALL(至少到range,别出现ALL) 2.possible_keys: 列出可能用的索引,空说明没索引可用 3.key: 实际用的索引,空说明索引失效或没建 4.key_len: 算出实际用了几列 5.Extra: Using index(覆盖索引,最好);Using filesort(文件排序,要优化);Using temporary(临时表,要优化)
查询优化
配置优化
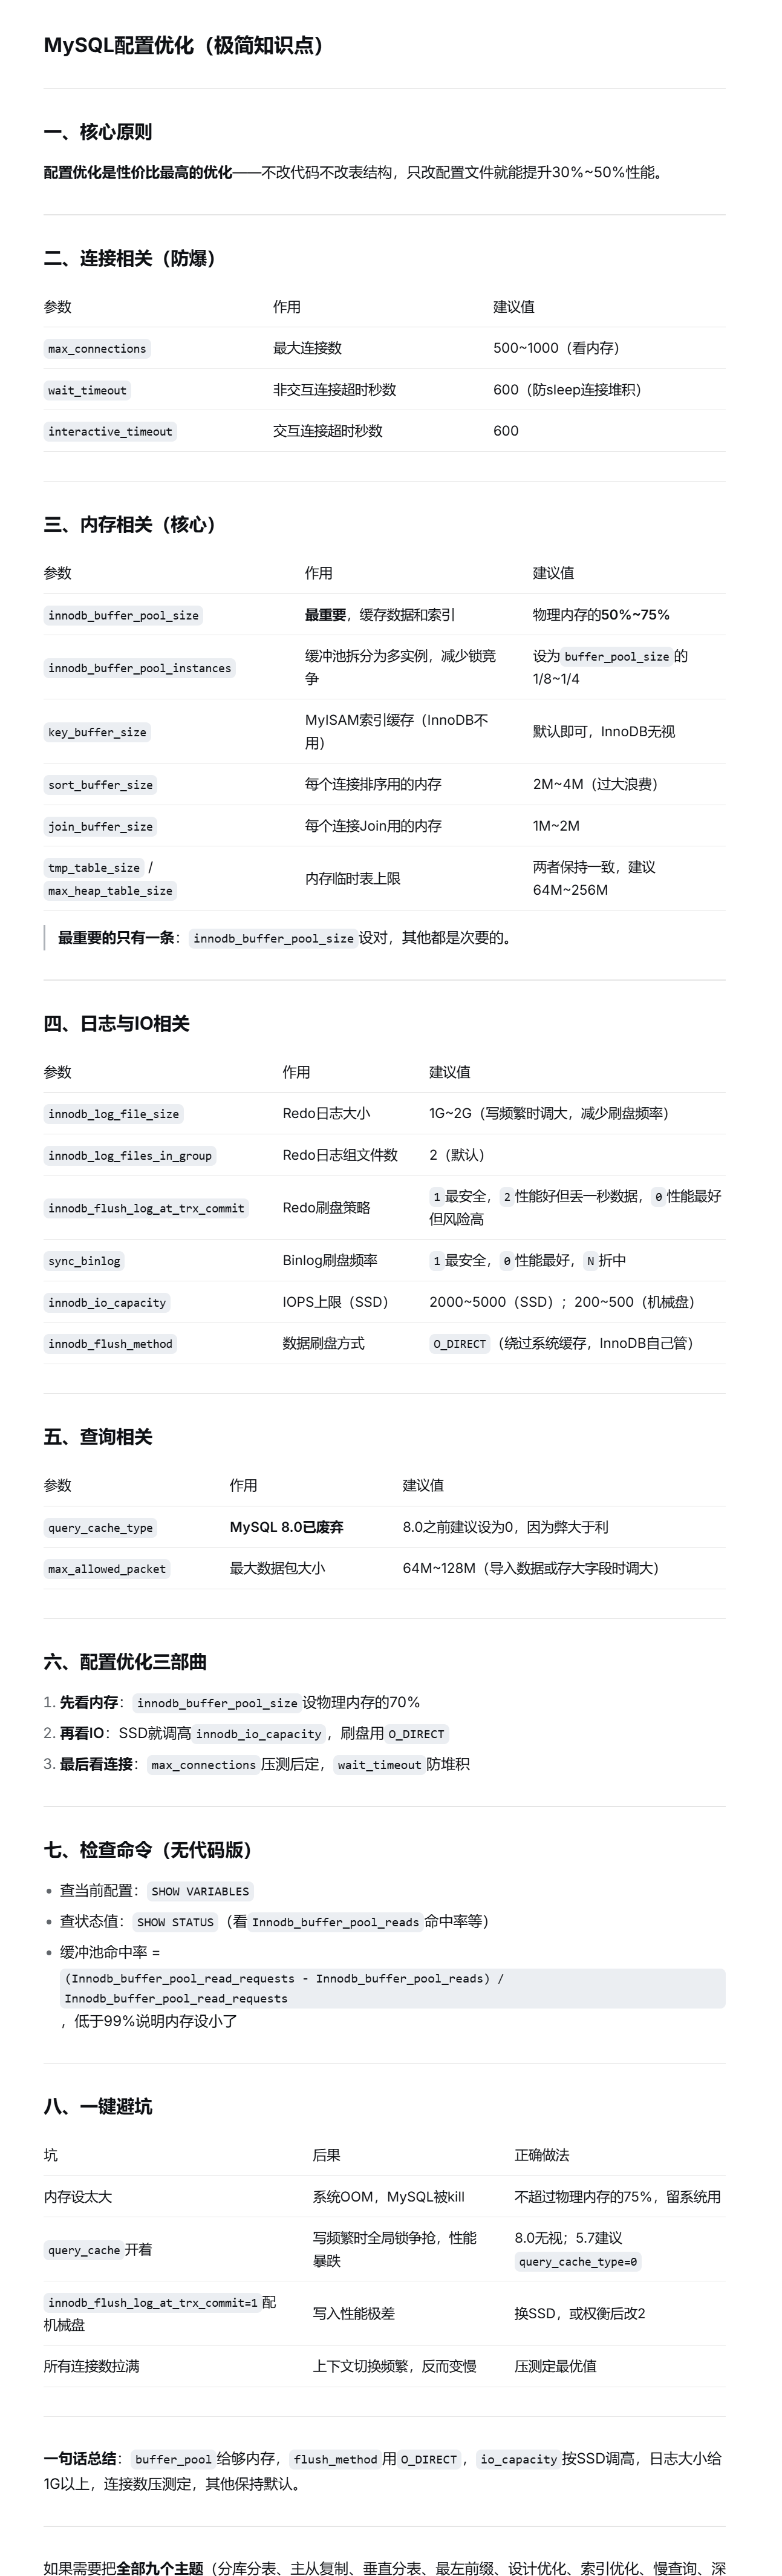
架构优化
架构优化的本质: 不碰SQL和表结构,通过调整系统部署方式来提升性能、可用性和扩展性
三大方向: 1.高可用 2.读写分离:读多写少时,从库扛读压力,主库专心写 3.扩展性
高可用方案(4选1): 1.主从+手动切换 2.MHA:是MySQL主库故障自动切换的高可用方案,能在30秒内完成从库提升为新主库 3.MGR:是MySQL官方自带的分布式集群高可用方案,基于Paxos分布式一致性协议,保证集群内数据强一致 4.双主热备:两台互为主从
集群
分库分表
为什么使用分库分表? 1.数据量瓶颈 2.写入性能 3.扩容困难
策略: 1.垂直分库:按业务模块拆分(解耦业务,分散IO压力) 2.垂直分表:按字段热度拆分(减少单行数据页大小,提高缓存命中率) 3.水平分库:按分片键Hash将数据打散到多个库(突破单库连接数和磁盘容量) 4.水平分表:按分片键Range/Hash拆成多张结构相同表(减少单表索引层级,提升DML速度)
分片键的选择:(分片键不可修改) 需满足高频查询条件。选择不当会导致“非分片键查询需扫全库” 1.最佳实践:优先选订单ID或用户ID。 2.迂回策略:若必须按商家查询,建立“索引表”(商家ID -> 分片键)或引入ES做异构查询
字段选择: 1.把大字段(BLOB/TEXT)请出去 2.把低频查询字段挪走 3.把“写热点”字段隔离 4.把可选字段(NULL率高)合并或外置
主从复制
MySQL主从复制,简单说就是将主库的数据变更,实时同步到一个或多个从库。它是一切高可用和读写分离的基石。
核心流程: 1.主库 Binlog Dump 线程:主库把数据变更按顺序写入Binlog。当从库连接时,这个线程负责把Binlog内容实时推给从库 2.从库 I/O 线程:接收主库推送的日志,先写入从库的中继日志(Relay Log),相当于在本地暂存一份 3.从库 SQL 线程:不断重放Relay Log里的SQL语句,把变更应用到从库数据上
注意点: 主从复制是异步的,主库写完Binlog就返回客户端成功,不管从库是否收到。这也是性能好但可能丢数据的原因
常见的三种复制模式 1.异步复制:一致性弱,性能高 2.半同步复制(生产环境最常用):一致性中,性能中 3.全同步复制:一致性强,性能极低
复制延迟问题:主库写入量大(如大事务、批量导入),从库的SQL线程是单线程重放,速度跟不上主库的并发写入
解决方案: 1.并行复制 2.拆大事务 3.从库硬件不低于主库 4.业务降级:对于实时性要求极高的查询(如扣库存),强制走主库
常见架构方案: 1.一主一从 2.一主多从 3.级联复制:主库只同步给一个从库A,A再同步给更多从库 4.双主热备:两台互为主从
ACID
ACID 是事务的四个基本特性的缩写,是衡量事务可靠性的金标准。
1 原子性(Atomicity)
定义: 事务是一个不可分割的工作单位,其中的操作要么全部成功,要么全部失败回滚。不存在部分成功、部分失败的状态。
实现机制: InnoDB 通过 Undo Log(回滚日志) 实现原子性。当事务需要回滚时,InnoDB 利用 Undo Log 中记录的反向操作将数据恢复到事务开始前的状态。
关键理解:
- 原子性保证的是事务内部的完整性,不关心并发事务的相互影响。
- 如果在事务执行过程中发生系统崩溃,重启后 InnoDB 会利用 Undo Log 将未完成事务的所有修改回滚。
2 一致性(Consistency)
定义: 事务执行前后,数据库必须从一个一致性状态转换到另一个一致性状态。所有数据必须满足预定义的规则(如主键唯一、外键约束、字段非空等)。
实现机制: 一致性是一个综合性的目标,它依赖于:
- 原子性保证事务不会留下中间状态。
- 隔离性防止并发事务看到不一致的中间数据。
- 持久性保证提交后的数据不会丢失。
- 数据库层面的约束(主键、外键、CHECK、NOT NULL、UNIQUE 等)确保数据的语义正确性。
关键理解:
- 一致性是 ACID 的最终目标,A、I、D 是手段。
- 业务层面的数据一致性(如”账户余额不能为负”)需要数据库约束和应用层逻辑共同保证。
3 隔离性(Isolation)
定义: 多个事务并发执行时,一个事务的执行不应被其他事务干扰。每个事务都感觉自己是系统中唯一运行的事务。
实现机制: InnoDB 通过以下机制组合实现隔离性:
- MVCC(多版本并发控制): 实现非锁定的一致性读。
- 锁机制: 行锁、间隙锁(Gap Lock)、临键锁(Next-Key Lock)等。
- 隔离级别: 定义了事务之间隔离的程度。
关键理解:
- 绝对的隔离(串行化)会严重降低并发性能。
- 实际的隔离性是”程度”问题,不同的隔离级别在一致性和性能之间做取舍。
4 持久性(Durability)
定义: 一旦事务提交成功,其对数据库的修改就是永久性的。即使系统崩溃或宕机,提交的事务也不会丢失。
实现机制: InnoDB 通过 Redo Log(重做日志) 实现持久性。使用的是 Write-Ahead Logging(WAL,预写日志)策略:
- 在修改数据页之前,先将变更写入 Redo Log。
- 即使发生崩溃,重启后可以利用 Redo Log 重放已提交事务的修改。
- 配合
innodb_flush_log_at_trx_commit参数控制 Redo Log 刷盘策略。
关键理解:
- Redo Log 是物理日志,记录的是”对某个数据页做了什么修改”。
- Redo Log 采用循环写的方式,有固定大小,写满后会触发脏页刷盘(Checkpoint 机制)。
存储引擎
核心存储引擎对比
1. InnoDB(默认首选,支持事务)
InnoDB 自 MySQL 5.5 起成为默认存储引擎,是绝大多数应用场景下的最佳选择。
| 特性 | 说明 |
|---|---|
| 事务支持 (ACID) | 支持原子性、一致性、隔离性和持久性,确保数据完整可靠。 |
| 行级锁 (Row-Level Locking) | 锁定粒度细,高并发写入时性能更优,有效减少锁冲突。 |
| 外键约束 (Foreign Key) | 支持外键,维护表间数据一致性和参照完整性。 |
| 崩溃恢复 (Crash Recovery) | 具备自动恢复能力,保障数据安全。 |
| 适用场景 | 绝大多数 OLTP 系统(如电商、金融、ERP、CRM 等对数据一致性和并发性要求高的应用)。 |
2. MyISAM(读多写少,轻量快速)
MyISAM 曾是 MySQL 5.5 之前的默认引擎。
| 特性 | 说明 |
|---|---|
| 表级锁 (Table-Level Locking) | 读写操作锁定整个表,高并发写入时易成瓶颈。 |
| 不支持事务 | 不具备 ACID 特性,无法回滚。 |
| 不支持外键 | 无法通过数据库层面保证关联数据一致性。 |
| 高性能读取 | 设计简单,读操作速度极快。 |
| 适用场景 | 以读为主、写操作少的场景(如数据仓库、报表、日志或历史数据查询)。 |
InnoDB支持聚簇索引,MyISAM不支持聚簇索引,
InnoDB是数据跟文件在一起,MyISAM是分开的,数据在.myd,索引在.myi
3. Memory(极速缓存,数据易失)
Memory 引擎将所有数据存储在内存中。
| 特性 | 说明 |
|---|---|
| 极快读写速度 | 数据在内存中,读写性能极高。 |
| 数据不持久 | 服务器重启或关闭后数据全部丢失。 |
| 表级锁 | 同样使用表级锁,高并发写入需谨慎。 |
| 适用场景 | 临时数据、缓存(如用户会话 Session、实时计数器、临时计算结果)。 |
其他存储引擎
- Archive:用于数据归档,仅支持
INSERT和SELECT,具有高压缩比,适合存储日志、审计等历史数据。 - NDB (Network Database):用于 MySQL 集群,提供高可用性和分布式存储能力。
- CSV:以逗号分隔的文本文件存储,便于与其他系统(如电子表格)交换数据。
- Federated:访问远程 MySQL 服务器上的表,实现逻辑分布式数据库。
如何选择存储引擎?
选择的核心是根据业务需求进行权衡:
- 默认选 InnoDB:不确定时,或应用涉及事务、高并发读写、需要数据完整性保障时,InnoDB 是最安全、最通用的选择。
- 读多写少可考虑 MyISAM:仅在应用几乎全是读操作(如数据仓库查询),且对一致性和并发写入要求不高时,可考虑。
- 临时数据用 Memory:用于存储可丢失的临时缓存数据,速度快但不持久。
- 混合使用:同一个数据库中可以为不同表选择不同引擎,例如订单表用 InnoDB,只读缓存表用 MyISAM。
关键字顺序
1. 书写顺序(写 SQL 时的顺序)
这是 SQL 语句必须遵循的语法结构,关键字必须按此顺序排列,否则会报错:
SELECT [DISTINCT] 字段/表达式
FROM 表名
[JOIN 表名 ON 连接条件]
[WHERE 条件]
[GROUP BY 分组字段]
[HAVING 分组后的过滤条件]
[ORDER BY 排序字段]
[LIMIT 偏移量, 行数];
2. 执行顺序(MySQL 运行时的逻辑顺序)
这是 MySQL 引擎真正处理数据的逻辑顺序。理解这一点,你就能明白为什么 WHERE 里不能用别名,而 ORDER BY 里可以。
(1) FROM  -> (2) JOIN/ON  -> (3) WHERE
-> (4) GROUP BY -> (5) HAVING
-> (6) SELECT  -> (7) DISTINCT
-> (8) ORDER BY -> (9) LIMIT
3. 核心避坑指南(由执行顺序决定)
以下规则直接来源于上述执行顺序,务必牢记:
-
WHERE 里不能用 SELECT 中的别名
- 因为
WHERE在第 3 步执行,而SELECT在第 6 步执行,此时别名还没生成。 - ❌ 错误示例:
SELECT name AS n FROM users WHERE n = '张三'; - ✅ 正确示例:
SELECT name AS n FROM users WHERE name = '张三';
- 因为
-
ORDER BY 里可以用 SELECT 中的别名
- 因为
ORDER BY在第 8 步执行,此时SELECT早已执行完,别名已经生成。 - ✅ 正确示例:
SELECT name AS n FROM users ORDER BY n;
- 因为
-
WHERE 不能使用聚合函数,HAVING 可以
- 因为
WHERE执行时数据还没分组,而HAVING在GROUP BY之后执行。 - ❌ 错误示例:
SELECT dept FROM staff WHERE COUNT(id) > 1; - ✅ 正确示例:
SELECT dept FROM staff GROUP BY dept HAVING COUNT(id) > 1;
- 因为
-
LIMIT 永远最后执行
- 它只作用于最终结果集,因此常用于分页优化。由于它在最后一步,对
LIMIT之前的庞大结果集无法提前裁剪,这也是深分页性能问题的根源之一。
- 它只作用于最终结果集,因此常用于分页优化。由于它在最后一步,对
4. 补充说明(MySQL 8.0 窗口函数)
如果你使用的是 MySQL 8.0+,引入了窗口函数(OVER 子句)。它的执行顺序比较特殊:
- 窗口函数通常在
FROM和JOIN之后、WHERE和GROUP BY之前 生成结果集(逻辑上位于SELECT阶段)。 - 这意味着你可以在
WHERE中过滤掉部分行之后,再对剩余行开窗计算,但窗口函数的结果本身不能直接用于WHERE过滤(需要嵌套子查询)。
总结:只要牢牢记住
FROM最先执行,SELECT在WHERE和GROUP BY之后才执行,绝大部分关于别名的疑惑都会迎刃而解。
逻辑架构
MySQL逻辑架构详解
MySQL的逻辑架构可以清晰地分为三层:连接层、服务层和存储引擎层。这种分层设计将查询处理与数据存储分离,尤其是插件式的存储引擎架构,让MySQL可以灵活适应各种不同的应用场景。
其核心工作流程是:客户端请求经由连接层接入,由服务层进行解析、优化和处理,最终通过存储引擎层的API完成数据存取。
第一层:连接层 (Connection Layer)
这一层负责与客户端建立连接和通信。
- 连接与线程管理:负责处理客户端的TCP/IP或Socket连接。每个客户端连接在服务端都对应一个线程,连接池技术可复用线程,减少创建/销毁的开销。
- 认证与授权:进行用户身份认证(用户名、主机、密码)。连接成功后,会根据权限表判断该用户对特定数据对象的操作权限。
第二层:服务层 (Server Layer)
这是MySQL的核心层,包含了大部分核心功能。
- SQL接口 (SQL Interface):接收并处理DML、DDL等SQL命令。
- 解析器 (Parser):对SQL进行词法和语法分析,生成“解析树”。
- 优化器 (Optimizer):对解析树进行优化,如重写查询、选择索引、决定表连接顺序等,最终生成“执行计划”。
- 缓存 (Caches & Buffers):在MySQL 8.0之前,有查询缓存,如果命中则直接返回结果,跳过后续步骤。但从8.0开始已被移除。
- 跨存储引擎功能:存储过程、触发器、视图等不依赖具体存储引擎的功能都在此层实现。
第三层:存储引擎层 (Storage Engine Layer)
这是MySQL最独特的地方,负责数据的存储和提取。
- 插件式架构:支持InnoDB、MyISAM等多种存储引擎,并可通过API与上层通信。
- 核心API:包含“开启事务”、“根据主键提取一行”等底层函数,但通常不负责解析SQL。
- 常见引擎:
- InnoDB:MySQL 5.5后的默认引擎,支持事务、行级锁和外键。
- MyISAM:早期的默认引擎,不支持事务,采用表级锁。
- Memory:将数据存储在内存中,速度极快,适合临时表。
一条SQL查询的过程
- 连接:客户端通过连接层认证并建立连接。
- 缓存查询:服务层检查查询缓存(8.0前),命中则直接返回。
- 解析与优化:未命中则进行解析生成解析树,并由优化器生成执行计划。
- 执行:服务器根据执行计划,调用存储引擎的API来读取或写入数据。
- 返回结果:数据返回给服务层,最终返回给客户端
慢查询
执行超时的SQL记录,阈值默认10秒,生产建议设1秒。 也是要看EXPLAIN
分析工具: 1.mysqldumpslow:MySQL自带,按时间/次数聚合统计 2.pt-query-digest:Percona出品,生成结构化报告,功能更强
慢SQL六大根因: 1.全表扫描 2.扫描行数过多 3.使用文件排序 4.使用临时表 5.深分页 6.锁等待
六大解法 1.建索引(覆盖索引最优) 2.条件过滤(缩小扫描范围) 3.排序字段纳入联合索引 4.分组/去重字段纳入联合索引 5.深分页改游标传值(记录上次位置) 6.大表查计数用缓存或走覆盖索引
约束
一、MySQL中的六大约束类型
- 非空约束 (NOT NULL):确保列中数据不能为NULL。
- 应用场景:必须有的字段,如用户名、邮箱。
- 示例:
CREATE TABLE users (id INT, name VARCHAR(50) NOT NULL);
- 唯一约束 (UNIQUE):确保列中所有数据互不相同。与主键不同,它允许有NULL值。
- 应用场景:不能重复的字段,如手机号、身份证号。
- 示例:
CREATE TABLE users (id INT, email VARCHAR(255) UNIQUE);
- 主键约束 (PRIMARY KEY):非空约束和唯一约束的组合,用于唯一标识表中的每一行。一个表只能有一个主键。
- 应用场景:每张表的唯一标识,如用户ID、订单ID。
- 示例:
CREATE TABLE users (id INT PRIMARY KEY AUTO_INCREMENT, name VARCHAR(50));
- 默认约束 (DEFAULT):未指定该字段值时,自动采用默认值。
- 应用场景:有常用默认值的字段,如状态、创建时间。
- 示例:
CREATE TABLE users (id INT, status CHAR(1) DEFAULT '1');
- 检查约束 (CHECK):确保字段值满足特定条件。MySQL从8.0.16版本开始完整支持。
- 应用场景:需要范围或格式验证的字段,如年龄、价格。
- 示例:
CREATE TABLE users (id INT, age INT CHECK (age >= 0 AND age <= 120));
- 外键约束 (FOREIGN KEY):用于建立两张表之间的连接,维护数据的一致性和完整性。它要求本表字段的值必须存在于另一张表的主键或唯一键中。
- 应用场景:表与表之间的关联,如订单中的用户ID。
- 示例:
CREATE TABLE orders ( order_id INT PRIMARY KEY, customer_id INT, FOREIGN KEY (customer_id) REFERENCES customers(id) ); - 注意:外键约束只有InnoDB存储引擎才支持。
二、约束的两种定义方式
约束可以在创建表或修改表时定义,主要有两种方式:
- 列级约束 (Column Constraint):紧跟在列的定义后面,只能作用于当前这一个列。例如:
name VARCHAR(50) NOT NULL。 - 表级约束 (Table Constraint):在所有列定义之后单独定义,可以作用于一个或多个列。例如:
CONSTRAINT pk_user PRIMARY KEY (id, email)。
注意:
NOT NULL、DEFAULT这类约束通常只能作为列级约束定义。
连表
1. 五大连表类型(核心区别)
假设有两张表:users(用户)和 orders(订单),用户可下多单,也可不下单。
| 类型 | 关键词 | 返回逻辑 | 适用场景 |
|---|---|---|---|
| 内连接 | INNER JOIN | 只返回两表匹配成功的行。用户无订单则不显示。 | 查询“有购买记录的用户”及其订单详情。 |
| 左连接 | LEFT JOIN | 返回左表所有行,右表无匹配则填充 NULL。 | 查询“所有用户”及其订单(没下单的也显示)。 |
| 右连接 | RIGHT JOIN | 返回右表所有行,左表无匹配则填充 NULL。 | 极少数场景,通常可用左连接替代(调换表顺序)。 |
| 全外连接 | MySQL 不支持 FULL JOIN | 返回两表所有行,对方无匹配则补 NULL。 | 需用 LEFT JOIN UNION RIGHT JOIN 模拟。 |
| 笛卡尔积 | CROSS JOIN | 返回两表行数的乘积(M×N),无关联条件。 | 极少用,常用于生成测试数据,需谨慎。 |
2. 连接条件的三种写法(ON / USING / 隐式)
-
ON(最通用):指定任意连接条件,支持不等值(
>、<等)。
示例:SELECT * FROM users u LEFT JOIN orders o ON u.id = o.user_id; -
USING(字段名相同且为等值):自动合并相同列,结果集中该列只出现一次。
示例(前提是两表id含义一致):SELECT * FROM users u LEFT JOIN orders o USING (id); -
隐式连接(不推荐):用
WHERE写关联,易漏条件导致笛卡尔积,可读性差。
示例(等价于INNER JOIN):SELECT * FROM users u, orders o WHERE u.id = o.user_id;
3. 多表连查实战(三表以上)
连表按逻辑顺序执行(先连前两表,再连第三表)。
示例:
SELECT u.name, o.order_no, p.product_name
FROM users u
LEFT JOIN orders o ON u.id = o.user_id
LEFT JOIN order_items oi ON o.id = oi.order_id
LEFT JOIN products p ON oi.product_id = p.id
WHERE u.create_time > '2026-01-01';技巧:将过滤性最强的条件放在最前面的驱动表,可减少中间结果集大小。
4. 性能优化核心(DBA 必看)
连表慢的根本原因:驱动表每扫描一行,都要去被驱动表查找匹配行(Nested Loop)。
| 优化手段 | 具体操作 |
|---|---|
| 建索引(重中之重) | 必须在 被驱动表(通常是 ON 子句中的右表)的关联字段上建索引。例: ALTER TABLE orders ADD INDEX idx_user_id (user_id); |
| 小表驱动大表 | 在 LEFT JOIN 中,左表是驱动表,应尽量是小表。MySQL 优化器也会自动调整,但你可以用 STRAIGHT_JOIN 强制顺序。 |
| 避免 SELECT * | 只取必要字段,减少数据传输和临时表大小。 |
| 利用 EXPLAIN | 执行 EXPLAIN SELECT...,查看 type 列。若出现 ALL(全表扫描)或 Using join buffer,说明缺少索引或内存不足。 |
5. 致命陷阱与避坑指南(面试高频)
陷阱一:LEFT JOIN 中 WHERE 误杀 NULL
错误写法(等价于 INNER JOIN):
SELECT * FROM users u LEFT JOIN orders o ON u.id = o.user_id WHERE o.amount > 100;正确写法(条件应写在 ON 子句中):
SELECT * FROM users u LEFT JOIN orders o ON u.id = o.user_id AND o.amount > 100;陷阱二:连表更新/删除(需小心)
多表更新示例(将 vip 等级为 3 的用户对应的订单状态改为“已发货”):
UPDATE users u INNER JOIN orders o ON u.id = o.user_id
SET o.status = '已发货' WHERE u.vip_level = 3;
陷阱三:重复列名
当使用 USING 或 NATURAL JOIN 时,合并列可能导致无法直接引用表前缀,建议多用 ON 并显式别名。
6. 替代方案:子查询 vs JOIN
-
用 EXISTS 代替 JOIN:当只需要检查“存在性”且只需查主表字段时,
EXISTS通常比DISTINCT JOIN更高效。
示例(查询有下单的用户):SELECT * FROM users u WHERE EXISTS (SELECT 1 FROM orders o WHERE o.user_id = u.id);
总结口诀
左连右连看业务,ON 写关联 WHERE 写过滤。
被驱动表建索引,EXPLAIN 查执行计划。
杜绝笛卡尔积,NULL 值陷阱要当心。
三个日志文件
MySQL 三大核心日志文件详解
MySQL 中常说的“三个日志文件”,指的是 Redo Log(重做日志)、Undo Log(回滚日志)和 Binlog(二进制日志)。它们共同保障了数据库的持久性、原子性和一致性,是 MySQL 稳定运行的核心。
1. 直观比喻
| 日志 | 比喻 |
|---|---|
| Redo Log | 像修订记录,记录每次修改,即使写作软件崩溃也能找回最新内容。 |
| Undo Log | 像撤销草稿,写错了可以随时撤销到之前的状态。 |
| Binlog | 像故事大纲,记录了整个故事的完整发展脉络,用于复盘或续写。 |
2. 详细对比
| 特性 | Redo Log (重做日志) | Undo Log (回滚日志) | Binlog (二进制日志) |
|---|---|---|---|
| 归属层级 | InnoDB 存储引擎层(独有) | InnoDB 存储引擎层(独有) | MySQL Server 层(所有引擎共用) |
| 主要作用 | 保证事务持久性和崩溃恢复 | 保证事务原子性,支持回滚和 MVCC | 主从复制 + 基于时间点的恢复 |
| 记录内容 | 物理日志(如“在页 X 的偏移 Y 处写入值 Z”) | 逻辑日志(修改前的旧值或逆向操作) | 逻辑日志(SQL 语句或行变更) |
| 写入方式 | 循环写入(固定大小,写满后覆盖) | 动态增长,存储在回滚段中 | 追加写入(写满后生成新文件,不覆盖) |
| 写入时机 | 事务执行过程中持续写入,提交时强制刷盘 | 数据修改时实时生成(用于可能的回滚) | 事务提交时写入 |
3. 三大日志如何协同工作?——两阶段提交
通过 两阶段提交(2PC) 机制,确保 Redo Log 和 Binlog 逻辑一致,避免主从不一致或数据丢失。
以一个 UPDATE 事务为例:
- 开始事务:执行
UPDATE语句。 - 生成 Undo Log:记录修改前的旧值,以备回滚。
- 生成 Redo Log(prepare 状态):记录数据页的物理修改。
- 生成 Binlog(内存中):记录逻辑变更。
- 提交事务(关键步骤):
- 将
Binlog写入磁盘(fsync)。 - 将
Redo Log的状态更新为commit并刷盘。 - 事务正式提交。
- 将
崩溃恢复场景
-
若在第 4 步与第 5 步之间宕机:
Redo Log为prepare,但Binlog不完整 → 重启后事务回滚。 -
若
Binlog已完整写入,但Redo Log尚未commit:
重启后事务会被重新提交(依据Binlog完整性),保证主从数据一致。
4. 总结
| 日志 | 核心定位 |
|---|---|
| Redo Log | InnoDB 内部“重做”日志,保证已提交事务不丢失(持久性) |
| Undo Log | InnoDB 内部“撤销”日志,保证未提交事务可回滚(原子性) |
| Binlog | MySQL Server 层“归档”日志,用于复制和恢复(外部功能) |
三者结合,既保证了事务的 ACID 特性,又支撑了高可用架构(主从复制、备份恢复)。
B树和B+树
| 特性 | B 树 | B+ 树 |
|---|---|---|
| 数据存储位置 | 所有节点(内部+叶子)都存完整数据记录 | 只有叶子节点存完整数据,内部节点仅存索引键和子节点指针 |
| 叶子节点结构 | 叶子节点独立,彼此之间没有链接 | 所有叶子节点通过双向链表串联,形成有序序列 |
| 树的高度与磁盘 I/O | 较高(内部节点含数据,出度小,树更瘦高,磁盘 I/O 可能更多) | 较低(内部节点只存键,出度大,树更矮胖,减少磁盘 I/O) |
| 随机点查询效率 | 可能在非叶子节点命中,性能不稳定(最好 O(1),最坏 O(log n)) | 必须走到叶子节点,性能稳定(总是 O(log n),但树矮常数小) |
| 范围查询效率 | 需中序遍历,随机 I/O 多,效率较低 | 定位起点后沿叶子链表顺序扫描,效率极高 |
| 全表扫描 / 排序 | 效率较低,需遍历整棵树 | 直接利用叶子链表顺序扫描,高效且天然有序 |
| 空间利用率 | 较低(数据分散在所有节点) | 较高(内部节点只存键,一个节点能索引更多键,空间更紧凑) |
| 查询性能稳定性 | 不稳定,查询路径长度变化大 | 非常稳定,任何查询都走相同层数到达叶子节点 |
| 适用场景 | 文件系统(NTFS 等)、部分 NoSQL(如 MongoDB)、随机点查询为主的场景 | 关系型数据库主流索引(MySQL InnoDB、PostgreSQL)、大量范围查询 / 排序 / 分组操作的场景 |
索引下推
MySQL5.6引入的重要优化 把原本在 Server 层进行的部分 WHERE 过滤条件下推到存储引擎层,在扫描索引时就提前过滤掉不符合条件的记录,从而大幅减少回表次数。
eg:SELECT * FROM users WHERE name LIKE ‘Tom%’ AND age = 20;
| 对比维度 | 覆盖索引 (Covering Index) | 索引下推 (Index Condition Pushdown) |
|---|---|---|
| 核心目的 | 彻底避免回表 | 尽可能减少回表次数 |
| 解决的问题 | SELECT 的列需要回表才能取到 | WHERE 中的额外过滤条件导致大量不必要的回表 |
| 必要条件 | 查询的所有列(含 WHERE/SELECT/ORDER BY 及主键)都在同一个索引里 | WHERE 中的过滤列是索引列,但查询需要回表取其他列 |
| 是否回表 | ❌ 不,数据直接从索引获得 | ✅ 是,但只对真正符合条件的记录回表 |
| 过滤发生层级 | 不需要过滤,直接取结果 | 存储引擎层在扫描索引时提前过滤 |
| EXPLAIN Extra | Using index | Using index condition |
| 典型场景 | 只查索引里的少量列,如 SELECT name, age FROM t WHERE name='Tom'(有索引 (name,age)) | 需要查索引外的列,且索引内列可过滤,如 SELECT * FROM t WHERE name LIKE 'Tom%' AND age=20(有索引 (name,age)) |
| 可共存吗 | 若已是覆盖索引,则不会出现 ICP,因为根本不用回表 | 若要回表才能取到所有列,ICP 才发挥作用 |
是否每次都要回表
不涉及回表的三种情况: 1.覆盖索引 2.主键查询:InnoDB 的表本身就是一个聚簇索引,主键叶子节点直接存着整行数据。 3.全表扫描
| 查询方式 | 是否回表 | 原因 |
|---|---|---|
| 全表扫描 | ❌ 否 | 直接读聚簇索引数据本身 |
| 主键等值查询 | ❌ 否 | 聚簇索引叶子节点直接包含整行 |
| 二级索引 + 覆盖索引 | ❌ 否 | 索引中已经包含所有需要的列 |
| 二级索引 + 需要索引外列 | ✅ 是 | 必须拿着主键去聚簇索引补全数据 |
分类
一、按功能与约束分类 1.普通索引:最基本的索引类型,没有唯一性之类的限制
2.唯一性索引: 索引列的所有值都只能出现一次,必须唯一 当现有数据库中存在重复的键值时,大多数数据库不允许将新创建的唯一索引与表一起保存,数据库还可能防止添加重复键值将在表中创建重复键值的新数据
3,主键索引 主键是一种唯一性索引,但它必须指定为“PRIMARY KEY” 在数据库中为表定义主键将自动创建主键索引,主键索引是唯一索引的特定类型,要求主键中每个值都唯一
4.全文索引
索引类型为 FULLTEXT
适合在进行模糊查询的时候使用
在 MySQL5.6 版本以前 FULLTEXT 索引仅可用于MyISAM,在5.6之后InnoDB也支持
全文索引可以在 CHAR、VARCHAR 或 TEXT 类型的列上创建
5.组合索引/复合索引/联合索引 可以是单列上创建的索引,也可以是在多列上创建的索引,遵循最左原则 多列索引可以区分其中一列可能有相同值的行 适用于经常同时搜索两列、多列、按两列或多列排序时
6.前缀索引:只索引字符串字段的前几个字符,节省空间。代价是不能用于ORDER BY/GROUP BY,也无法完整覆盖索引。
二、按物理存储方式分类 1.聚簇索引:叶子节点直接存储完整的行数据,主键一定要自增 InnoDB 表本身按聚簇索引组织: 有主键 → 主键就是聚簇索引 无主键但有唯一非空索引 → 第一个唯一非空索引作为聚簇索引 都没有 → InnoDB 自动生成一个隐藏的 6 字节 row_id 作为聚簇索引 无论哪种方式,每张 InnoDB 表有且仅有一个聚簇索引。 数据行按主键的顺序存放,非叶子节点存主键值+指向下层的页号,叶子节点存主键值+该行的所有字段
2.非聚簇索引(二级索引):叶子节点存索引列+对应的主键值。除聚簇索引外的所有索引都是二级索引,一张表可以有多个。 查询过程会涉及回表(覆盖索引回避回表)
三、按底层数据结构分类 1.B+ 树索引:InnoDB、MyISAM 默认使用的索引结构。所有数据都在叶子节点,叶子节点间构成有序双向链表 2.哈希索引:基于哈希表,只能做等值匹配,不支持范围查询 3.全文索引:用于大段文本中的关键词搜索,支持模式匹配、自然语言检索。InnoDB从5.6 开始支持,底层采用倒排索引实现 4.空间索引:用于地理空间数据类型,InnoDB 从 5.7 开始较好支持。
四、特殊索引 1.覆盖索引:一种优化状态。当查询所需的所有列都能从索引中直接获取,不用回表,提高性能 2.降序索引 (MySQL 8.0+):创建索引时可指定列排序 DESC,物理上倒序存储 3.函数索引 (MySQL 8.0.13+):按表达式或函数的结果建立索引,解决对列做函数操作导致索引失效的问题。 4.不可见索引 (MySQL 8.0+):索引存在且维护,但优化器默认忽略它。可用于安全地测试删除某索引的影响。 5.自适应哈希索引:InnoDB特有,当某些 B+ 树页被频繁访问,InnoDB 自动在内存中为它们构建哈希索引,用户无法干预,提高性能。
失效
1.对索引列使用函数或运算:对列进行任何计算、函数包装,都会导致索引失效。 2.隐式类型转换:当查询条件的类型与列类型不匹配时,MySQL会隐式对列做函数转换,从而走不了索引。 3.LIKE 以通配符 % 开头只有前缀匹配能用到索引,% 在最前面时索引失效。 4. where中or连接非索引列:如果or两边的条件中有一个没有索引,整条查询就可能放弃使用索引。 5.违反联合索引的“最左前缀”原则 6.使用 NOT、!=、<>、NOT IN 一般全表扫描 7.IS NULL 通常可以使用索引,IS NOT NULL 在很多情况下不会走索引,尤其当表中大部分行都不为 NULL 时 8.优化器认为全表扫描更快。数据量很小,或者查询返回的行数超过全表的 30% 左右(无绝对数值),即使有索引,优化器也可能选择全表扫描。可以用FORCE INDEX临时强制使用索引来验证。
覆盖索引
覆盖索引:一条 SQL 语句查询的所有列都包含在某个索引树中,不用再回到主键索引(聚簇索引)中去读取完整的数据行。EXPLAIN的Extra中,Using index通常就表示使用了覆盖索引。 虽然 id 不是索引显式定义的列,但二级索引的叶子节点天然包含主键值。因此 id 可以直接从索引中拿到,不需要回表。
覆盖索引的优点 1.大幅减少磁盘 I/O 回表是随机读,很耗时。覆盖索引只需顺序扫描索引树,甚至可以在内存中完成。 2.减少数据访问量 索引通常比整行数据小很多,同样的内存能缓存更多索引页,提高缓存命中率。 3.对分页、统计查询特别友好 比如 SELECT COUNT(*)可以直接扫索引统计,不用读表。 4.避免额外排序 如果索引本身就是按查询列排序的,filesort可以省掉。
回表:当一条查询使用二级索引时,如果需要的列不在这个索引中,数据库就要拿叶子节点里的主键值,再去聚簇索引里查一次完整数据行
不适用索引情况
1.列的选择性太低 2.表的数据量非常小,表只有几百行或几千行时,全表扫描的代价本身就极小 3.频繁进行大批量增删改的列 4.长文本或大对象字段 5.不在查询条件中的列 6.索引已经足够覆盖的列 7.会被频繁用作函数或运算条件的列
创建索引的原则依据: 1.表的主键、外键必须有索引;主键具有唯一性,索引值也是有唯一的,查询时可以快速定位到数据行;外键一般关联的是另一个表的主键,所以在多表查询时也可以快速定位 记录数超过300行的表应该有索引;如果没有索引,需要把表遍历一遍,会严重影响数据库的性能 2.经常与其他表进行连接的表,在连接字段上应该建立索引 3.唯一性太差的字段不适合建立索引,并不能提升查询速度,反而会变慢 4.更新太频繁地字段不适合创建索引;在表中进行增、删、改、查时,索引也会有响应操作产生;字段更新的过于频繁,会导致对于系统资源的过多占用 5.经常出现在 where 子句中的字段,特别是大表的字段,应该建立索引 6.索引应该建在选择性高的字段上,选择性低代表字段重复值少,可以全表扫描 选择性=该字段不同值的个数/表的总行数 >0.1高,应该建索引 0.01-0.1中,看情况可以建 <0.01低,不建议建 7.索引应该建在小字段上,对于大的文本字段甚至超长字段,不要建索引
死锁
死锁指多个事务相互等待对方释放锁,形成循环等待。 例如: 事务 A 持有记录 1,等待记录 2 事务 B 持有记录 2,等待记录 1 MySQL 检测到死锁后,通常会回滚其中一个事务,让另一个事务继续执行。
死锁的排查:
- SHOW ENGINE INNODB STATUS:用于快速查看最近一次死锁的原因。 2.开启 innodb_print_all_deadlocks:用于记录所有死锁,方便进行系统性分析。 3.使用 sys.innodb_lock_waits:用于实时排查当前的锁阻塞问题
常见预防方法: 多个事务按相同顺序访问数据; 尽量缩短事务时间; 合理建立索引,减少锁定范围; 避免大范围更新; 应用层捕获死锁异常并进行重试。
分类
-
按锁的粒度分类 从影响范围由大到小: 全局锁:锁住整个数据库实例,常用于全库备份。加锁期间通常不能进行写操作。 表级锁:锁住整张表,开销小、加锁快,但并发度较低。 页级锁:锁住数据页,粒度介于表锁和行锁之间。 行级锁:只锁定相关记录,并发度高,但加锁和维护成本更高。 记录锁(Record Lock):锁住索引上的某一条记录,防止其他事务修改或删除该记录。 间隙锁(Gap Lock):锁住索引记录之间的间隙,防止其他事务插入数据,主要用于防止幻读。 临键锁(Next-Key Lock):记录锁 + 间隙锁,锁住某条记录及其前面的间隙,是 InnoDB 在 RR 隔离级别下的常见锁形式。
-
按锁的类型分类 共享锁(S 锁、读锁):多个事务可以同时持有并读取同一数据,但不能修改。 SELECT * FROM user WHERE id = 1 LOCK IN SHARE MODE;
排他锁(X 锁、写锁):事务获得排他锁后,其他事务不能再读取加锁数据,也不能修改。 SELECT * FROM user WHERE id = 1 FOR UPDATE; 实际使用中,UPDATE、DELETE 通常会自动加排他锁。
- 意向锁
意向锁是表级锁,用来表示事务准备给表中的某些行加锁,方便数据库快速判断表上是否存在行锁。 意向共享锁(IS):事务准备给某些行加共享锁。 意向排他锁(IX):事务准备给某些行加排他锁。 意向锁不是用来直接保护业务数据的,主要用于协调表锁和行锁之间的冲突。
-
自增锁 AUTO-INC 锁用于控制自增列生成过程,保证并发插入时自增值能够正确分配,避免生成重复的自增主键。
-
死锁 死锁指多个事务相互等待对方释放锁,形成循环等待。
隔离级别
SQL 标准定义了四种事务隔离级别。InnoDB 引擎全部支持,默认级别是 REPEATABLE READ(可重复读)。
1 READ UNCOMMITTED(读未提交)
规则: 一个事务可以读取到其他未提交事务的修改。
| 问题 | 是否会发生 |
|---|---|
| 脏读 | ✅ 发生 |
| 不可重复读 | ✅ 发生 |
| 幻读 | ✅ 发生 |
| 实现方式: 几乎不加锁,直接读取最新数据,不使用 MVCC 的快照。 |
适用场景: 极少使用。仅在对数据一致性要求极低的场景(如粗略计数器、日志统计)中可以考虑。
关键理解:
- 由于其他事务随时可能回滚,读取到的未提交数据可能是”脏”的(从未真正存在过)。
- 生产环境中几乎不使用此级别。
2 READ COMMITTED(读已提交)
规则: 一个事务只能读取到其他事务已提交的修改。
| 问题 | 是否会发生 |
|---|---|
| 脏读 | ❌ 防止 |
| 不可重复读 | ✅ 发生 |
| 幻读 | ✅ 发生 |
实现方式: 每次执行普通的 SELECT 语句时,都会生成一个新的 ReadView。因此每次读取都能看到最新的已提交数据。
特点:
- 每次读取都获得当前最新快照,所以在同一个事务中多次执行同样的 SELECT 可能得到不同结果(不可重复读)。
- 这是 Oracle 数据库的默认隔离级别。
- 在 MySQL 的 READ COMMITTED 下,语句级别的 binlog 格式必须是 ROW 格式,否则会导致主从数据不一致。
适用场景: 适合大多数互联网应用,在并发性能和数据一致性之间取得较好的平衡。
3 REPEATABLE READ(可重复读)
规则: 同一个事务中的多次读取结果完全一致,不受其他事务提交的影响。
| 问题 | 是否会发生 |
|---|---|
| 脏读 | ❌ 防止 |
| 不可重复读 | ❌ 防止 |
| 幻读 | ⚠️ 大部分场景防止 |
实现方式: 在事务第一次执行普通 SELECT 时生成一个 ReadView,整个事务期间复用该 ReadView。配合 Next-Key Lock(临键锁)在很大程度上防止幻读。
关键理解——关于幻读:
- InnoDB 的 REPEATABLE READ 通过 MVCC + 间隙锁(Gap Lock)/ 临键锁(Next-Key Lock) 在很大程度上解决了幻读问题。
- 快照读(普通 SELECT)层面:由于 ReadView 在事务开始时就确定,同一事务中的多次快照读不会出现幻行。
- 当前读(SELECT … FOR UPDATE / UPDATE / INSERT 等)层面:通过 Next-Key Lock 锁定索引范围,阻止其他事务在这个范围内插入新行。
- 但是, 如果事务 A 先快照读,然后事务 B 插入新行并提交,事务 A 再执行 UPDATE 操作——此时 UPDATE 属于当前读,会更新到事务 B 插入的行。更新完成后,事务 A 再次快照读会看到更新的行。这属于”幻读的变体”,但在实际中较少见且影响有限。
- 完全杜绝幻读的唯一方式是使用 SERIALIZABLE 隔离级别。
MySQL 选用 REPEATABLE READ 作为默认级别的原因:
- 在 MySQL 5.0 之前,binlog 只支持 STATEMENT 格式。要保证主从复制的一致性,REPEATABLE READ 是最低要求。
- 虽然现在推荐使用 ROW 格式的 binlog,但历史沿革使 REPEATABLE READ 保留为默认。
4 SERIALIZABLE(串行化)
规则: 所有事务按串行顺序执行,每个事务执行时看不到其他事务的并发操作。
| 问题 | 是否会发生 |
|---|---|
| 脏读 | ❌ 防止 |
| 不可重复读 | ❌ 防止 |
| 幻读 | ❌ 防止 |
实现方式: 所有普通 SELECT 被隐式转换为 SELECT ... FOR SHARE(即加共享锁),从而阻塞其他事务的写操作,不会阻塞读操作
特点:
- 这是最高的隔离级别,完全避免并发问题。
- 并发性能极低,容易导致大量的锁等待和超时。
- 生产环境中极少使用,仅在对数据一致性要求极度严苛的场景中考虑。
传播级别
事务传播行为(Propagation)定义了当一个事务方法被另一个事务方法调用时,应该如何处理事务边界。这个概念虽然在 JDBC 层面不直接出现,但在 Spring 框架的声明式事务中被完整定义。理解传播行为对正确使用分布式/嵌套事务至关重要。
6.1 七种传播行为详解
PROPAGATION_REQUIRED(默认)
规则:
- 如果当前存在事务,则加入该事务。
- 如果当前没有事务,则创建一个新事务。
核心理解: 这是最常用的传播行为。它确保所有操作在同一个事务上下文中执行——要么一起提交,要么一起回滚。外部调用者开启的事务成为所有内部调用的容器。
常见场景:增删改
PROPAGATION_REQUIRES_NEW
规则:
- 总是创建一个新的事务。
- 如果当前存在事务,则将当前事务挂起。
关键理解:
- 新事务和外层事务彼此完全独立。外层事务的回滚不影响内层新事务(内层新事务已提交),内层新事务的回滚也不影响外层事务。
- 常用于需要将某些操作独立于外部事务提交的场景(如记录审计日志:即使业务操作回滚,审计日志也要保留)。
注意: 挂起外层事务意味着外层事务持有的数据库连接被释放,新事务需要获取新的数据库连接。在连接池中,这可能导致两个事务使用不同的连接。
PROPAGATION_NESTED(嵌套事务)
规则:
- 如果当前存在事务,则在该事务的嵌套(子)事务中执行。
- 如果当前没有事务,则创建一个新事务(行为和 REQUIRED 一样)。
关键理解:
- 嵌套事务是外层事务的”子事务”。子事务可以独立回滚(回到子事务开始前的状态),而不影响外层事务。
- 但是,外层事务回滚时,所有子事务也一定会回滚。
- 子事务的提交与否最终由外层事务决定:子事务的提交只是标记了一个保存点,只有外层事务提交时所有修改才一起持久化。
与 REQUIRES_NEW 的关键区别:
- REQUIRES_NEW 的内层和外层事务完全独立。
- NESTED 的内层事务依赖于外层事务,外层回滚 = 内层也回滚。
- NESTED 通过数据库的 SAVEPOINT(保存点) 机制实现。仅 JDBC 支持 Savepoint 的数据库驱动能使用(如 MySQL 的 InnoDB)。
PROPAGATION_SUPPORTS
规则:
- 如果当前存在事务,则加入该事务。
- 如果当前没有事务,则以非事务方式执行(不开启事务)。
适用场景: 一个方法对事务不敏感——有事务更好,没有也能正常执行。例如单纯的查询方法,放在事务/非事务上下文都能工作。
PROPAGATION_NOT_SUPPORTED
规则:
- 总是以非事务方式执行。
- 如果当前存在事务,将当前事务挂起。
适用场景: 某些操作必须在事务之外执行(例如执行 DDL 语句,因为 MySQL 的 DDL 会隐式提交事务)。
PROPAGATION_NEVER
规则:
- 始终以非事务方式执行。
- 如果当前存在事务,则抛出异常。
适用场景: 严格禁止在事务上下文中执行的操作(如某些批次处理不希望有事务开销)。
PROPAGATION_MANDATORY
规则:
- 必须当前存在事务,否则抛出异常。
适用场景: 强制要求调用者必须提供事务上下文(如核心业务更新方法被设计为必须在更大事务的上下文中调用)。
当前读和快照读
5.1 快照读(Snapshot Read / 一致性非锁定读)
定义: 基于 MVCC 读取数据的历史快照版本,读取时不需要加锁。
触发语句: 普通的 SELECT 语句。
数据来源: 从 Undo Log 的版本链中读取满足 ReadView 可见性条件的版本,而不是当前最新的数据。
特点:
- 读操作不会被写操作阻塞。
- 写操作也不会被快照读阻塞。
- 读取的可能是”旧”数据(符合隔离级别语义的恰当版本)。
- 这是 InnoDB 默认的 SELECT 行为。
5.2 当前读(Current Read / 一致性锁定读)
定义: 读取数据的最新已提交版本,并且在读取时对数据行加锁,阻止其他事务修改。
触发语句:
SELECT ... FOR UPDATE:对读取的行加排他锁(X 锁)。SELECT ... FOR SHARE:对读取的行加共享锁(S 锁)。INSERT、UPDATE、DELETE:这些操作本身就是当前读。它们在修改数据前,会先以当前读方式定位目标行并加锁。
数据来源: 数据行最新版本(已提交的),不是快照版本。
特点:
- 保证读取到最新数据。
- 会阻塞其他需要写锁的事务(有锁冲突时)。
- 在 REPEATABLE READ 下,
SELECT ... FOR UPDATE还会加间隙锁(Gap Lock),防止幻读。
5.3 快照读与当前读的对比
| 维度 | 快照读 | 当前读 |
|---|---|---|
| 实现机制 | MVCC + Undo Log + ReadView | 行锁 / 表锁 |
| 读取内容 | 符合 ReadView 可见性的历史版本 | 最新已提交版本 |
| 是否加锁 | 不加锁 | 加 S 锁或 X 锁 |
| 阻塞关系 | 读不阻塞写,写不阻塞读 | 读写互斥 (S-S 兼容) |
| 隔离保证 | ReadView 生成时机决定 | 锁机制 + 隔离级别决定 |
| 典型语句 | 普通 SELECT | SELECT FOR UPDATE / DML 操作 |
锁升级
-
锁粒度升级 指锁的范围变大,例如: 行锁 -> 页锁 -> 表锁 -> 全局锁 这样做可以减少锁对象数量和锁管理开销,但会降低并发能力。 不过在 MySQL InnoDB 中,一般不会因为锁住的行太多,就自动把行锁升级成表锁。即使执行大量更新,通常仍然是锁住大量索引记录,而不是直接升级为表锁。 但以下情况可能让人感觉像“锁升级”: 更新条件没有合适索引,导致扫描和锁定大量记录; 锁定范围过大,例如范围查询配合 FOR UPDATE; 使用 LOCK TABLES 主动加表锁; 执行 DDL 时产生 MDL 锁,阻塞整张表的相关操作; 非 InnoDB 存储引擎本身只支持表级锁。
-
锁类型升级或锁转换 指同一事务持有的锁类型发生变化,例如: 共享锁 S -> 排他锁 X 事务先读取数据并持有共享锁,之后又想修改该数据,就需要升级为排他锁。 如果多个事务都持有共享锁,同时尝试升级为排他锁,就可能互相等待,甚至产生死锁。因此业务中常用: SELECT * FROM user WHERE id = 1 FOR UPDATE; 一开始就获取排他锁,避免后续再从共享锁升级。
深度分页如何优化
LIMIT 100000, 10 —— 偏移量巨大,MySQL需要扫描并丢弃前10万行,只取最后10条,越往后越慢。
深分页为什么慢(三个原因) 1.扫描行数多:先扫10万行再丢9万9,无效IO大 2.回表次数多:二级索引查到主键后再回表取数据,磁盘随机IO 3.排序开销大:ORDER BY配合大偏移量,排序本身耗资源
优化方案: 1.游标传值:记住上一页最后一条的ID 2.覆盖索引:索引里包含所有查询字段,不回表 3.延迟关联:先走索引查主键ID,再用ID回表取完整数据 4.子查询优化:先查ID范围,再关联取数据 5.限制翻页深度:业务上禁止跳到100页以后 6.数据预加载:把历史数据缓存到Redis/ES
雪花算法图解
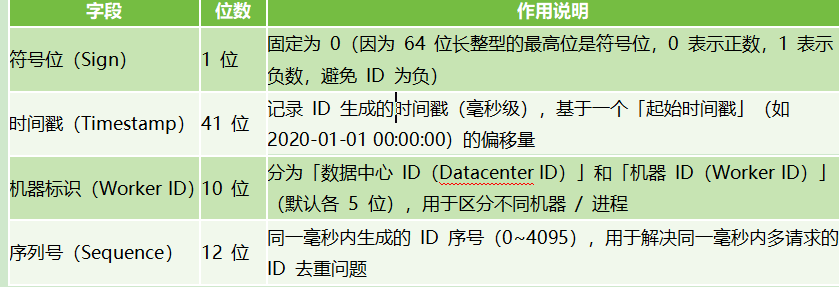
记录、间隙、临键案例
CREATE TABLE t_user (
id INT PRIMARY KEY,
age INT,
KEY idx_age (age) — 普通索引
);
INSERT INTO t_user VALUES (1, 10), (3, 20), (5, 30), (7, 40);
数据按索引排列后,逻辑间隙如下:(-∞, 10), 10, (10, 20), 20, (20, 30), 30, (30, 40), 40, (40, +∞)。
记录锁(Record Lock):锁住索引记录本身。比如锁住 age=20 这一行。 update t_user set age =50 where age = 10
间隙锁(Gap Lock):锁住索引记录之间的间隙,不锁记录。比如锁住 (20, 30) 这个区间,防止其他事务插入 age=25。
select * from t_user
where age = 25 //因为25不存在 所以锁的是间隙 (20, 30)这是加锁的
for update
insert into t_user value(2,20) 这个会成功 20 是已有的记录 锁的是间隙 不是20本身
insert into t_user value(4,29) 这个不会成功 29是20到30之内仍然有间隙锁
insert into t_user value(6,30) 成功 30不在间隙之内所以会添加成功
临键锁(Next-Key Lock):记录锁 + 间隙锁,锁住左开右闭的区间,比如 (20, 30]。 InnoDB 默认在 RR(可重复读)级别下使用临键锁,目的是解决幻读。而 RC(读已提交)级别只使用记录锁,间隙锁会被禁用。
自由主题
spring
boot
mvc
mybatis
IOC/DI
IOC :控制反转,由自己new对象改成容器创建对象 DI: 依赖注入
1.set注入 @Component public class UserService { private UserDao userDao;
@Autowired
public void setUserDao(UserDao userDao) {
    this.userDao = userDao;
}
}
2.构造方法注入(主流推荐) @Component public class UserService { private final UserDao userDao;
// 构造器注入 (在Spring 4.3+,如果类只有一个构造器,可省略 @Autowired)
@Autowired
public UserService(UserDao userDao) {
    this.userDao = userDao;
}
}
3.字段注入(最不推荐,生产中不让使用) @Component public class UserService { @Autowired private UserDao userDao; // 直接注入 }
AOP
AOP:面向切面编程 底层是动态代理实现 使用场景:事务/日志/安全/性能监控/异常处理/缓存
aop中的概念: 1.aspect: 切面,表示按方法调用时间做为切点,增加功能(日志,事务,权限检查) 2.pointcut: 切入点,执行位置 3.advice:通知,也就增强,时间节点
常用注解
Spring: 1.创建对象的 @Controller @Service @Component @Repository 2.配置类 @Configuration @Bean 3.赋值的 @Value @Autowired + @Qualifier = @Resource 4.扫描组件 @ComponentScan 5.指定bean作用域 @Scope(singleton/prototype/request/session) @Lazy @Primary 优先使用的bean
MVC:
1.返回json
@RestController
2.请求方式
@RequestMapping/@GetMapping/@PostMapping…
3.路径变量 /{id}/{name}
@PathVariable
4.请求参数 ?key=value
@RequestParam
5.请求体是json -> java对象
@RequestBody
6.响应体json
@ResponseBody
7.将HTTP请求头中的值绑定到方法的参数上
@RequestHeader
从请求域/session/cookie域获取属性值
@RequestAttribute @SessionAttribute
@CookieValue
8.跨域请求
@CrossOrigin
异步调度注解 @Scheduled @EnableScheduling @Async @EnableAsync
Spring Boot 的核心注解 1.@SpringBootApplication:该注解是 Spring Boot 应用的入口注解 2.@ConditionalOnClass 当指定的类存在于类路径时,才会加载该配置。 3.@ConditionalOnMissingBean 当容器中不存在指定的 Bean 时,才会加载该配置。
5个@Aspect
切面执行时间: 1.@Before: 前置通知 2.@AfterReturning 3.@Around 4.@AfterThrowing 5.@After
定义切入点 @Pointcut(“execution( 访问修饰符 返回值类型 包名.类名.方法名(参数类型) 方法抛出的异常)“
动态代理
1.jdk动态代理 jdk包中的类来实现代理对象Proxy 要求代理类和被代理类必须实现相同的接口 缺点:代理类要先找到被代理类的接口,如果没有父接口那就只能使用cglib代理
2.cglib动态代理 第三方工具库,Enhancer类来实现代理对象 目标被代理类必须是非final的,因为代理类要继承被代理类
请求方式
1.Controller接受参数 url?age=20 -> (int age) 参数名一样 (HttpServletRequest req) url?name=zs&age=20 -> (Student stu) 参数名和对象属性名要对应上
请求体{json} (@RequestBody Student stu)
2.Controller返回值是什么 返回页面 String, ModelAndView,ModelMap
json对象 @ResponseBody @RestController
CORS
CORS跨域响应 协议://主机:端口/上下文 有一个不同就算跨域 1.配置类 实现接口 WebMvcConfigurer Access-Control-Allow-Origin: 指定源 Access-Control-Allow-Credentials:是否允许携带cookie Access-Control-Allow-Methods:允许的请求方法 Access-Control-Allow-Headers:允许的请求头
2.在Controller上添加@CrossOrigin
3.过滤器实现放行
4.mvc:cors配置文件上配置
过滤器和拦截器
监听器:监听三个作用域的生命周期和属性的application,request,session
过滤器:属于servlet,拦截所有web,不能修改请求和响应,用于跨域,字符编码,日志,处理缓存,无法获取IOC容器的bean
拦截器: 属于spring mvc,拦截controller,可以修改请求和响应,登录条件,权限审计
工作原理/核心组件
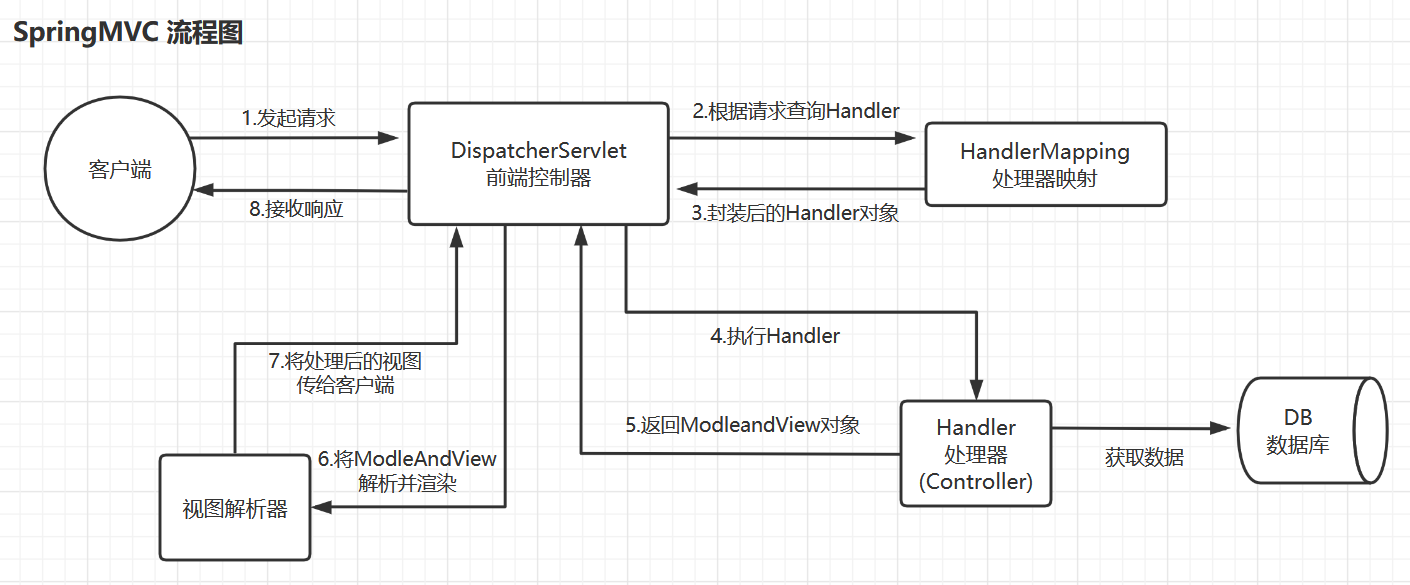
工作原理
核心原理: 1.约定优于配置:默认配置,自己配就加载自己的 2.自动配置:Auto-Configuration 3.起步依赖:starter 4.嵌入式服务器:默认集成了嵌入式服务器(Tomcat、Jetty、Undertow)
Spring Boot 的启动流程 1.加载 SpringApplication 2.加载配置文件 3.创建应用上下文 4.执行自动配置 5.启动嵌入式服务器 6.发布应用启动事件
自动装配
Spring Boot 启动时, 1.@SpringBootApplication 触发了 @EnableAutoConfiguration 2.通过 AutoConfigurationImportSelector 加载 META-INF/spring.factoties 下所有自动配置类 3.并依据 @Conditional 系列条件注解(如类路径是否存在、Bean 是否缺失、属性值是否匹配)进行层层过滤筛选,最终将满足条件的配置类中定义的 Bean 动态注册到 IoC 容器,从而完成装配。
https://www.processon.com/mindmap/6331ac6d6f7c541a94ad4ca4
三级缓存
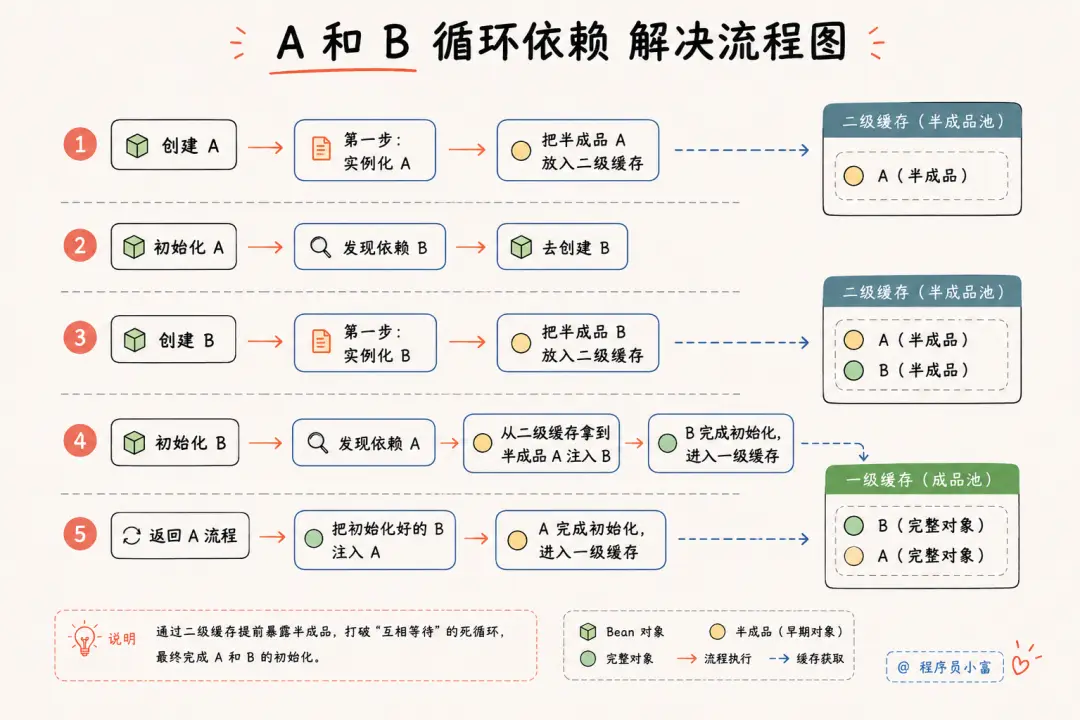
总结一句话:一级放成品,二级放救急用的半成品,三级放“造半成品的工具”,等到真要救急(循环依赖)时才用工具现造一个半成品给队友用,既解决死锁又不浪费性能。
| 缓存级别 | 容器名称 | 存储内容 |
|---|---|---|
| 一级缓存 | singletonObjects | 完全初始化好的单例 Bean(成品) |
| 二级缓存 | earlySingletonObjects | 尚未完成属性填充的早期 Bean 引用(半成品) |
| 三级缓存 | singletonFactories | 生成早期 Bean 的工厂(ObjectFactory),通常用于生成代理对象 |
常用启动器
一、Web应用开发 1.spring-boot-starter-web
二、数据访问与持久化 1.spring-boot-starter-jdbc
2.spring-boot-starter-data-redis
3.spring-boot-starter-data-mongodb
4.spring-boot-starter-data-elasticsearch
三、安全与监控 1.spring-boot-starter-security
2.spring-boot-starter-actuator: 提供生产级监控端点,如 /health、/metrics、/info 等,对应用进行健康检查、性能指标收集和运行时监控
四、消息队列与集成 1.spring-boot-starter-amqp
五、 测试与开发工具 1.spring-boot-starter-test
2.spring-boot-starter-aop
3.spring-boot-starter-cache
核心组件
1.Spring Context 上下文 2.Spring Core 核心 3.Spring AOP 切面 4.Spring DAO 事务/jdbc 5.Spring ORM mybatis/JPA 6.Spring Web 服务器,Web应用上下文 7.Spring Web MVC 网络三层架构
事务
事务在@Service层上 @Transactional() isolation=“隔离级别” propagation=“传播级别” readonly=“只读” rollbackFor=“指定能够触发事务回滚的异常类型” rollbackForClassName=“异常类名回滚”
默认@Transactional只在遇到运行时异常和Error时才会回滚。 运行时异常 RuntimeException:下面的异常不报红线(经常发生) 1/0 非运行时异常 !RuntimeException: 文件读写,SQL
异常处理
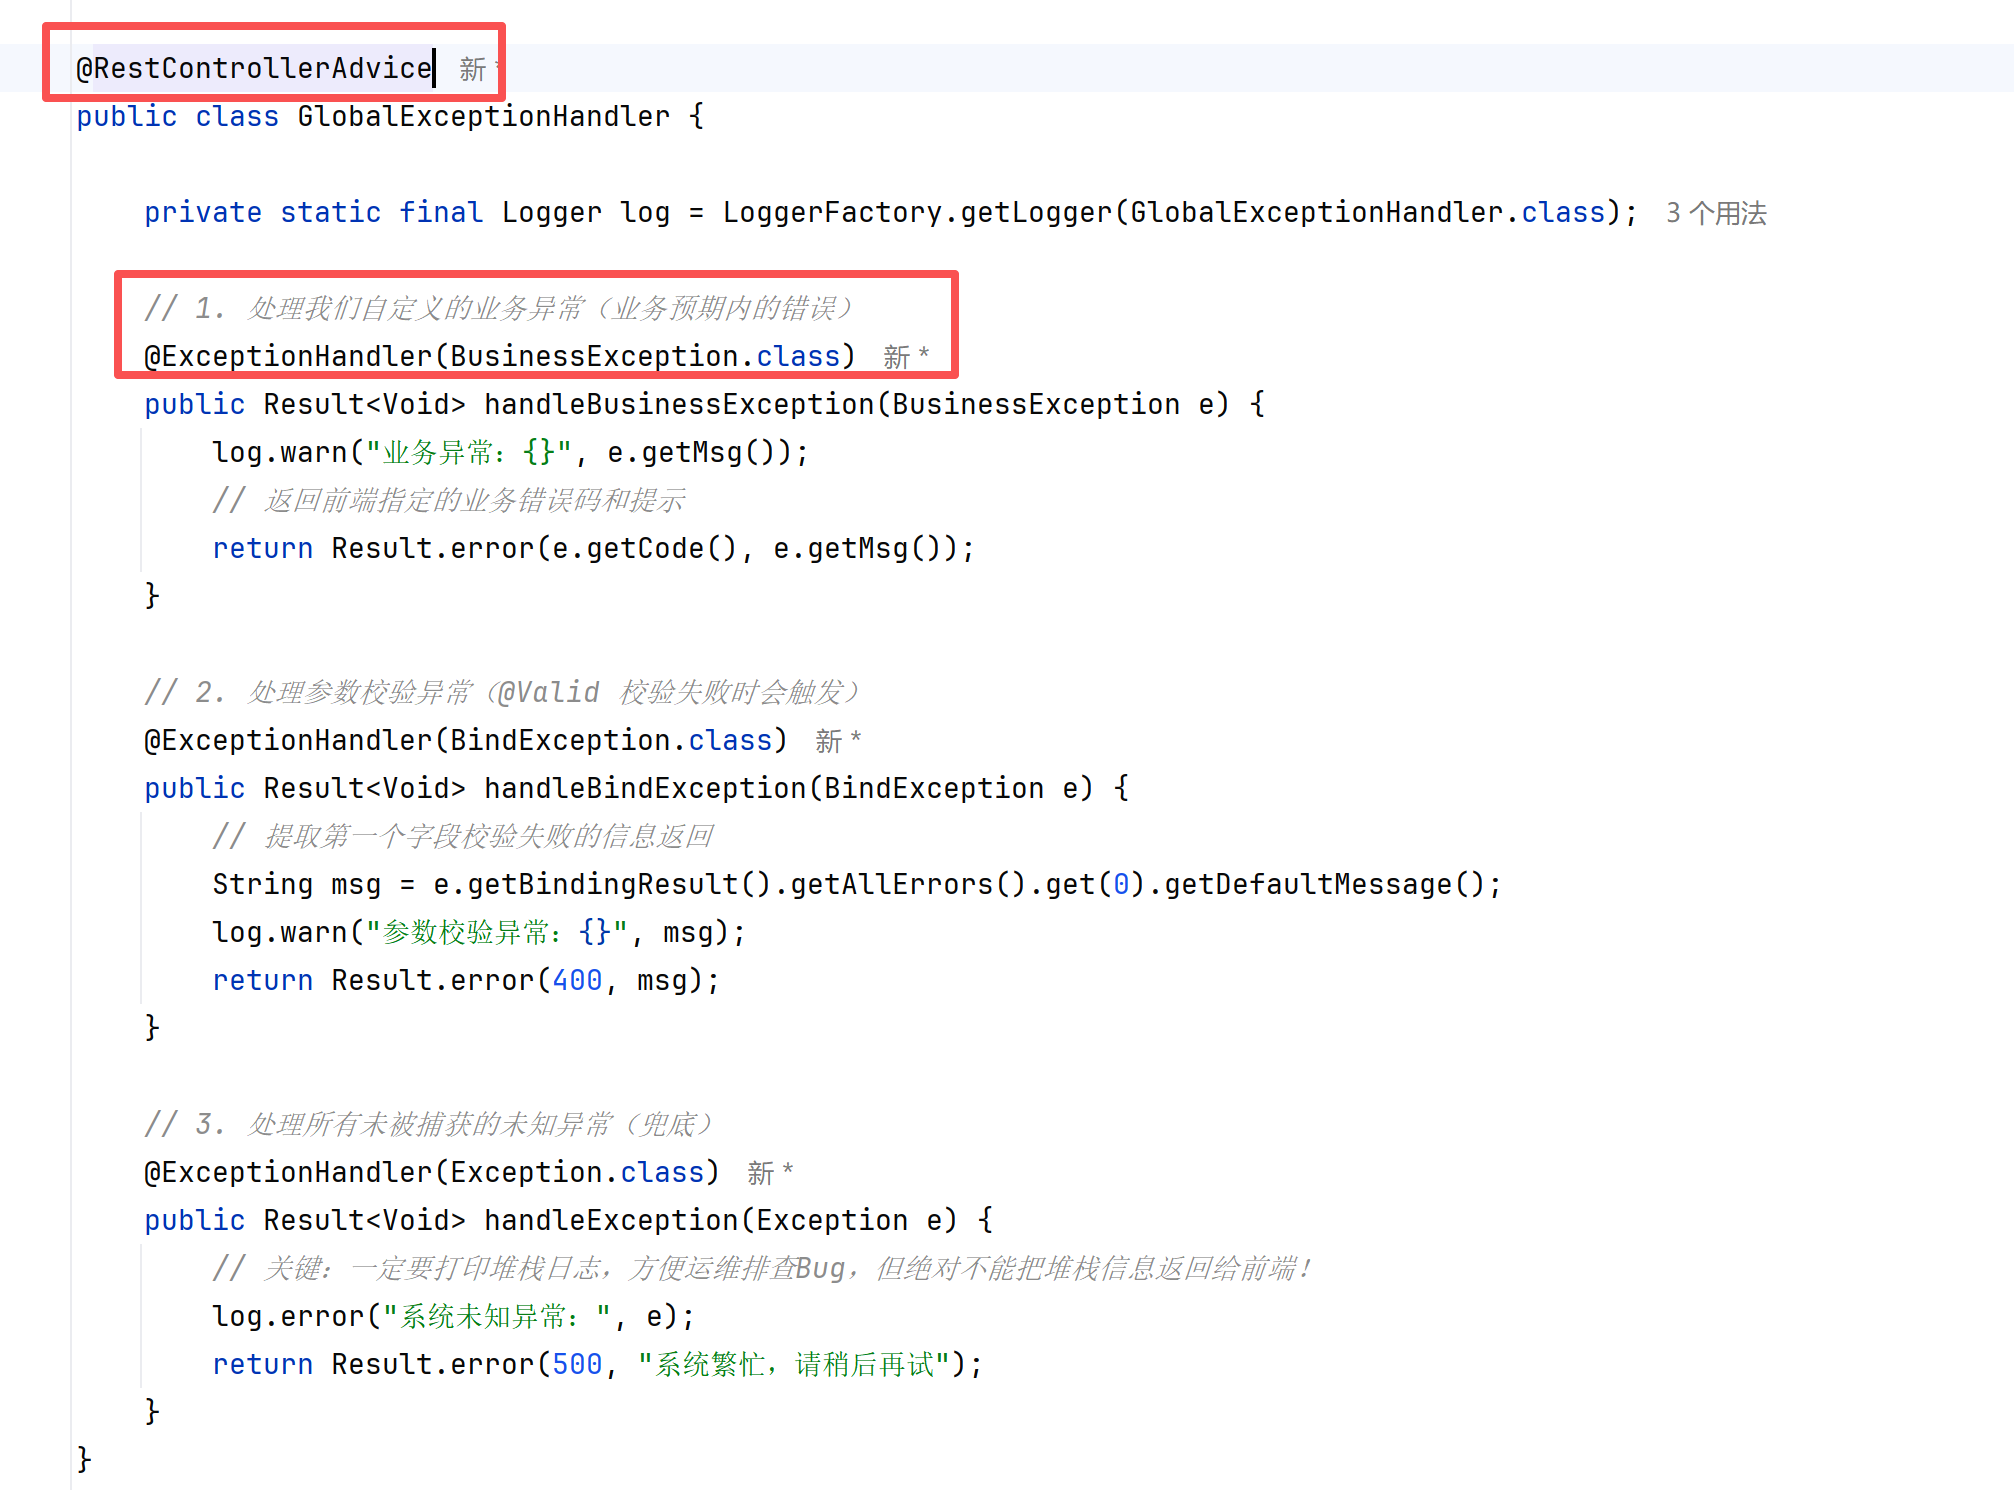
AI
二级缓存
MyBatis缓存
- 缓存好处: 提高响应速度, 减少查询次数
- 缓存缺点: 容易造成数据的不一致 , 容易造成一定的内存压力
1. 一级缓存
1) 默认开启
2) 以SqlSession为标识
3) 单体项目MyBatis常用缓存
4) 一级缓存的失效情况
    sqlSession.commit();// sqlSession.commit() 会将一级缓存的数据 转移 到二级缓存中
    sqlSession.clearCache(); // 手动清除一级缓存
    jobMapper.updateByJid(new Job(2,"qwer","asdfasdf"));  // 中间发生了修改行为
    手动关闭一级缓存 <setting name="localCacheScope" value="STATEMENT"/>
2. 二级缓存
1) 默认关闭
2) 以nameSpace为标识
3) 分布式集群中MyBatis常用缓存
4) 如何开启
    二级缓存全局开关         <setting name="cacheEnabled" value="true"/>
    namespace下的次级开关   <cache/>
    语句上开启最后的缓存开关  useCache="true"
3. 第三方二级缓存
1) 将二级缓存通过第三方技术进行存储 如 Redis4. 缓存的存储顺序
先存入一级, 通过SqlSession提交到二级5. 缓存的查找顺序
先从二级中找, 找不到,再回到自己的一级中找动态SQL
MyBatis 动态 SQL 标签说明
-
<where>标签- 自动补充
WHERE关键字 - 干掉开头第一个多余的
and/or关键字
- 自动补充
-
<if>标签
test属性值如果为true,则补充标签中间的 SQL 片段,多个if之间是独立的判断 -
<choose>标签<when>:test属性值如果为true,则补充标签中间的 SQL 片段,多个when条件选其一执行
-
<sql>标签
定义公共的 SQL 片段,哪里需要该片段,就在哪里<include> -
<set>标签- 自动补充
SET关键字 - 干掉开头和结尾多余的
,
- 自动补充
-
<trim>标签prefix指定要增加的开头prefixoverride干掉指定的开头suffix指定要增加的结尾suffixoverride干掉指定的结尾
-
<foreach>标签
迭代数组、set、list、Mapcollection=""要迭代的集合的名字item=""定义临时变量名index=""用于存储索引的变量名(Map 集合 key 的临时变量名)open=""以指定的字符开头separator=""以指定的字符作为分隔符close=""以指定的字符结尾
-
<bind>标签
内部按照模板拼接字符串的标签
一对一/一对多
一对一查询时使用的标签 [əˌsoʊsiˈeɪʃn]
<association>— 给关联的一个 pojo 属性赋值的标签property="department"— 指定要赋值的属性名javaType="com.yuma.pojo.Department"— 指定要赋值的属性的数据类型select="com.yuma.mapper.DepartmentMapper.getDepartmentByDid"— 要调用的 SQLcolumn="did"— 调用另外的 SQL 时,使用当前结果集中的哪个列作为 SQL 的参数fetchType="lazy"— 是否延迟加载(eager积极加载,lazy延迟加载)
一对多使用的标签
<collection>— 给关联的一个List<Pojo>集合属性赋值的标签property="employees"— 属性名ofType="com.yuma.pojo.Employee"— 集合内的每个元素的数据类型select="com.yuma.mapper.EmployeeMapper.getEmployeesByDid"— 要调用的 SQL 语句column="did"— 调用 SQL 语句时,使用当前结果集的哪个列作为实参fetchType="lazy"— 延迟加载
执行器
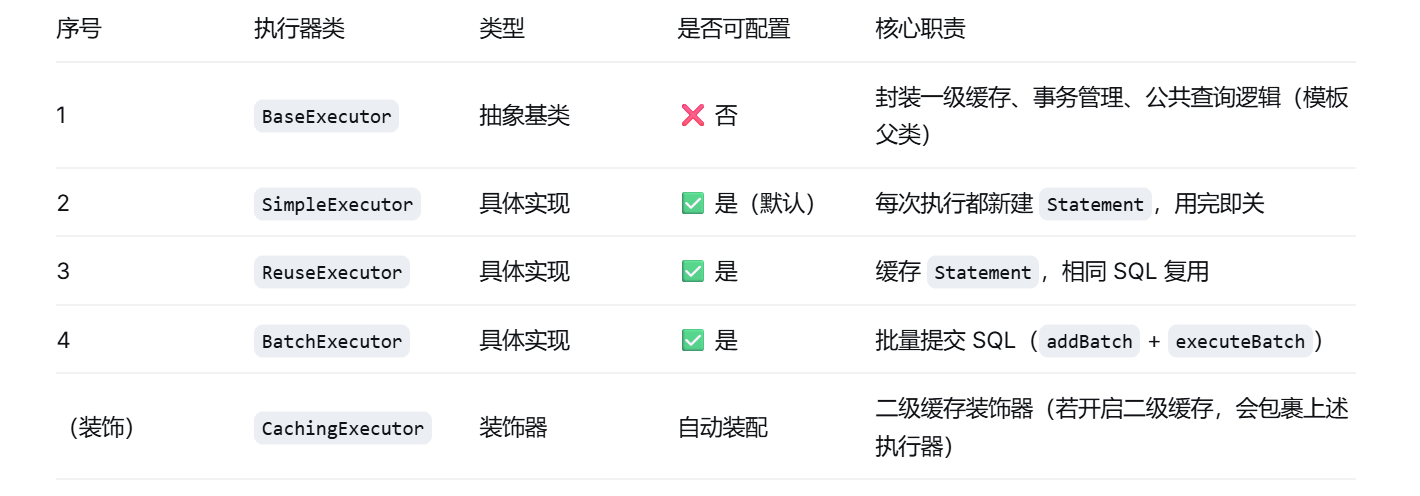
#和$区别
-
${} 底层使用的Statement 普通语句对象,参数是以字符串拼接的方式放入SQL语句 容易出现SQL注入攻击
-
#{} 底层使用的PreparedStatement 预编译语句对象,参数以?作为占位符形式入参 避免注入攻击
表名、列名、排序关键字是变量时,必须用${},后端需用硬编码及进行格式校验,除此之外,都用#{}
三层架构
MVC: Model: 模型层,数据库,entity,dao View: 视图层, vue,jsp前端页面 Controller: 控制层, Controller
V->C->M->C->V
nacos
seata
gateway
https://www.processon.com/view/62885d896376893bcc0ccce8
核心作用:
- 请求路由:统一入口,转发到对应微服务
- 负载均衡:结合注册中心(Nacos/Eureka)自动负载均衡
- 统一鉴权:登录、权限判断在网关统一处理
- 限流熔断:结合 Sentinel 或内置过滤器做限流、降级
- 日志、跨域、请求响应修改:统一处理请求头、响应头、日志等
Gateway 三大核心概念
Route(路由) 网关的基本转发单元 组成:id + 目标 uri + 断言 + 过滤器 作用:根据规则把请求转发到对应微服务 Predicate(断言) 匹配条件 判断请求是否符合路由规则 比如:Path、Method、Header、Query、Host 等 只有断言为 true,路由才会生效 Filter(过滤器) 请求 / 响应的增强与修改 分为:GlobalFilter、GatewayFilter 作用:鉴权、限流、加请求头、修改响应、日志等
Gateway几种过滤器
- 全局过滤器
- 局部过滤器
- 默认过滤器
- 自定义过滤器
Gateway 执行流程
- 客户端请求 → 到达 Gateway
- HandlerMapping 匹配路由
- 找到对应的 WebHandler
- 组装过滤器链 5.执行前置过滤器(Pre 过滤器) 6.转发请求到微服务 7.执行后置过滤器(Post 过滤器) 8.返回结果给客户端
Spring Cloud Gateway 底层基于 WebFlux 和 Netty,是典型的异步非阻塞模型。如果现在有位开发人员在自定义的 GlobalFilter 中,不小心写了一段传统的同步阻塞代码(例如:调用了 Thread.sleep(5000),或者使用同步阻塞的 HttpClient 去调外网接口,又或者调用了 MyBatis 查数据库),网关会发生什么现象?底层原理是什么?如何彻底解决或防御这种问题?
原理:WebFlux 底层依赖少量的事件循环线程(Netty 的 EventLoop,通常等于CPU核数)。如果这些宝贵的线程被阻塞,它们就无法去处理其他请求的 I/O 读写,导致 Netty Backpressure 失效,队列积压。 解决: 必须使用异步非阻塞的客户端(如 WebClient)。如果非要引入阻塞代码(如老项目复用),必须将这些操作丢到专用的阻塞线程池中(如 Schedulers.boundedElastic()),绝不能污染 EventLoop 线程。
生产环境中,微服务实例频繁上下线,或者我们需要在发版时做灰度发布(比如 10% 的流量打到 v2 版本)。请问如何实现 Gateway 的动态路由?如果路由配置信息存在 MySQL 或 Nacos 中,网关集群在拉取配置时发生冲突,或者某个路由配置错误导致网关启动失败,该如何保证高可用?
实现: 实现 RouteDefinitionRepository 接口,从 Nacos/Redis/DB 拉取路由定义。配合 Nacos 的监听机制,当配置变更时,调用 RouteDefinitionWriter 写入,并发布 RefreshRoutesEvent 事件刷新路由表。 高可用防御: 本地缓存: 网关启动或 Nacos 宕机时,必须从本地磁盘/缓存加载上一次成功的路由配置(兜底机制)。 配置校验: 在将新路由推入网关前,进行语法和连通性校验,避免单条错误配置引发整个网关路由表构建失败。 灰度设计: 利用 Gateway 自带的 Weight 谓词,配合自定义的 Header/Cookie 谓词实现流量切分。
sentinel
openfeign
一、 第一次调用为什么很慢,如何优化
- spring对feign执行懒加载
- Feign 本质是 “接口 + 注解” 的声明式调用,动态代理对象的首次创建
- 首次调用时,负载均衡器会初始化服务列表、健康检查器、负载均衡策略
- 网络连接的 TCP 三次握手
- Feign 的编码器、解码器、日志组件等依赖,默认也是懒加载的。
如何优化
- 禁用 Feign 客户端的懒加载(最有效)
- 预热 Feign 客户端(适合核心服务) @PostConstruct手动 “预热”
- 替换 HTTP 客户端并配置连接池 Feign 默认用URLConnection(无连接池,每次调用新建连接),换成HttpClient或OkHttp并配置连接池
- 优化负载均衡器初始化 如果用 Spring Cloud LoadBalancer,可提前初始化服务列表缓存,避免首次调用时拉取服务
二、 如果远程调用失败的原因和解决
- 配置: 注解、接口路径、请求方法、参数传递、依赖是否有缺失
- 网络: 超时配置时间过短、connectTimeout和readTimeout都要设置合理的值
- 服务端: 是否有异常、查看服务端、测试服务端接口、出现500根据具体情况查看是什么问题(业务还是逻辑)
- 负载均衡: 考虑服务是否注册到nacos当前状态是否up,项目中是否引入负载均衡、再次确认feignClientName是否和nacos上一致。
排查:看日志、定范围、单点验证
三、 重试机制 重试分业务不是所有的业务都需要重试 瞬时可自愈的故障、重试一定要开幂等、对最终一致性要求高(如非同步的任务通知)
一定不能重试的情况: 调用非幂等的写操作(下单付款转账)
四、OpenFeign 怎么传递 Token / 请求头
- @RequestHeader 手动传
- 实现 RequestInterceptor 拦截器自动传递
- 用 Feign 扩展配置
balance
CAP/BASE
Consistency (一致性):所有节点在同一时间的数据完全一致 Availability (可用性):所有服务都可用 Partition Tolerance (分区容错性):至少有一个好节点对外服务 CAP无法同时存在,只能CP和AP二选一
BASE Basically Available(基本可用) Soft state(软状态):允许中间不一致 Eventually consistent(最终一致性)
BASE理论的核心思想是:即使无法做到强一致性,但每个应用都可以根 据自身业务特点,采用适当的方式来使系统达到最终一致性。
四种AT,SAGA,XA,TCC
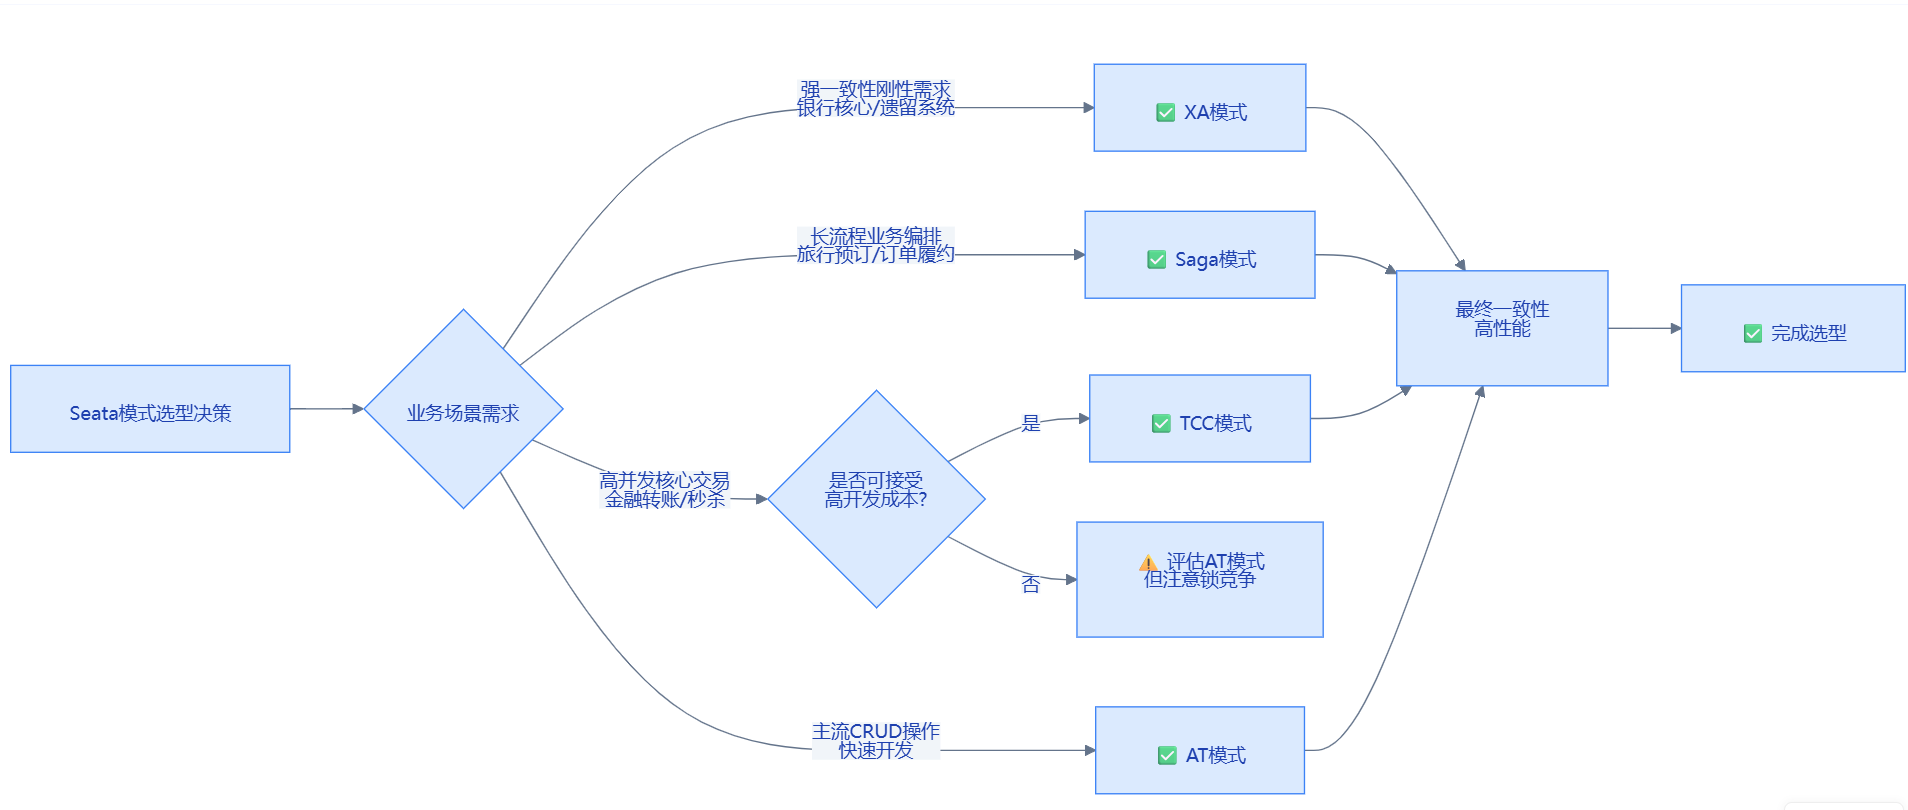
AT:无侵入方案,一阶段拦截SQL,二阶段提交或回滚 AT 是平衡型选手,低侵入、高性能,适合大多数场景。 @GlobalTransetional 主方法注解 @Transetional 分支业务上
Saga:适用长事务 Saga 是长跑冠军,无锁、灵活,专为长事务设计。
XA:通过资源管理器和事务协调者来保证事务的原子性 XA 是保守派,强一致但性能差,适用面窄
TCC:它将事务拆分为三个阶段:尝试(Try)、确认(Confirm)和取消(Cancel) Try尝试预留资源 → Confirm确认执行 → Cancel出问题就回滚,核心是用“预留+确认+撤销”保证分布式事务最终一致 TCC 是性能先锋,高开发成本换高并发与强一致性
2PC”它有两个阶段:准备(Prepare)和提交(Commit)” 2PC就是‘先问所有人能不能干,等大家都说能,再统一命令一起干;只要有人说不,就全部拉倒不干’。
分布式事务解决方案
1.两阶段协议(强一致性优先);一阶段准备二阶段提交 弊端:同步阻塞,协调者单点故障,数据不一致 优点:效率高
2.三阶段协议(可用性优先):一阶段问,二阶段预提交,三阶段提交 解决了阻塞问题,加入了参与者超时 弊端:实现复杂,网络开销增加,极端情况也不一致
3.TCC(最终一致性):三个阶段:尝试(Try)、确认(Confirm)和取消(Cancel) 优点:高并发,无协调者单点故障,最终一致性 缺点:开发成本高,业务侵入性强,实现复杂,不保证强一致,不适合长业务
4.消息队列(最终一致性):通过发消息开启事务 优点:高并发,无阻塞,解耦,实现简单侵入性较低,削峰填谷 缺点:一致性延迟时间长,性能有损耗,有队列的所有缺陷(主要在于消息)
四种限流算法
1. 四种限流算法
- 计数器限流
- 滑动窗口限流
- 漏桶算法
- 令牌桶算法
2. 热点参数限流是什么?应用场景
热点参数限流:针对接口中某个高频访问的参数值单独限流,而不是对整个接口统一限流。
例如:根据 用户 ID、商品 ID、IP 进行限流,只限制“热门参数”的访问,不影响其他正常请求。
典型应用场景
-
商品详情页防刷
某个爆款商品 ID 被大量请求时触发限流。 -
用户防刷 / 防爬虫
某个用户或 IP 疯狂请求接口。 -
热点搜索词限流
某个关键词被频繁搜索。 -
防恶意攻击
针对特定参数值的恶意请求进行拦截。
3. Sentinel 的底层统计原理
Sentinel 底层使用 LeapArray(跳跃数组) 实现滑动时间窗口,将 1 秒切分为多个小窗口,配合无锁原子计数进行高性能统计,支持秒级精准的 QPS / 线程数 / RT(响应时间)/ 异常监控。
核心数据结构:LeapArray
- 将 1 秒切分为多个小时间窗口(默认:1s 分为 2 个窗口,每个 500ms)。
- 每个窗口存储:
pass/block/total请求数- RT、异常数、成功数等指标
- 结构:数组 + 原子计数器 → 无锁、高性能
滑动窗口工作流程
- 根据当前时间,计算请求落在哪个小窗口。
- 如果是旧窗口:复用或重置数据。
- 如果是新窗口:创建新窗口。
- 统计时:将所有有效窗口的值相加,得到 1 秒内的总 QPS。
4. 生产中 Sentinel 如何配置?核心注意点
生产 Sentinel 核心:规则持久化、网关限流、系统自适应保护、热点参数限流、兜底轻量化、监控可观测、阈值基于压测,保证高可用不误杀。
一、生产核心配置(必配)
1. 规则必须持久化
- 不用内存规则,必须用 Nacos / Apollo
- 流控、降级、热点、系统、授权规则全部持久化
- 控制台修改 → 推送到配置中心 → 所有实例同步
2. 接入限流埋点
- Web 接口、Feign、Gateway、Dubbo 都要适配
- 自定义核心接口用
@SentinelResource
3. 限流降级兜底返回
@SentinelResource(
    fallback = "fallbackMethod",
    blockHandler = "blockHandler"
)blockHandler:处理限流 / 熔断fallback:处理业务异常- 不能吞异常,必须返回友好提示
4. 网关流控(必开)
- Spring Cloud Gateway 全局限流
- 路由维度 + 自定义参数维度
- 防止流量直接打崩下游微服务
5. 系统自适应保护(必开)
- CPU 使用率 ≤ 80%
- Load 阈值 ≤ CPU 核心数 × 2.5
- 最大并发线程数
- 平均 RT 阈值
6. 热点参数限流(高频接口必配)
- 商品 ID、用户 ID、IP、搜索词
- 防止热点参数打崩接口
7. 日志与监控
- 开启
sentinel.log日志 - 对接 Prometheus + Grafana
- 限流、降级、熔断、异常全部可观测
二、生产核心注意点(重中之重,面试必问)
🔹 规则不能乱设,必须先压测
QPS、线程数、RT 必须基于压测结果,不能凭感觉设阈值,否则会误杀正常流量
🔹 重试接口一定要注意幂等
Sentinel 限流 / 降级会触发重试,非幂等接口(新增 / 支付)不能随便重试
🔹 兜底逻辑必须轻量化
不能写复杂逻辑、不能查 DB、不能调远程服务,否则兜底本身也会崩
🔹 集群限流要单独配置
单机限流 ≠ 集群限流,大促、秒杀必须开集群限流
🔹 网关限流 > 服务限流
流量尽量在网关层拦住,不要让无效流量打到后端服务
🔹 系统规则是全局保护,优先级最高
只要 Load/CPU 超了,直接拦入口流量,保护系统不被打满卡死
🔹 规则变更必须灰度
不能一次性全量推,先单实例 → 再集群
🔹 Sentinel 控制台不能直接生产裸奔
必须登录权限,规则修改要留日志,重要规则需审核
🔹 避免循环依赖、异步上下文丢失
异步代码需要手动传递上下文,否则限流不生效
🔹 生产环境关闭不必要的心跳日志
避免日志疯狂打盘 IO
熔断降级策略
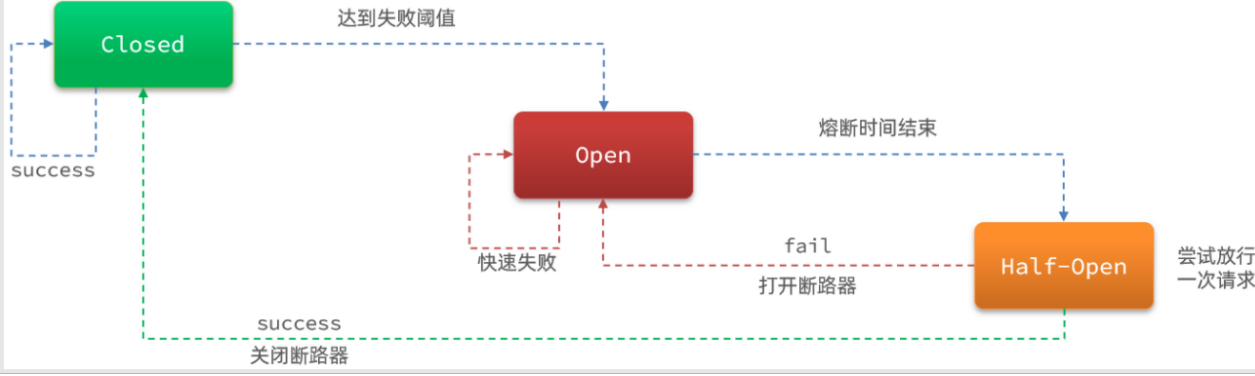
1.熔断三种触发策略 慢调用比例:请求响应时间 > 阈值的比例超过设定值(如 > 500ms 的请求占比≥30%)。 异常比例:异常请求占总请求的比例超过设定值(如异常率≥20%)。 异常数:单位时间内异常请求数超过阈值(如 1 分钟内异常≥50 次)。
2.熔断的状态转换 关闭(Closed):正常调用,统计请求数据。 打开(Open):触发熔断规则,直接拒绝所有请求,进入降级。 半开(Half-Open):熔断超时后,放行少量请求测试;若正常则恢复关闭,否则重新打开。
3.降级的兜底逻辑 BlockHandler:处理限流 / 熔断触发的阻塞(如 FlowException 、 DegradeException )。 Fallback:处理业务异常(如空指针、数据库报错),也可兼容阻塞异常。 区别:BlockHandler 专注流量规则触发,Fallback 专注业务异常
单体/微服务/分布式集群区别
两大核心功能
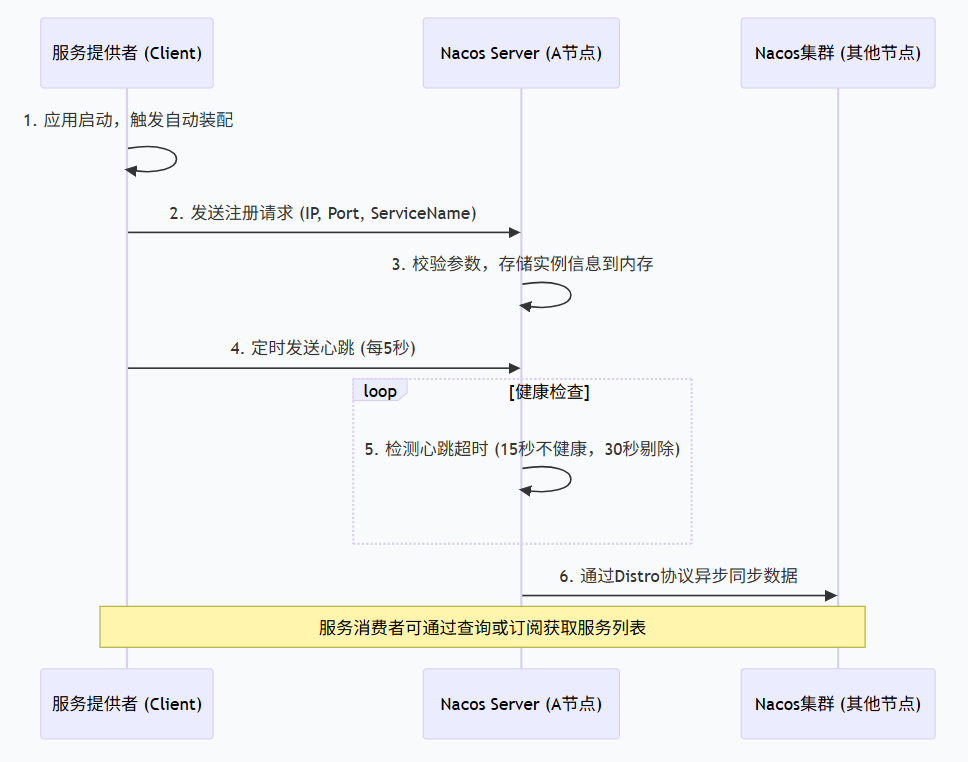
一、nacos的功能 1.服务注册与发现 2.动态配置管理 3.服务路由与负载均衡 4.服务共享与版本管理 5.服务监控与治理
二、两个核心功能 服务注册与发现默认采用 AP 模式,而配置管理可切换为 CP 模式。
三、nacos如何通知配置修改 在 Spring Cloud 生态中,使用 @RefreshScope 注解可以更便捷地实现配置热更新。 原理:被 @RefreshScope 注解的 Bean,其生命周期是“刷新”作用域的。
工作流: 1.Nacos 客户端通过长轮询感知到配置变更。 2.Spring Cloud 会发布一个 EnvironmentChangeEvent 事件(环境变化事件)。 3.@RefreshScope 会销毁当前作用域内所有 Bean 的缓存实例。 4.当下次用到这些 Bean 时,Spring 会重新创建它们,并注入最新的配置值,从而实现无需重启的热更新。
四.Nacos服务发现的原理 服务发现: 调用方在第一去发起远程调用的时候,会把远程的服务以及该服务的实例都缓存到本地Map中,当后面在去发起远程调用的时候,就会优先查询本地Map,如果本地Map有,那么直接根据本地Map的数据,去发起远程调用,如若没有,才像远程(Nacos)发送一个请求:/nacos/v1/ns/list.获取到远程数据在同步到缓存。
数据一致性问题: 终Ncaos来解决服务发现数据不一致问题是通过TCP协议的定时任务发请求,和UDP协议的主动发送事件请求,来解决一致性的。
案例: 某天凌晨,你们的微服务系统发生了一次大规模服务雪崩。经过排查,发现起因是网络短暂闪断(约 20 秒),导致 Nacos 服务端将大量服务实例标记为不健康并剔除。网络恢复后,服务却未能及时恢复,导致大量请求失败。
现有两条信息: 你们的服务都是临时实例(默认)。 Nacos 集群部署了 3 个节点。
心跳机制参数: 心跳间隔:5 秒(客户端定时发送)。 不健康判定:15 秒未收到心跳,标记为不健康(此时仍保留实例,但调用时会避开)。 实例剔除:30 秒未收到心跳,从服务列表中彻底删除。 因此,20 秒的网络闪断会触发“不健康”标记(15 秒已过),但尚未到达 30 秒的剔除阈值。若用户自行修改过剔除时间,则可能已触发剔除。
恢复步骤: 服务恢复后,客户端需要重新发送心跳(每 5 秒一次)。 服务端收到第一个心跳后,会将实例状态恢复为健康。 如果服务端已将实例剔除(超过 30 秒),则需要重新发起注册请求,而不是仅靠心跳恢复。 其他服务消费者通过订阅机制(gRPC 长连接推送)或主动查询(Pull)才能感知到实例恢复。如果是剔除后重新注册,推送会有一定延迟。
算法
round robin:轮询方式;默认负载均衡算法,按照请求的顺序依次分配给后端服务器。 random:随机 随机选择一个后端服务器来处理请求 url_hash:依据url分配方式根据客户端请求url的hash值,来分发请求, 同一个url请求, 会发转发到同一个服务器上 ip_hash:依据ip分配方式根据客户端请求的IP地址计算hash值, 根据hash值来分发请求, 同一个IP发起的请求, 会发转发到同一个服务器上 weight:权重方式 根据权重分发请求,权重大的分配到请求的概率大 least_conn:依据最少连接方式哪个服务器当前处理的连接少, 请求优先转发到这台服务器 nacos的本地优先负载均衡算法:基于 cluster-name 划分集群(机房 / 可用区);消费者优先调用 同 cluster-name 的实例;本地集群无可用实例时,才跨集群降级;同集群内再按加权随机 / 轮询分配
事务失效的场景
1.代理不生效 ①注解标注在接口方法上 ②被final,static关键字修饰类 ③类方法内部调用 ④当前类没有被spring容器管理
2.框架或底层不支持 ①非public修饰的方法 ②多线程调用 ③数据库不支持事务 ④未开启事务
3.错误使用@Transactional ①错误的传播机制 ②rollbackFor属性设置错误 ③异常被内部catch ④嵌套事务
转发和重定向
get和post区别
内部转发 外部重定向 请求次数 1 2 request带值 带 不带 地址栏 不变 变 跨域 不能 能 归属 request response
get post核心语义 查询用 创建/提交 参数位置 URL?key=value body体 是否被缓存 会 不会 TCP数据包 发一次 发多次 幂等性 有 没有 1.文件上传一定要使用post,因为get方式只支持application/x-www-form-urlencoded编码格式 2.表单提交使用post,如何处理重复提交? 提交后使用重定向到一个GET请求的成功页,get就随便刷也不怕
cloud
1.微服务核心组件与职责 2.服务注册与发现(高可用性) 3.分布式配置中心(动态刷新) 4.分布式事务(数据一致性) 5.链路追踪与可观测性(线上排障) 6.熔断与限流设计(高并发应对) 7.服务网关与安全(流量管控) 8.服务间通信与负载均衡(性能与容错) 9.实战踩坑与问题解决(真实经验验证) 1.微服务项目里比较常见的坑,主要集中在远程调用、配置刷新、分布式事务、缓存一致性、网关鉴权和线上排查这些地方。
2.远程调用没设置超时,导致服务被拖垮 问:比如订单服务调用库存服务,库存服务突然变慢。如果 Feign 或 HTTP 客户端没有设置合理超时,订单服务的线程会一直等。 答:我们后来统一给服务调用配置了超时时间,比如连接超时 1 秒、读取超时 3 秒,同时对核心下游加熔断规则。这样下游服务抖动时,上游不会一直等待,而是快速失败或走降级逻辑。 3. 重试机制把下游打得更崩 问:重试不是越多越好。下游已经慢了,上游还不停重试,流量会被放大。 比如原来 1000 个请求,重试 3 次,可能变成 3000 次调用。 答:重试一定要谨慎,特别是下单、扣库存、支付这种非幂等接口,不能无脑重试。我们一般只对查询类或明确幂等的接口做有限重试,并且配合熔断和退避策略。 4.分布式事务导致数据不一致 问:比如:订单创建成功,库存扣减失败 答:我们更倾向用最终一致性,而不是强行用强一致事务。比如订单服务先在本地事务里保存订单和消息记录,然后异步通知库存服务扣库存。库存扣减失败会重试,多次失败进入补偿表,后面定时任务或人工处理。
10.Spring Cloud 版本演进与技术栈更新(学习成长性) 老:Eureka + Ribbon + Feign + Hystrix + Zuul + Config + Sleuth
新:Nacos + OpenFeign + LoadBalancer + Sentinel/Resilience4j + Gateway + Micrometer Tracing/SkyWalking
我一般会从“老技术栈到新技术栈”的变化来理解 Spring Cloud。
比如以前 Ribbon 负责客户端负载均衡,现在官方更推荐 Spring Cloud LoadBalancer;以前 Hystrix 做熔断,现在更多用 Sentinel 或 Resilience4j;以前 Zuul 做网关,现在更多用 Spring Cloud Gateway;以前 Sleuth 做链路追踪,Spring Boot 3 后更多切到 Micrometer Tracing。
如果让我做版本升级,我不会直接全量替换。会先确认 Spring Boot 和 Spring Cloud 的版本兼容关系,再从非核心服务试点,做回归测试和压测,同时保留回滚方案。因为微服务升级影响面比较大,注册中心、网关、调用链、监控、配置刷新都可能受影响。
1,2
一、微服务核心组件与职责
通俗比喻
以前开一家大超市,进货、收银、仓储、售后全挤一间屋子干活(单体项目),人多直接乱套。
现在拆成一堆小店,各干各的:生鲜店、收银台、仓库、客服店、保安亭。
每个组件就是一个固定岗位,各司其职,凑一起才能正常运转整套商圈:
- 注册中心:小区公告栏,所有小店报自己在哪开门
- 配置中心:统一通知板,改价、营业时间不用每家手写
- 网关:商圈大门,所有人只能从这进,查身份、分流
- 熔断限流:门店限流告示,人太多不让进,防止挤垮店员
- 链路追踪:监控摄像头,能看清顾客从进门到结账走了哪条路
- 负载均衡:多个同款收银台,客人均匀分流,不挤一家
- 分布式事务:买生鲜 + 熟食一起结账,不能只扣钱不给货
专业解析
微服务将传统单体架构拆分为多个独立、单一职责的服务,通过各类核心组件实现统一治理、稳定运行,各组件职责清晰、各司其职:
| 组件 | 职责 |
|---|---|
| 注册中心 | 统一维护所有服务的地址信息,实现服务注册、发现与健康检测,让服务之间可以互相调用。 |
| 分布式配置中心 | 集中管理所有服务的配置参数,支持动态更新,无需重启服务即可生效。 |
| 服务网关 | 系统统一流量入口,负责请求路由、身份校验、流量管控,实现所有请求的统一拦截与分发。 |
| 熔断限流组件 | 高并发场景下保护服务,限制请求流量、熔断故障服务,避免系统整体雪崩。 |
| 链路追踪组件 | 记录完整请求调用链路,精准定位线上卡顿、报错位置,提升问题排查效率。 |
| 负载均衡 | 将请求均匀分发到多个服务实例,分担压力、提升系统性能,单个实例故障不影响整体使用。 |
| 分布式事务 | 保障跨多个服务的业务操作,数据要么全部成功、要么全部回滚,保证数据一致性。 |
二、服务注册与发现(高可用性)
通俗比喻
注册 = 开店报备,发现 = 找店地址,高可用 = 公告栏不会坏
- 注册:每家新店开张,主动去小区公告栏(注册中心)登记:我叫啥、在哪栋楼、电话多少
- 发现:生鲜店需要找收银台结账,先去公告栏查收银台地址,再上门
- 高可用痛点:如果只有一张公告栏,板子丢了所有人找不到店,直接停业
- 高可用方案:复制好几块一模一样的公告栏,数据实时同步,一块坏了其他顶上,商圈正常运转
举例:Eureka / Nacos 集群,多台机器互相备份,不会单点崩溃。
专业解析
服务注册与发现是微服务通信的基础能力:
- 服务注册:所有服务启动后,主动向注册中心上报自身地址、端口等实例信息。
- 服务发现:服务调用前,从注册中心拉取目标服务的可用实例列表,完成正常调用。
高可用是为了解决注册中心单点故障问题。通过部署多节点集群,节点间数据实时同步,单个注册中心节点宕机不会影响整体服务的注册与发现,保证整个微服务集群持续稳定运行,杜绝服务失联、业务中断问题。主流实现为 Nacos、Eureka 集群部署。
7,8
网关职责: 1.统一认证入口:所有请求先过网关,集中处理登录校验、Token 验证,避免每个微服务重复鉴权 2.流量防火墙:在网关层做 IP 黑白名单、请求限流、防重放攻击(防刷) 3.安全过滤前置:在转发前完成 HTTPS 强制跳转、敏感 Header 脱敏、XSS 过滤等
关键安全 Filter 实现(4 个必备) 1.AuthenticationFilter:拦截请求,提取 Token(Cookie/Header),校验有效性 2.AuthorizationFilter:校验权限(如角色、API 访问级别) 3.RateLimitFilter:基于 IP/用户 做限流(结合 Redis + Lua) 4.LoggingFilter:记录请求日志(脱敏后存储),用于审计
服务间通信的俩种方式: 1.OpenFeign:假装调用本地方法,实际发HTTP请求 2.RestTemplate:手动拼URL发请求
OpenFeifn流程: 1.加依赖: spring-cloud-starter-openfeign 2.启动类加入注解: @EnableFeignClients 3.写接口 4.yml配置: 🌰: spring: feign: client: config: default: connectTimeout: 2000 # 建连超时(2秒) readTimeout: 3000 # 读取超时(3秒) loggerLevel: basic # 日志级别 hystrix: enabled: true # 开启熔断降级
5.如果服务挂了走降级处理
负载均衡: 一个服务部署了3台机器(3只羊),请求来了轮流/按权重分配,别可着一只使劲薅。
负载均衡策略: 1.轮询 2.随机 3.权重响应时间:响应越快的机器接越多活 4.最少并发:谁当前处理的请求少就給谁 5.可用性过滤:只挑活着的、连接数没满的 6.重试:调失败自动换一台再试
5,6
为什么需要链路追踪?
单体应用时代,一个请求在单个进程内走完,排查问题看日志即可。但在微服务架构下,一个用户请求可能穿越 20-30 个服务,任何一环出问题都可能导致超时或报错。没有链路追踪,你只能一个一个服务翻日志
可观测性的三大支柱
| Metrics (指标) | Tracing (链路追踪) | Logging (日志) |
|---|---|---|
| 聚合的数值数据 | 请求级别的调用链 | 离散事件记录 |
| 知道 “发生了什么” | 知道 “怎么发生的” | 知道 “为什么发生” |
| 计数器 / 仪表盘 | Span / Trace | 文本 / 结构化 |
| 直方图 / 摘要 | Context 传播 | JSON / Key-Value |
链路追踪(Trace)的核心原理
在一次请求的起点生成一个全局唯一的 ID,并让这个 ID 随着请求在整个分布式系统中流转。
故障排查标准步骤:
指标报警(Metrics 触发): Prometheus 监测到某个接口的 99% 响应时间(P99)超过 3 秒,或者异常率陡增,触发 Alertmanager 报警到钉钉/企业微信。 链路定位(Traces 诊断): 运维或开发点击报警链接,直接跳转到 SkyWalking(或 Jaeger)界面。 在拓扑图中,寻找变红的节点或耗时明显呈红色的 Span。例如,发现 ServiceA →ServiceB →MySQL 的调用链中,最后一步 MySQL 执行耗时达 2.8 秒。 日志溯源(Logs 定位根因): SkyWalking 定位到了慢 SQL 或异常发生的节点,并提供该次请求的 Trace ID。 开发人员复制该 Trace ID,前往 ELK/Kibana 中检索:traceId: “123456abcd”。 原理:我们在应用中通过 MDC(Mapped Diagnostic Context)机制,在打印日志时,自动将 TraceId 注入到 Logback 的日志格式中。这样,Kibana 搜出来的就是这一次请求在所有服务、所有机器上的所有日志汇聚。 通过日志,直接看到具体的 NullPointerException 或慢 SQL 语句。
熔断(Circuit Breaking):保护自身免受他人拖累。防止依赖的下游服务变慢/崩溃。根据调用指标(错误率、慢调用比例、异常数)。通常在调用下游服务客户端(Feign 拦截处、RPC 客户端)。 限流(Rate Limiting):保护自身。防止外部流量过大,超出系统承载极限。根据流量指标(QPS、并发数、线程数)。通常在系统入口(网关层、外部 API 接口处)。
常用限流算法对比及适用场景
(1) 固定窗口(Fixed Window) 原理:单位时间内(如 1 秒)设置一个计数器,超过阈值则限流。到下一个周期清零。 缺陷:存在临界突刺问题。在第 1 秒的最后 100 毫秒和第 2 秒的头 100 毫秒内,可能瞬间涌入双倍的流量。 (2) 滑动窗口(Sliding Window) 原理:将时间窗口切分为多个小格子(如 1 秒切为 10 个 100 毫秒的格子),窗口随着时间向后滑动,每次只计算当前滑动窗口内的总数。 应用:Sentinel 的默认限流机制。解决了固定窗口的边界突增问题。 (3) 漏桶算法(Leaky Bucket) 原理:请求像水一样先进入漏桶中,漏桶以恒定的速度向外流水(处理请求)。如果桶满了,水就溢出(拒绝请求)。 优点:能够强行将流量平滑化(Uniform Flow)。 应用场景:常用于需要以固定速率消费的场景(如消息队列流控、数据库定速写入)。缺点是无法应对突发流量。 (4) 令牌桶算法(Token Bucket) 原理:系统以恒定速度往桶里放令牌,请求进来必须先拿到令牌,才能被处理。如果桶满了,多余的令牌会被丢弃。如果桶里有累积的令牌,请求可以瞬间拿走,不需要等待。 优点:允许一定程度的突发流量(Burst)。 应用场景:微服务网关限流的经典之选(如 Spring Cloud Gateway 默认限流器采用的 Redis 令牌桶算法)。
3,4
解决的问题:微服务集群的配置如何统一管理,并能在不重启服务的情况下实时生效。 核心工作流程 一、怎么感知配置变化 1.定时轮询(过时):客户端每几秒获取配置中心的配置与本地比较 2.长轮询(Apollo用):客户端发请求到服务端,默认挂起60秒,期间配置变了服务端返回最新配置 3. 长连接推送(Nacos):客户端与服务端之间维护一条 TCP 长连接,管理端修改配置后服务端通过链接向客户端推送通知 二、应用配置 1.配置信息存在environment对象中,收到更改通知更改内部的配置map,发布一个EnvironmentChangeEvent事件。 2.通过 @RefreshScope 刷新 Bean:第一次访问创建Bean,之后在缓存中拿这个Bean。当配置修改会清空缓存中的bean。再次访问这个Bean的时候创建新的。避免启动时的大规模重建开销和瞬时故障。 3.@ConfigurationProperties 的自动重新绑定:配置改变后直接销毁Bean,然后初始化并绑定。
分布式事务(数据一致性) 它解决的核心问题是:一次业务操作跨了多个独立的数据库(或服务),如何保证这些操作要么全部成功,要么全部失败。
从单体到分布式 单库事务靠 ACID 的原子性和隔离性,一个 commit/rollback 全搞定。但分布式环境下,数据库各自独立,网络也可能出问题,数据一致性面临巨大挑战。
CAP 理论告诉我们 P(分区容错)必须选,那么就会在 C(强一致)和 A(高可用)之间权衡。
常见方案演进
- 两阶段提交(2PC / XA)—— 强一致,但性能差
协调者先问所有参与者:“能提交吗?”(准备阶段,锁定资源)
所有参与者都回复 YES,协调者再发“正式提交”。
缺点:同步阻塞,锁资源时间长;单点故障会导致阻塞;不适合高并发互联网场景。
- TCC(Try-Confirm-Cancel)—— 业务层补偿
把每个业务操作拆成三部分:Try(预留资源)、Confirm(确认执行)、Cancel(回滚释放)。
比如转账:Try 阶段冻结钱,Confirm 扣减冻结金额,Cancel 解冻。
优点:没有数据库长锁,性能好;最终一致性。缺点:业务侵入大,需自己实现幂等性和空回滚。
- 本地消息表 + 可靠消息最终一致性
核心思想:通过消息驱动异步扣款/下单,利用本地事务保证“业务操作”与“消息写入”原子性。
做法:事务发起方在一个本地事务里,同时完成业务操作和往本地“消息表”插入一条状态为“待发送”的记录;然后有一个后台任务定期扫描,把消息可靠投递到 MQ;消费方保证幂等处理。
- Saga 模式 —— 长事务编排
适用于长流程,如订单-库存-支付-物流。 顺序调用各个微服务的接口;每个步骤成功则继续,失败则触发逆序的补偿操作。
协调方式有“编排式”(一个 Saga 管理器串联)和“协同式”(各服务通过事件互相触发)。
也需要保证幂等,允许最终一致。
- Seata —— 一站式分布式事务中间件
提供了 AT(自动补偿,类似 2PC 但无锁阻塞)、TCC、Saga 等模式。
AT 模式:通过代理数据源,自动记录 undo_log,在回滚时逆向生成 SQL 回补数据,对业务几乎无侵入。
选型建议 并发低、对一致性要求极高(如金融核心系统)→ 可考虑 XA。
高并发、允许短暂不一致,但最终要一致 → TCC 或 Saga。
异步解耦场景 → 本地消息表 / 事务消息。
想开箱即用、减少开发 → Seata(根据场景选模式)。
三大核心监控指标
1.三个核心监控指标
- QPS:每秒请求数(最常用)
- TPS:调用该接口的并发线程数
- 响应时间 RT:平均响应时间,用来做慢调用降级
2.流控模式 直接:当前接口达到阈值直接限流 关联:关联接口达到阈值,限流当前接口 链路:只针对某一条调用链路限流
3.流控效果 快速失败 WarmUp(预热,防止冷启动) 排队等待(匀速排队)
熔断配置参数
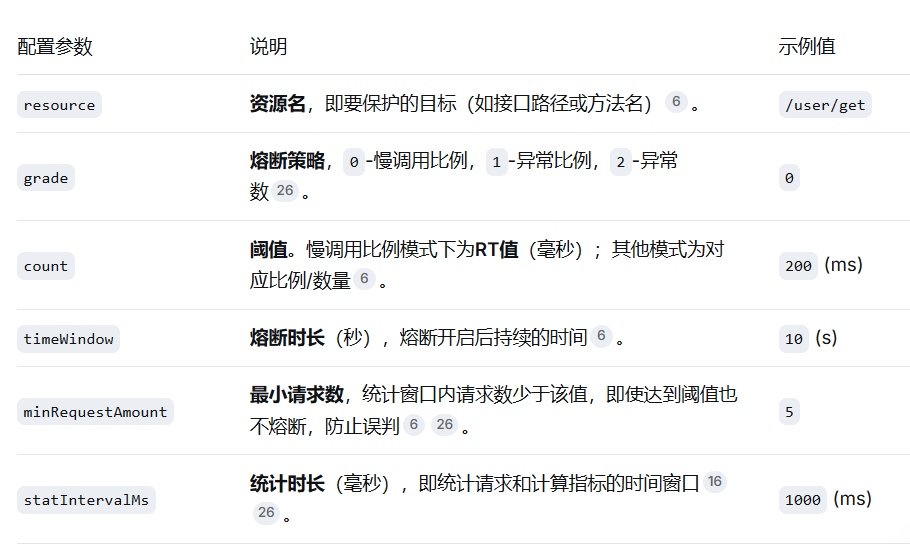
降级规则
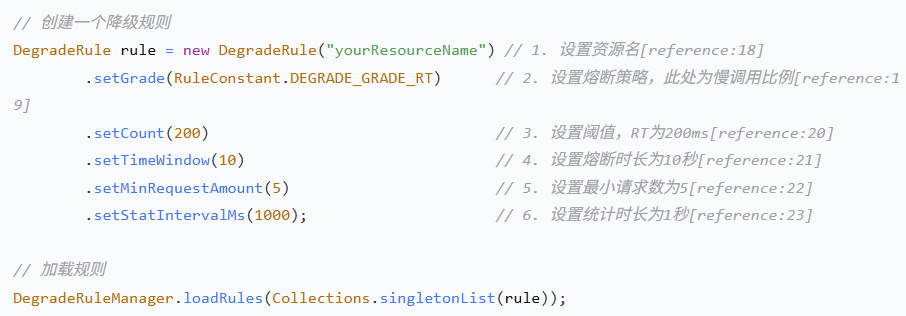
降级逻辑
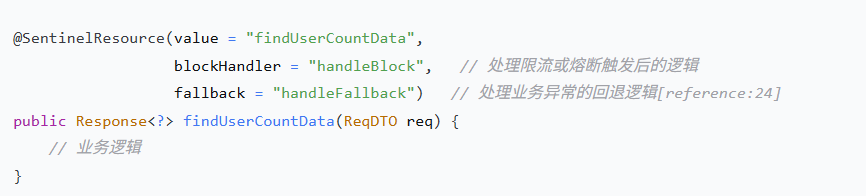
补充说明
三层防护
第一层防线:Nginx (流量入口) Nginx 作为最前置的网关,主要负责在网络层拦截恶意或超量的流量,保护内部系统。 核心算法:主要基于漏桶算法 (Leaky Bucket)
第二层防线:Spring Cloud Gateway (业务网关) Gateway 是微服务架构的“业务大门”,其限流功能更精细、更灵活,可以结合业务逻辑进行控制。 核心算法:主要基于令牌桶算法 (Token Bucket)
第三层防线:微服务自身 (业务兜底) 即使请求通过了Nginx和Gateway,微服务自身仍需做好最后的防护,这是防止雪崩效应的关键。 核心实现:在微服务内部,通常会使用Sentinel或Resilience4j等库来实现限流、熔断和降级
小型项目或服务较少:可以只用 Spring Cloud Gateway + Redis 进行限流,链路简洁。 中大型微服务项目:强烈建议采用 Nginx + Gateway + Sentinel 的三层防护体系。
终极面试题
【背景场景】 为了满足安全审计要求,你在 Spring Cloud Gateway 中写了一个自定义的 GlobalFilter,用于记录所有经过网关的请求日志。为了能看到业务的具体参数,你需要读取并打印请求体。
你的初步实现代码如下:
@Component
public class RequestLogFilter implements GlobalFilter, Ordered {
@Override
public Mono
        // 继续放行
        return chain.filter(exchange);
    });
}
@Override
public int getOrder() { return -10; } // 最高优先级
} 【线上血案】 代码上线后,日志确实打印出来了,但系统陆续爆发了两个致命问题:
现象A:下游微服务疯狂报错 HttpMessageNotReadableException: Required request body is missing,大量请求丢失了请求体。 现象B:网关运行几天后,Pod 物理内存(RSS)持续飙升,直到被 Linux 内核 OOM-Killer 强杀,但 JVM 的堆内存监控却完全正常。
现象A 分析:请求体丢失(流只能读一次的诅咒)
原因:在 WebFlux/Netty 底层,request.getBody() 返回的是一个 Flux
- 现象B 分析:物理内存飙升但堆内存正常(Netty 堆外内存泄漏) 原因:这是 Netty 开发中最容易犯的错误——DataBuffer 引用计数泄漏。 在 Netty 中,为了实现零拷贝,DataBuffer 底层使用的是堆外内存,这部分内存不受 JVM 垃圾回收器(GC)的管理,而是采用引用计数法管理。 当你读取完 bytes 之后,没有调用 DataBufferUtils.release(join) 或 DataBufferUtils.release(dataBuffers) 来释放这些缓冲区,Netty 就会认为这些堆外内存还在被使用,永远不会回收。随着并发请求的增加,物理内存被吃光,触发 OOM-Killer。因为不是堆内存,所以 JVM 监控一切正常。 排查手段:开启 Netty 的内存泄漏检测级别:-Dio.netty.leakDetection.level=PARANOID,查看日志中 LEAK: ByteBuf.release() 的堆栈。
终极答案
gateway 底层webflux 响应式Mono,Netty服务,底层stream(),读完就没(一次性),如果要加工数据必须读完再做一个新的。Netty 占用了真机内存,申请后必须手动释放
import org.springframework.core.io.buffer.DataBuffer; import org.springframework.core.io.buffer.DataBufferUtils; import org.springframework.http.server.reactive.ServerHttpRequest; import org.springframework.http.server.reactive.ServerHttpRequestDecorator; import org.springframework.web.server.ServerWebExchange; import reactor.core.publisher.Flux;
@Component
public class RequestLogFilter implements GlobalFilter, Ordered {
@Override
public Mono
    // 使用 mutate 构建新的 exchange
    ServerWebExchange mutatedExchange = exchange.mutate()
        .request(new ServerHttpRequestDecorator(request) {
            @Override
            public Flux<DataBuffer> getBody() {
                // 使用 DataBufferUtils.join 将多个 buffer 合并,并自动处理释放
                return DataBufferUtils.join(super.getBody()).flatMap(dataBuffer -> {
                    // 1. 读取内容
                    byte[] bytes = new byte[dataBuffer.readableByteCount()];
                    dataBuffer.read(bytes);

                    // 2. 打印日志
                    System.out.println("请求体内容: " + new String(bytes));

                    // 3. 【关键1】释放原始的 dataBuffer,防止堆外内存泄漏!
                    DataBufferUtils.release(dataBuffer);

                    // 4. 【关键2】将读取到的 bytes 重新包装成新的 DataBuffer 放回流中
                    // 保证下游服务依然可以读取到 Body
                    DataBuffer newBuffer = DefaultDataBufferFactory.sharedInstance.wrap(bytes);
                    return Mono.just(newBuffer);
                });
            }
        }).build();

    return chain.filter(mutatedExchange);
}

@Override
public int getOrder() { return -10; }
}
TC、TM、RM
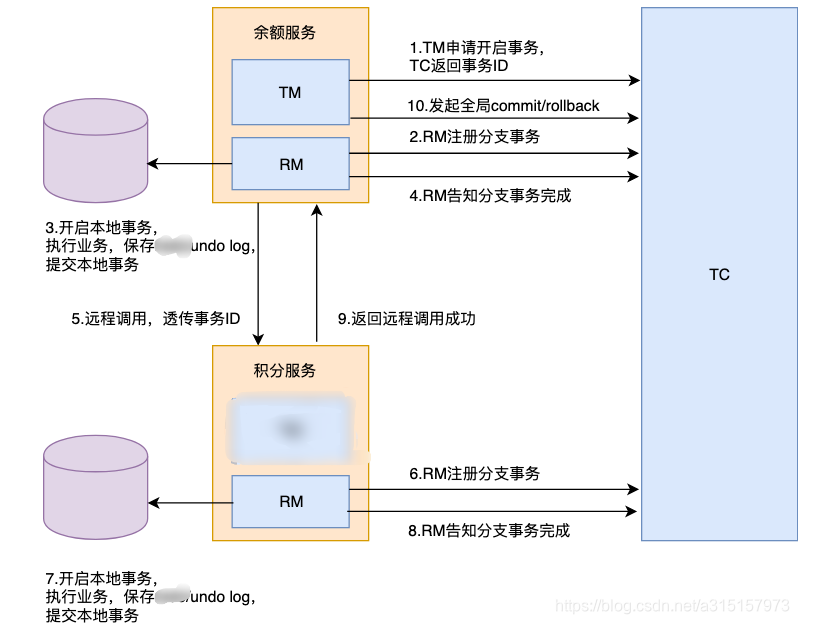
自由主题
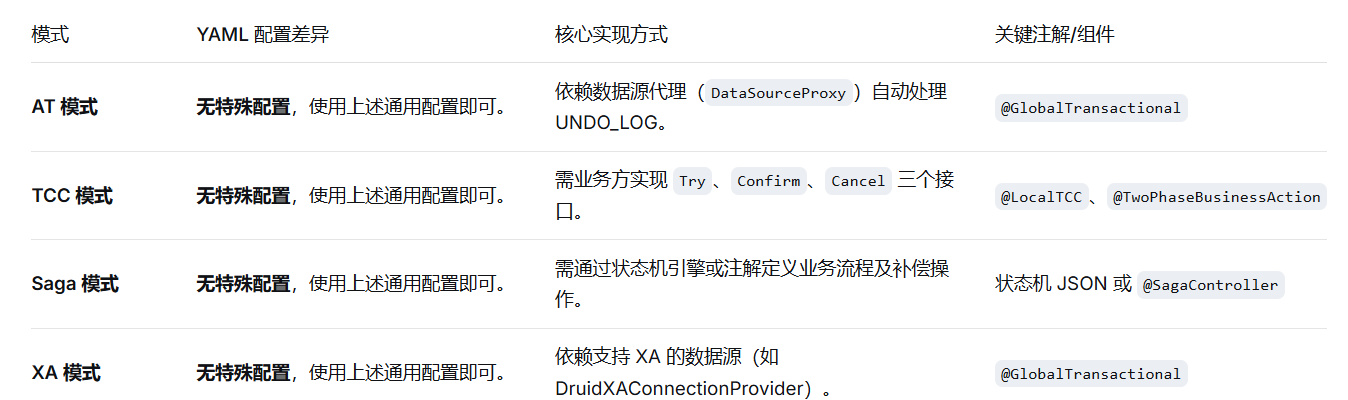
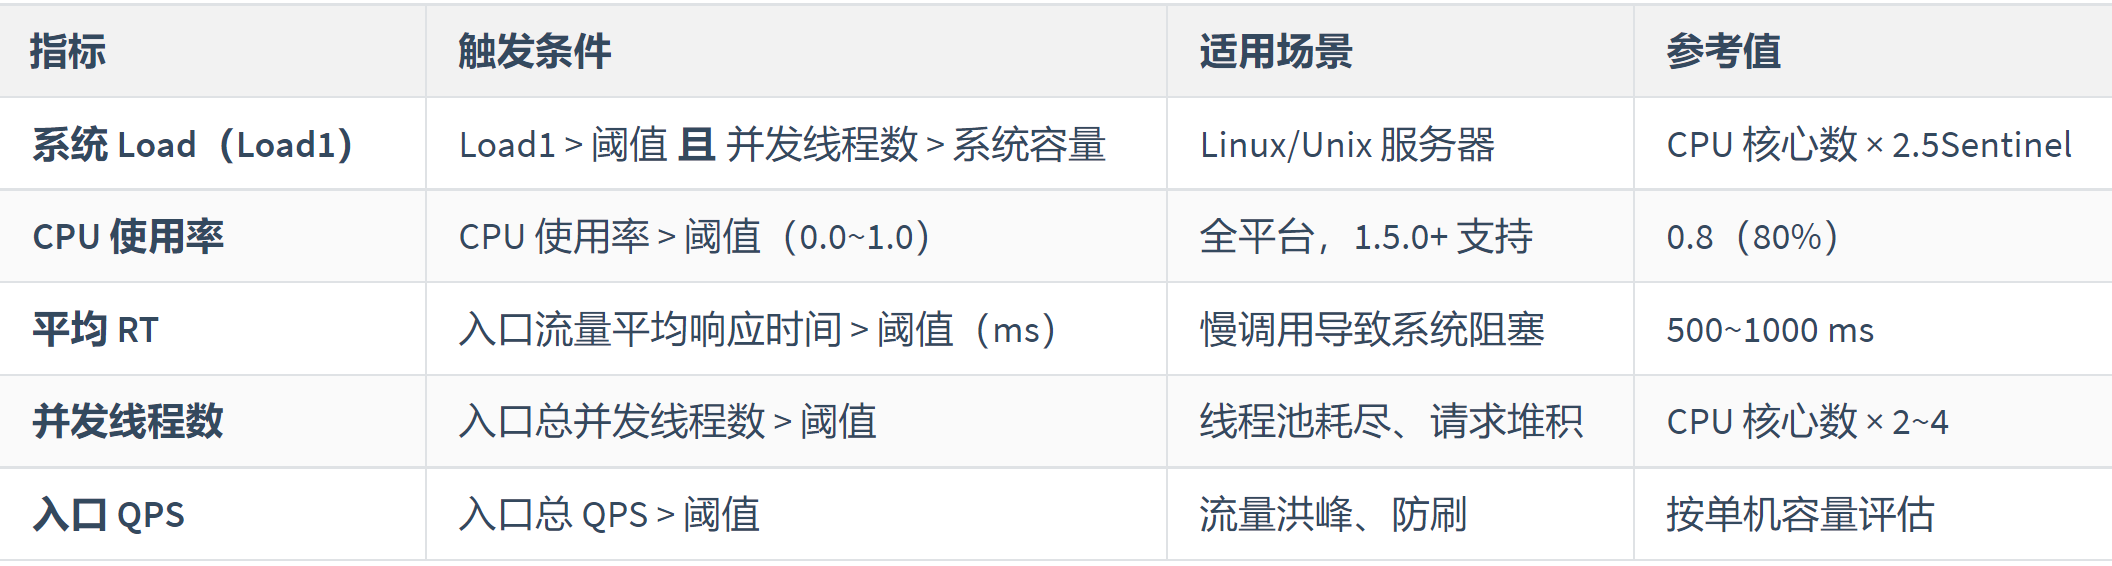
中间件
一、基础原理篇(第1-8题)
1. Redis为什么这么快?
- 纯内存操作:数据读写均在内存中完成,纳秒级延迟。
- 单线程模型(6.0之前):避免多线程上下文切换和锁竞争开销;使用I/O多路复用(epoll/select)高效处理海量并发连接。
- 高效数据结构:SDS(简单动态字符串)、跳跃表、压缩列表等精心设计的数据结构。
- 注意:Redis 6.0+引入多线程仅用于网络I/O读写,核心命令执行仍为单线程。
2(重点). Redis支持哪些数据类型?分别适用于什么场景?
| 类型 | 底层实现 | 典型场景 |
|---|---|---|
| String | SDS | 缓存对象、计数器、分布式锁 |
| Hash | 压缩列表/哈希表 | 存储对象(如用户信息) |
| List | 压缩列表/链表 | 消息队列、最新消息列表 |
| Set | 整数集合/哈希表 | 标签系统、共同好友、抽奖 |
| ZSet | 压缩列表/跳跃表 | 排行榜、延迟队列、带权重的任务调度 |
| Bitmap | String | 签到统计、在线状态 |
| HyperLogLog | 特殊结构 | UV统计(基数估算) |
| GEO | ZSet | 附近的人、地理位置计算 |
| Stream | 消息队列 | 持久化消息队列(类似Kafka) |
3. Redis的持久化机制有哪些?如何选择?
- RDB(快照):在指定时间间隔将内存数据集写入磁盘。优点:文件紧凑,恢复速度快;缺点:可能丢失最后一次快照后的数据。
- AOF(追加日志):记录每个写操作命令。优点:数据安全性高(可配置每秒/每次写入同步);缺点:文件体积大,恢复速度慢。
- 混合持久化(重点)(4.0+):RDB做全量备份 + AOF记录增量,兼顾恢复速度与数据安全。
4(重点). 简述Redis的过期删除策略与内存淘汰机制
- 过期删除:惰性删除(访问时检查过期)+ 定期删除(每100ms随机抽取一批设置过期时间的key检查)。
- 内存淘汰(8种策略):
noeviction:内存不足时返回错误(默认)allkeys-lru/volatile-lru:LRU淘汰 最近最少使用allkeys-lfu/volatile-lfu(4.0+):LFU淘汰 最不经常使用allkeys-random/volatile-random:随机淘汰volatile-ttl:淘汰即将过期的key
5. Redis事务支持ACID吗?
- 不完整支持:具备隔离性(单线程顺序执行)和原子性(命令队列整体执行),但不支持回滚——如果队列中某条命令执行失败,其他命令仍会执行。
- 通过
MULTI/EXEC/WATCH实现乐观锁(CAS机制)。
6. 什么是Redis Pipeline?与事务的区别?
- Pipeline:将多个命令打包一次性发送,减少网络往返(RTT),不保证原子性。
- 事务:保证命令按顺序执行且不被插入,但Pipeline不具备原子性保证。
7. Redis的主从复制原理是什么?
- 从节点发送
PSYNC请求 - 主节点执行
BGSAVE生成RDB并发送给从节点 - 从节点加载RDB
- 主节点将期间的写命令通过复制缓冲区持续同步给从节点
- 增量复制:网络断开重连后,通过
repl_backlog只同步断连期间的增量数据。
8. Redis哨兵(Sentinel)的作用是什么?
- 监控:检查主从节点是否存活
- 故障转移:主节点下线时,自动选举新主节点并通知客户端
- 配置中心:客户端通过哨兵获取当前主节点地址
- 注意:哨兵集群需要至少3个实例且奇数个,避免”脑裂”。
二、高级特性篇(第9-16题)
9. Redis Cluster集群的工作原理是什么?
- 哈希槽(Hash Slot):16384个槽位,通过
CRC16(key) % 16384决定key归属哪个节点。 - 去中心化:节点间通过Gossip协议交换集群状态信息。
- MOVED/ASK重定向:客户端访问错误节点时,返回正确节点地址。
- 高可用:每个主节点可配多个从节点,主节点故障时自动切换。
10. 什么是Redis的脑裂(Split-Brain)?如何避免?
- 脑裂:集群中部分节点因网络分区无法与主节点通信,选举出新的主节点,导致双主写入,数据不一致。
- 避免方案:
- 配置
min-slaves-to-write(至少N个从节点才接受写入) - 配置
min-slaves-max-lag(从节点最大延迟) - 哨兵模式配置
down-after-milliseconds和failover-timeout合理阈值。
- 配置
11. Redis的Lua脚本有什么优势?有哪些注意事项?
- 优势:原子性执行多个命令、减少网络开销、复用逻辑。
- 注意事项:
- 脚本应纯函数(避免使用随机函数如
time) - 脚本执行期间会阻塞Redis,耗时脚本会影响性能
- 使用
SCRIPT KILL或SHUTDOWN NOSAVE处理死循环脚本。
- 脚本应纯函数(避免使用随机函数如
12.(重点) 什么是Redis的Hot Key和Big Key?如何解决?
- Hot Key:高频访问的key。解决方案:本地缓存、读写分离、key拆分成多个子key分散压力。
- Big Key:value过大的key(如超大Hash/Set/ZSet)。危害:慢查询、网络阻塞、集群迁移困难。解决方案:拆分大key、使用
UNLINK异步删除、SCAN渐进式遍历。
13. Redis 6.0的多线程模型是如何设计的?
- 核心设计:主线程负责命令执行(仍为单线程),多个I/O线程负责网络数据读写和协议解析。
- 优势:提升大并发场景下的网络吞吐量,命令执行仍保持单线程的原子性优势。
- 配置:
io-threads-do-reads yes+io-threads N。
14. Redis的Stream数据类型与List相比有什么优势?
- Stream:支持消费者组(多消费者竞争消费)、消息持久化、ACK确认机制、消息回溯。
- List:简单的FIFO队列,消费后即移除,不支持重复消费和消费者组。
- 适用场景:Stream适合可靠消息队列,List适合简单任务队列。
15. 简述Redis的跳跃表(Skip List)原理及在ZSet中的应用
- 原理:多层有序链表,每层以一定概率向上提升,查询/插入/删除平均时间复杂度O(logN)。
- ZSet应用:当元素数量大于
zset-max-ziplist-entries或元素长度大于zset-max-ziplist-value时,底层从压缩列表转为跳跃表+哈希表的组合。
16. Redis的ACL(访问控制列表)是什么?
- 6.0引入:支持多用户、细粒度权限控制。
- 功能:为不同用户分配不同命令权限、key模式权限、频道权限。
- 命令:
ACL SETUSER、ACL LIST、ACL CAT等。
三、架构与运维篇(第17-22题)
17. Redis Cluster扩容/缩容时数据如何迁移?
- 使用
redis-cli --cluster reshard:将指定数量的哈希槽从源节点迁移到目标节点。 - 迁移过程:源节点将槽位对应的key逐⼀
MIGRATE到目标节点,期间客户端可能收到ASK重定向。 - 缩容:先将待下线节点的槽迁移到其他节点,再执行
CLUSTER FORGET移除节点。
18.(重点) 如何保证缓存与数据库的数据一致性?
- 常见方案:
- Cache-Aside(旁路缓存):更新时先更新DB,再删除缓存(删除优于更新)
- 延迟双删:先删缓存 → 更新DB → 延迟再删一次缓存
- 订阅Binlog(Maxwell):监听MySQL变更日志,异步更新缓存
- 注意:强一致性场景建议不缓存或使用分布式事务(如TCC)。
19. Redis内存碎片是如何产生的?如何清理?
- 产生原因:频繁的更新和删除操作、不同大小对象的分配释放。
- 查看:
INFO memory中的mem_fragmentation_ratio(>1.5表示碎片严重)。 - 清理:
- 重启实例(最彻底)
- 使用
MEMORY PURGE(仅对jemalloc有效) - 调整
activedefrag配置开启自动碎片整理(4.0+)。
20. Redis的INFO命令中你最关注哪些指标?
- Server:
uptime_in_seconds、redis_version - Clients:
connected_clients、blocked_clients(阻塞客户端数) - Memory:
used_memory_rss、mem_fragmentation_ratio - Persistence:
rdb_last_bgsave_status、aof_last_write_status - Stats:
total_commands_processed、keyspace_hits/misses(缓存命中率) - Replication:
master_link_status、master_last_io_seconds_ago - CPU:
used_cpu_sys、used_cpu_user
21.(重点) 如何设计一个高可用的Redis架构?
- 单机房:主从+哨兵(3哨兵+1主2从)
- 跨机房:Redis Cluster(至少6节点:3主3从)+ 异地多活(双写/同步工具如Redis-Shake)
- 容灾策略:跨机房部署、定期全量备份到对象存储、限流+降级保护
22. Redis的SLOWLOG如何配置和使用?
- 配置:
slowlog-log-slower-than 10000(10ms以上记录,单位微秒) - 查看:
SLOWLOG GET N获取最近N条慢查询 - 分析:关注
cmd(命令)、duration(耗时)、key(涉及的key),定位Big Key或复杂命令(如KEYS *、HGETALL大Hash)
四、场景实战篇(第23-30题)
23.(重点) 场景:如何用Redis实现一个高性能的分布式锁?有哪些坑?
- 实现方案:
- SET NX PX:
SET lock_key random_value NX PX 30000(原子性设置锁+过期时间) - 释放:使用Lua脚本校验
random_value一致后再删除,防止误删他人锁
- SET NX PX:
- 坑与解决方案:
- 锁过期业务未完成 → 使用Redisson看门狗自动续期
- 主从切换锁丢失 → 使用Redlock(多节点多数派加锁)
- 不可重入 → 使用Hash结构存储重入计数
24. 场景:如何用Redis实现一个延迟队列?
- 方案一(ZSet):将任务ID作为member,执行时间戳作为score,消费者轮询
ZRANGEBYSCORE key 0 now LIMIT 0 1获取到期任务,处理成功后ZREM移除。 - 方案二(Keyspace Notifications):利用key过期事件,但不保证准时且可能丢消息。
- 方案三(Redisson延迟队列):基于ZSet + List封装,生产环境推荐。
25.(重点) 场景:缓存穿透、缓存击穿、缓存雪崩分别是什么?如何应对?
| 问题 | 定义 | 解决方案 |
|---|---|---|
| 穿透 | 查询不存在的数据,绕过缓存直击DB | 布隆过滤器、缓存空值(短过期) |
| 击穿 | 热点key过期,大量请求同时打到DB | 互斥锁(SETNX)、逻辑过期(不设置物理过期,后台异步更新) |
| 雪崩 | 大量key同时过期,或Redis宕机 | 过期时间加随机值、主从+哨兵高可用、服务熔断降级 |
26.(重点) 场景:排行榜系统如何设计?如何实现实时更新?
- 数据结构:使用ZSet,member为用户ID,score为积分。
- 操作:
- 更新:
ZINCRBY rank:2026 10 user:123 - 查Top N:
ZREVRANGE rank:2026 0 9 WITHSCORES - 查排名:
ZREVRANK rank:2026 user:123
- 更新:
- 分页:
ZREVRANGE ... LIMIT offset count - 多维度排行:使用多个ZSet或组合score(如
积分*10^8 + 时间戳)。
27.(重点) 场景:秒杀系统中Redis如何设计?
- 库存扣减:使用String
DECR原子递减,返回剩余库存 - 防超卖:
DECR后判断 >=0 才下单 - 限流:使用令牌桶(
INCR+ 过期时间)或漏斗算法限制用户请求频率 - 下单去重:使用Set记录已秒杀成功的用户ID
- 异步落库:秒杀成功后将订单信息写入Stream/List,由消费者异步写入DB
28. 场景:如何用Redis实现用户签到/连续签到统计?
- 使用Bitmap:每个用户一个key(如
sign:2026:user:123),第N天签到则将第N位设为1。 - 签到:
SETBIT sign:2026:user:123 100 1 - 查询当天:
GETBIT sign:2026:user:123 100 - 统计本月签到天数:
BITCOUNT sign:2026:user:123 0 30 - 连续签到:从昨天开始逐天向前
GETBIT检查
29. 场景:百万级数据导入Redis如何高效处理?
- 使用Pipeline:批量发送命令,减少RTT
- 使用
redis-cli --pipe:将数据格式化为Redis Protocol批量导入,速度最快 - 禁用持久化:导入期间临时关闭AOF和RDB,导入完成后再开启并执行
BGSAVE - 调整内存策略:临时关闭
maxmemory限制 - 分批导入:按key前缀分批,避免单次操作过大
30. 场景:线上Redis出现OOM(内存溢出)或连接数爆满,如何紧急处理?
- OOM处理:
- 查看
INFO memory确认内存使用情况 - 调整
maxmemory-policy为allkeys-lru或volatile-lru允许自动淘汰 - 紧急扩容:增加内存或水平扩展集群节点
- 清理Big Key:使用
SCAN+UNLINK异步删除
- 查看
- 连接数爆满:
- 查看
INFO clients确认connected_clients - 调整
maxclients配置(需重启) - 检查客户端是否有连接泄漏(未正确释放连接)
- 紧急重启Redis释放所有连接(有数据丢失风险,需评估)
- 查看
数据类型
Redis支持哪些数据类型?分别适用于什么场景?
| 类型 | 底层实现 | 典型场景 |
|---|---|---|
| String | SDS | 缓存对象、计数器、分布式锁 |
| Hash | 压缩列表/哈希表 | 存储对象(如用户信息) |
| List | 压缩列表/链表 | 消息队列、最新消息列表 |
| Set | 整数集合/哈希表 | 标签系统、共同好友、抽奖 |
| ZSet | 压缩列表/跳跃表 | 排行榜、延迟队列、带权重的任务调度 |
| Bitmap | String | 签到统计、在线状态 |
| HyperLogLog | 特殊结构 | UV统计(基数估算) |
| GEO | ZSet | 附近的人、地理位置计算 |
| Stream | 消息队列 | 持久化消息队列(类似Kafka) |
过期删除策略与内存淘汰机制
简述Redis的过期删除策略与内存淘汰机制
- 过期删除:惰性删除(访问时检查过期)+ 定期删除(每100ms随机抽取一批设置过期时间的key检查)。
- 内存淘汰(8种策略):
noeviction:内存不足时返回错误(默认)allkeys-lru/volatile-lru:LRU淘汰 最近最少使用allkeys-lfu/volatile-lfu(4.0+):LFU淘汰 最不经常使用allkeys-random/volatile-random:随机淘汰volatile-ttl:淘汰即将过期的key
Hot Key和Big Key
什么是Redis的Hot Key和Big Key?如何解决?
- Hot Key:高频访问的key。解决方案:本地缓存、读写分离、key拆分成多个子key分散压力。
- Big Key:value过大的key(如超大Hash/Set/ZSet)。危害:慢查询、网络阻塞、集群迁移困难。解决方案:拆分大key、使用
UNLINK异步删除、SCAN渐进式遍历。
如何保证缓存与数据库的数据一致性
如何保证缓存与数据库的数据一致性?
- 常见方案:
- Cache-Aside(旁路缓存):更新时先更新DB,再删除缓存(删除优于更新)
- 延迟双删:先删缓存 → 更新DB → 延迟再删一次缓存
- 订阅Binlog(Maxwell):监听MySQL变更日志,异步更新缓存
- 注意:强一致性场景建议不缓存或使用分布式事务(如TCC)。
如何设计一个高可用的Redis架构
如何设计一个高可用的Redis架构?
- 单机房:主从+哨兵(3哨兵+1主2从)
- 跨机房:Redis Cluster(至少6节点:3主3从)+ 异地多活(双写/同步工具如Redis-Shake)
- 容灾策略:跨机房部署、定期全量备份到对象存储、限流+降级保护
如何用Redis实现一个高性能的分布式锁?有哪些坑?
如何用Redis实现一个高性能的分布式锁?有哪些坑?
- 实现方案:
- SET NX PX:
SET lock_key random_value NX PX 30000(原子性设置锁+过期时间) - 释放:使用Lua脚本校验
random_value一致后再删除,防止误删他人锁
- SET NX PX:
- 坑与解决方案:
- 锁过期业务未完成 → 使用Redisson看门狗自动续期
- 主从切换锁丢失 → 使用Redlock(多节点多数派加锁)
- 不可重入 → 使用Hash结构存储重入计数
缓存穿透、缓存击穿、缓存雪崩分别是什么?如何应对?
缓存穿透、缓存击穿、缓存雪崩分别是什么?如何应对?
| 问题 | 定义 | 解决方案 |
|---|---|---|
| 穿透 | 查询不存在的数据,绕过缓存直击DB | 布隆过滤器、缓存空值(短过期) |
| 击穿 | 热点key过期,大量请求同时打到DB | 互斥锁(SETNX)、逻辑过期(不设置物理过期,后台异步更新) |
| 雪崩 | 大量key同时过期,或Redis宕机 | 过期时间加随机值、主从+哨兵高可用、服务熔断降级 |
排行榜系统如何设计?如何实现实时更新?
排行榜系统如何设计?如何实现实时更新?
- 数据结构:使用ZSet,member为用户ID,score为积分。
- 操作:
- 更新:
ZINCRBY rank:2026 10 user:123 - 查Top N:
ZREVRANGE rank:2026 0 9 WITHSCORES - 查排名:
ZREVRANK rank:2026 user:123
- 更新:
- 分页:
ZREVRANGE ... LIMIT offset count - 多维度排行:使用多个ZSet或组合score(如
积分*10^8 + 时间戳)。
秒杀系统中Redis如何设计
秒杀系统中Redis如何设计?
- 库存扣减:使用String
DECR原子递减,返回剩余库存 - 防超卖:
DECR后判断 >=0 才下单 - 限流:使用令牌桶(
INCR+ 过期时间)或漏斗算法限制用户请求频率 - 下单去重:使用Set记录已秒杀成功的用户ID
- 异步落库:秒杀成功后将订单信息写入Stream/List,由消费者异步写入DB
RedLock
一、诞生原因 普通主从 Redis 锁有漏洞:主节点加锁后宕机,锁没同步到从库,新主无锁,多线程同时持有锁,数据错乱。 二、部署 5 台完全独立、无主从关系的 Redis 节点。 三、抢锁逻辑 依次向 5 台 Redis 加锁; 超过半数(≥3 台)加锁成功,且抢锁耗时短于锁过期时间,才算拿到锁; 失败则清空所有节点锁,重试。 四、释放锁 向全部 5 台节点执行校验脚本,只删除自己持有的锁。 五、优缺点 优点:单节点宕机不丢锁,安全性更高。 缺点: 要请求多台 Redis,性能差; 强依赖服务器时钟,时间错乱会失效; 部署维护成本高; 无法解决业务超时锁过期问题,仍需看门狗续期。 六、使用场景 仅金融、库存扣减等零容错核心业务使用;普通业务直接用 Redisson 单机锁即可,配合数据库乐观锁兜底。
redis常见命令
一、通用基础命令(所有数据结构共用)
客户端连接
redis-cli                                    # 本地默认6379端口连接
redis-cli -h 127.0.0.1 -p 6379 -a 123456     # 指定地址、端口、密码连接
redis-cli --raw                              # 解决控制台中文乱码
数据库操作(默认0~15共16个库)
select 1                          # 切换至1号数据库
dbsize                            # 查看当前库key总数量
flushdb                           # 清空当前数据库(谨慎使用)
flushall                          # 清空所有数据库(高危命令)
Key 全局操作
keys *                            # 查询全部key,线上禁止使用,阻塞主线程
scan 0 match user* count 100      # 安全迭代遍历key,0代表游标起点
exists key_name                   # 判断key是否存在,返回1存在/0不存在
del key1 key2 key3                # 同步删除key,大key会阻塞
unlink key_name                   # 异步删除key,推荐删除大key使用
expire key 30                     # 设置key过期时间30秒
pexpire key 30000                 # 设置key过期时间30000毫秒
ttl key                           # 查看剩余过期秒数,-1永不过期,-2已失效
persist key                       # 移除key过期时间,永久保存
rename old_key new_key            # key重命名
type key_name                     # 查看key对应数据结构类型
memory usage key_name             # 查看单个key占用内存大小
randomkey                         # 随机返回库中一个key
二、String 字符串(缓存、计数器、分布式锁)
写入命令
set name zhangsan                 # 基础赋值,覆盖原有值
set lock uuid nx ex 10            # 原子分布式锁:不存在才创建,10秒过期
setex token 1800 abc123           # 等价 set key val ex time
mset k1 v1 k2 v2 k3 v3            # 批量写入多个键值对
查询命令
get name
mget k1 k2 k3                     # 批量读取多个key
strlen name                       # 获取字符串字符长度
自增/自减(高并发计数:点赞、库存、ID)
incr num                          # 数字+1
incrby num 10                     # 数字+10
decr num                          # 数字-1
decrby num 5                      # 数字-5
字符串截取、追加
append name "_vip"                # 字符串尾部追加内容
getrange name 0 2                 # 截取下标0~2字符
setrange name 4 test              # 从下标4位置覆盖写入内容
三、Hash 哈希(存储对象:用户、商品信息)
单字段操作
hset user:1 id 1001 name lisi age 22
hget user:1 name
hexists user:1 age                # 判断哈希内某个字段是否存在
批量字段操作
hmset user:2 id 1002 name wangwu sex male
hmget user:2 name age sex
读取全部数据
hgetall user:1                    # 获取哈希所有字段与值,字段过多慎用
hkeys user:1                      # 只获取哈希所有字段名
hvals user:1                      # 只获取哈希所有字段值
hlen user:1                       # 获取哈希字段总数量
数字自增
hincrby user:1 age 1 # age字段数值+1删除字段
hdel user:1 sex四、List 列表(有序可重复,消息队列、栈、分页)
底层 quicklist,左侧为头,右侧为尾
插入数据
lpush list a b c                  # 头部插入(栈结构)
rpush list d e f                  # 尾部插入(队列结构)
查询数据
lrange list 0 -1                  # 查看列表全部元素
lindex list 2                     # 获取下标为2的元素
llen list                         # 获取列表长度
弹出消费
lpop list                         # 左侧弹出元素
rpop list                         # 右侧弹出元素
blpop list 10                     # 阻塞左侧弹出,超时10秒返回nil
修改、裁剪、删除
lset list 1 test                  # 修改下标1位置元素值
lrem list 1 a                     # 删除列表中1个值为a的元素
ltrim list 0 5                    # 只保留下标0~5的元素,其余全部删除
五、Set 集合(无序、不可重复,点赞、标签、好友交集)
添加、查询、判断
sadd article:1:like 10001 10002 10003
smembers article:1:like           # 查询集合全部成员
sismember article:1:like 10001    # 判断用户是否点赞
scard article:1:like              # 获取集合元素总数(点赞总数)
srem article:1:like 10001         # 取消点赞,删除指定成员
spop set1                         # 随机弹出集合一个元素
集合运算(共同好友、共同标签)
sinter set1 set2                  # 交集:两边同时存在的元素
sunion set1 set2                  # 并集:合并两个集合并去重
sdiff set1 set2                   # 差集:仅存在于第一个集合的元素
六、ZSet 有序集合(排行榜、延时队列、滑动窗口限流)
score 分数排序,成员唯一
添加数据
zadd score_rank 95 user01 88 user02 99 user03榜单查询
zrevrange score_rank 0 -1 withscores  # 倒序榜单(分数从高到低,业务常用)
zrange score_rank 0 -1 withscores     # 正序榜单(分数从低到高)
zcard score_rank                      # 有序集合总人数
zscore score_rank user01              # 获取指定用户分数
zrank score_rank user01               # 获取正序排名
zrevrank score_rank user01            # 获取倒序排名
分数增减
zincrby score_rank 5 user01 # 用户分数 +5删除操作
zrem score_rank user01
zremrangebyrank score_rank 0 10       # 删除排名0~10的元素
zremrangebyscore score_rank 0 60      # 删除分数0~60区间元素
按分数区间筛选
zrangebyscore score_rank 80 100 withscores七、Stream 消息队列(Redis5.0+ 可靠消息,支持 ACK 确认)
生产消息
xadd msg_queue * username zhang age 25   # *自动生成唯一消息ID
xlen msg_queue                           # 获取队列消息总数量
基础消费
xread count 2 streams msg_queue $        # $代表读取新消息
xread block 5000 count 1 streams msg_queue $   # 阻塞消费5秒
消费者组(保证消息不丢失、手动ACK)
xgroup create msg_queue group1 0 mkstream    # 创建消费组,无队列自动创建
xreadgroup group group1 consumer1 count 1 streams msg_queue >
xack msg_queue group1 1720000000000-01       # 确认消息消费完成
八、持久化 & 运维监控命令
RDB 快照持久化
save                    # 同步生成RDB文件,阻塞主线程,线上禁用
bgsave                  # 后台子进程异步生成RDB快照(推荐)
lastsave                # 返回最近一次生成RDB的时间戳
AOF 日志持久化
bgrewriteaof # 手动触发AOF重写,压缩日志文件服务监控
info                    # 输出全量运行信息(内存、持久化、集群、主从)
info memory             # 单独查看内存使用、内存碎片率
info replication        # 查看主从复制状态
info server             # Redis版本、运行时长、端口等基础信息
slowlog get 10          # 查询最近10条慢查询日志
client list             # 查看所有客户端连接信息
client kill 127.0.0.1:51230   # 强制断开指定客户端连接
配置操作
config get maxmemory    # 查询内存最大限制配置
config set maxmemory 2G # 动态修改内存上限,无需重启服务
九、主从复制 / 哨兵 / Cluster 集群命令
9.1 主从复制
replicaof 127.0.0.1 6379    # 将当前节点设置为指定主节点的从库
replicaof no one            # 取消主从复制,升级为独立主节点
9.2 Redis Cluster 集群
cluster info                # 集群整体运行状态
cluster nodes               # 查看集群所有节点、角色、槽分配
cluster slots               # 16384哈希槽分配详情
cluster keyslot test_key    # 查询key所属哈希槽编号
cluster meet 127.0.0.1 6380 # 将新节点加入集群握手
十、事务 & Lua 脚本(分布式锁原子操作必备)
Redis 事务 MULTI/EXEC
multi                 # 开启事务
set a 10
incr a
exec                  # 批量执行事务内所有命令
discard               # 放弃本次事务,取消所有命令
Lua 脚本原子执行
#### 基础读取示例
eval "return redis.call('get',KEYS[1])" 1 demo_key

#### 分布式锁安全释放脚本(匹配唯一标识再删除,防止误删他人锁)
eval "if redis.call('get',KEYS[1]) == ARGV[1] then return redis.call('del',KEYS[1]) else return 0 end" 1 lock:order uuid_123456
十一、线上使用避坑要点(补充)
- 禁止生产环境执行
keys *,海量 key 会阻塞整个 Redis;遍历使用scan/sscan/hscan/zscan。 - 删除大 key 优先使用
unlink,同步del会阻塞主线程。 - 哈希、有序集合数据量大时,禁止一次性
hgetall/zrange 0 -1,使用scan迭代分页读取。 - 分布式锁必须使用
set key val nx ex time原子命令,分开setnx+expire会产生死锁。 - 批量读写尽量使用
mset/mget,减少网络往返次数,提升性能。
MQ
1.RabbitMQ 的核心组件有哪些?
RabbitMQ的核心组件包括以下几部分,他们共同构成了 RabbitMQ 的基本架构:
- Broker:RabbitMQ服务器,负责接收和分发消息的应用。
- Virtual Host:虚拟主机,是RabbitMQ中的逻辑容器,用于隔离不同环境或不同应用程序的信息流。每个虚拟主机都有自己的队列、交换机等设置,可以理解为一个独立的RabbitMQ服务。
- Connection 连接:管理和维护与RabbitMQ服务器的TCP连接,生产者、消费者通过这个连接和 Broker 建立物理网络连接。
- Channel通道:是在Connection 内创建的轻量级通信通道,用于进行消息的传输和交互。应用程 序通过Channel进行消息的发送和接收。通常一个 Connection 可以建立多个 Channel。
- Exchange交换机:交换机是消息的中转站,负责接收来自生产者的消息,并将其路由到一个或多 个队列中。RabbitMQ 提供了多种不同类型的交换机,每种类型的交换机都有不同的消息路由规 则。
- Queue队列:队列是消息的存储位置。每个队列都有一个唯一的名称。消息从交换机路由到队列, 然后等待消费者来获取和处理。
- Binding绑定关系: Binding 是 Exchange 和 Queue 之间的关联规则,定义了消息如何从交换机路由到特定的队列。 此外,生产者和消费者也是RabbitMQ的核心组件,生产者负责发送消息到Exchange或者 Queue,消费者负责从Queue中订阅和处理消息。 这些核心组件共同构建了 RabbitMQ 的消息传递系统,他们协同工作才能实现消息的可靠传递、路和 业务处理等功能。
自由主题
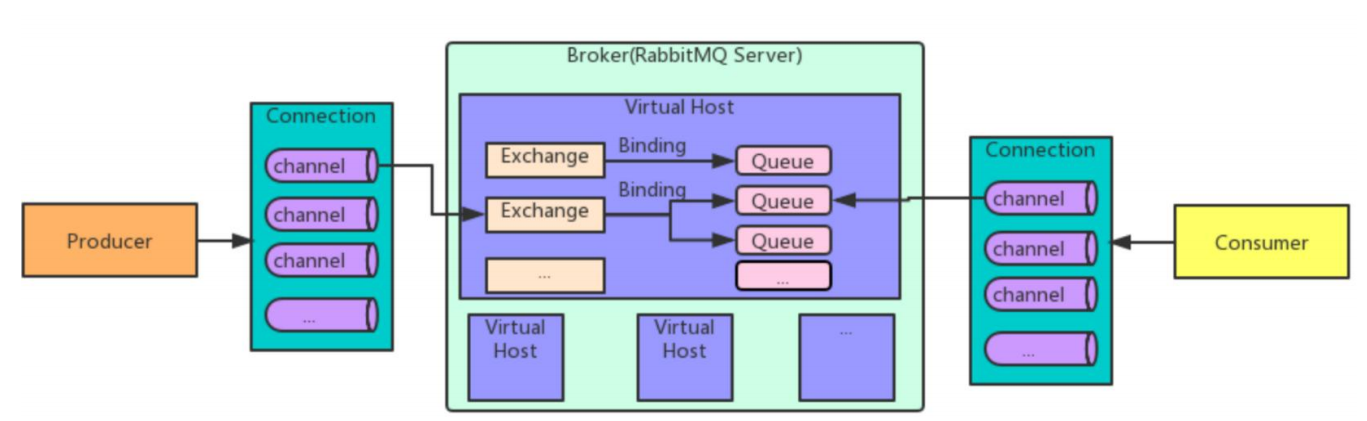
2.RabbitMQ 和 AMQP 是什么关系?
RabbitMQ 和 AMQP 有着非常密切的关系,但是他们是属于完全不同的两个概念。 AMQP: AMQP 不是一个具体的消息中间件产品,而是一个协议规范。他是一个开放的消息产地 协议,是一种应用层的标准协议,为面向消息的中间件设计。AMQP 提供了一种统一的消息服务, 使得不同程序之间可以通过消息队列进行通信。 SpringBoot 框架默认就提供了对 AMQP 协议的支 持。 RabbitMQ:RabbitMQ则是一个开源的消息中间件,是一个具体的软件产品。RabbitMQ 使用 AMQP 协议来实现消息传递的标准,但其实他也支持其他消息传递协议,如 STOMP 和 MQTT。 RabbitMQ 基于 AMQP 协议定义的消息格式和交互流程,实现了消息在生产者、交换机、队列之 间的传递和处理。 总之,AMQP 本质上是一个开放的标准,他不光可以被 RabbitMQ 实现,也可以被其他产品实现。通过 这种标准的协议,实际上是可以在不同的消息中间件系统之间进行灵活的消息传递。只不过,目前具体 实现这种标准的产品目前并不多,RabbitMQ 则是最有影响力的一个产品。因此,RabbitMQ 成了 AMQP 协议事实上的代表。SpringBoot 框架默认提供的 AMQP 协议支持底层也是基于 RabbitMQ 产品 实现的。
3.RabbitMQ 如何实现消息的持久化?
RabbitMQ 允许消息的持久化,以确保即使在 RabbitMQ 服务器重新启动后,消息也不会丢失。 RabbitMQ 可以通过以下方式实现消息的持久化:
- 消息持久化:在 RabbitMQ 中,只需要在发送消息时,将delivery_mode属性设置为 2,就可以将消息标记为持久化。
- 队列持久化:在 RabbitMQ 中声明队列时,也可以将队列声明为持久化。RabbitMQ 中的队列分为三种不同类型经典队列,仲裁队列和流式队列。其中,经典队列需要将durable属性设置为true。 而仲裁队列和流式队列默认必须持久化保存。
- 交换机持久化:与经典队列类似,RabbitMQ 也可以在声明交换机时,将交换机的 durable 属性设置为true,这样就可以将交换机标记为持久化。 RabbitMQ 的持久化机制会对其性能产生影响。因此,需要根据具体的业务场景和需求来权衡是否需要 持久化以及需要哪种类型的持久化。
4.RabbitMQ 是如何实现死信队列的?
死信队列是 RabbitMQ 提供的一种特殊序列,处理那些无法被正常消费的消息。有三种情况会产生死 信: 1.消息被消费者明确拒绝,并且重新入队等于false。 2.消息达到预设的过期时间仍没有消费者消费。 3.消息由于队列已经达到最大长度限制而被丢弃。 在 RabbitMQ 中,实现死信队列只需要给正常队列增加三个核心参数即可:
- dead-letter-exchange:指定当前队列对应的死信队列
- dead-letter-routing-key:指定消息转入死信队列时的路由键
- message-ttl:消息在队列中的过期时间。 接下来,就可以往正常队列中发送消息。如果消息满足了某些条件,就会成为死信,并被重新发送到对 应的死信队列中。而此时,RabbitMQ 会在消息的头部添加一些与死信相关的补充信息,例如时间、成 为死信的原因、原队列等。应用程序可以按需处理这些补充的信息。 最后,死信队列中的消息都是正常业务处理失败的消息,应用程序需要创建一个消费者来专门处理这些 被遗漏的消息。例如记录日志、发送警报等。这样才能保证业务数据的完整性。
5.RabbitMQ 支持哪些消息模式?
RabbitMQ是一种流行的消息中间件,它支持多种工作模式,以满足不同的消息传递需求。以下是 RabbitMQ中常见的几种工作模式:
- 简单模式(Simple Queue): 也被称为点对点模式。 在这种模式下,有一个生产者(Producer)将消息发送到队列(Queue),然后有一个消费 者(Consumer)从队列中接收和处理消息。 应用场景: 将发送的电子邮件放到消息队列,然后邮件服务在队列中获取邮件并发送给收件人 2.工作队列模式(Work queues) 在多个消费者之间分配任务(竞争的消费者模式),一个生产者对应多个消费者,一般适用于执行资源 密集型任务,单个消费者处理不过来,需要多个消费者进行处理。 应用场景: 一个订单的处理需要10s,有多个订单可以同时放到消息队列,然后让多个消费者同时处 理,这样就是并行了,而不是单个消费者的串行情况。 3.发布订阅模式(Publish/Subscribe) 一次向许多消费者发送消息,一个生产者发送的消息会被多个消费者获取,也就是将消息将广播到所有 的消费者中。 应用场景: 更新商品库存后需要通知多个缓存和多个数据库,这里的结构应该是: 一个fanout类型交换机扇出两个个消息队列,分别为缓存消息队列、数据库消息队列 一个缓存消息队列对应着多个缓存消费者 一个数据库消息队列对应着多个数据库消费者 4、路由模式(Routing) 有选择地(Routing key)接收消息,发送消息到交换机并且要指定路由key ,消费者将队列绑定到交换 机时需要指定路由key,仅消费指定路由key的消息 应用场景: 如在商品库存中增加了1台iphone12,iphone12促销活动消费者指定routing key为 iphone12,只有此促销活动会接收到消息,其它促销活动不关心也不会消费此routing key的消息。 5、主题模式(Topics) 根据主题(Topics)来接收消息,将路由key和某模式进行匹配,此时队列需要绑定在一个模式上,#匹 配一个词或多个词,*只匹配一个词。 应用场景: 同上,iphone促销活动可以接收主题为iphone的消息,如iphone12、iphone13等。 6、发布者确认(Publisher Confirms) 与发布者进行可靠的发布确认,发布者确认是RabbitMQ扩展,可以实现可靠的发布。在通道上启用发 布者确认后,RabbitMQ将异步确认发送者发布的消息。 应用场景: 对于消息可靠性要求较高,比如钱包扣款。而一旦我们使用了消息队列,我们基本都要保证 消息的百分百投递,因此建议使用的时候尽量选择该模式。 7、RPC(这种模式用的很少)
简单模式(Simple Queue)
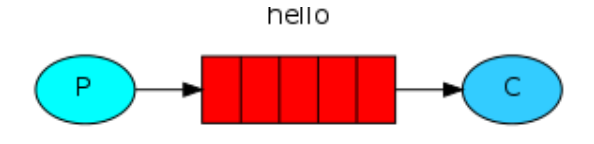
工作队列模式(Work queues)
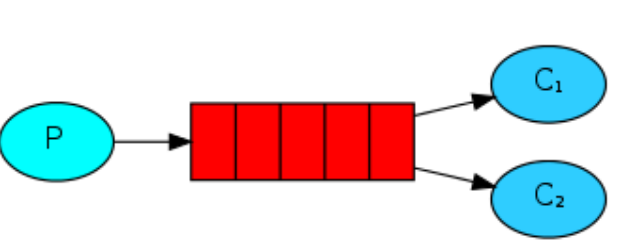
发布订阅模式(Publish/Subscribe)
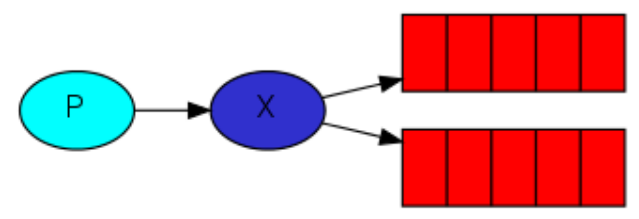
路由模式(Routing)
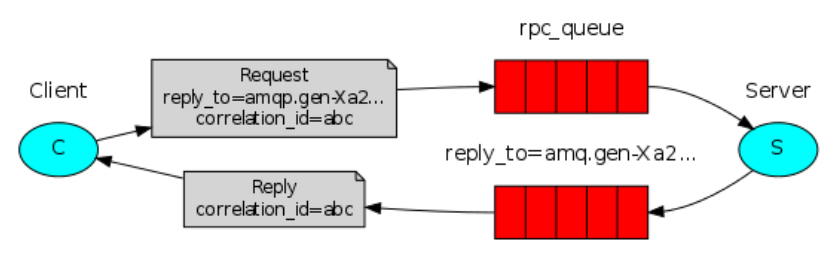
主题模式(Topics)
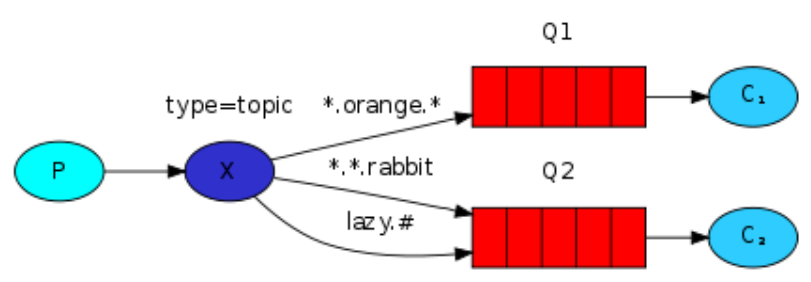
发布者确认(Publisher Confirms)
6.RabbitMQ 中如何进行事务处理?
通过对信道的设置实现
- channel.txSelect();通知服务器开启事务模式;服务端会返回Tx.Select-Ok
- channel.basicPublish;发送消息,可以是多条,可以是消费消息提交ack
- channel.txCommit()提交事务;
- channel.txRollback()回滚事务; 消费者使用事务:
- autoAck=false,手动提交ack,以事务提交或回滚为准;
- autoAck=true,不支持事务的,也就是说你即使在收到消息之后在回滚事务也是于事无补的,队列 已经把消息移除了 如果其中任意一个环节出现问题,就会抛出IoException异常,用户可以拦截异常进行事务回滚,或决定 要不要重复消息。事务消息会降低rabbitmq的性能。
7. RabbitMQ 中有哪几种交换机类型?
RabbitMQ 支持多种交换机(Exchange)类型,每种类型都用于不同的消息路由和分发策略:
- Direct Exchange:(直连) 这种交换机根据消息的路由键(Routing Key)将消息发送到与之完全匹配的队列。只有当消息的路由键与队列绑定时指定的路由键完全相同时,消息才会被路由到队列。这是一种简单的路由策略,适用于点对点通信。
- Topic Exchange:(主题) 这种交换机根据消息的路由键与队列绑定时指定的路由键模式(通配符)匹配程度,将消息路由到一个 或多个队列。路由键可以使用通配符符号 *(匹配一个单词)和 #(匹配零个或多个单词),允许更灵 活的消息路由。用于发布/订阅模式和复杂的消息路由需求。
- Fanout Exchange:(广播) 这种交换机将消息广播到与之绑定的所有队列,无论消息的路由键是什么。用于发布/订阅模式,其中一 个消息被广播给所有订阅者。
- Default Exchange:(默认) 这是 RabbitMQ 默认实现的一种交换机,它不需要手动创建。当消息发布到默认交换机时,路由键会被解释为队列的名称,消息会被路由到与路由键名称相同的队列。默认交换机通常用于点对点通信,但不支持复杂的路由策略。
//3. Headers Exchange:(头部) 这种交换机根据消息的标头信息(Headers)来决定消息的路由,而不是使用路由键。队列和交换机之 间的绑定规则是根据标头键值对来定义的,只有当消息的标头与绑定规则完全匹配时,消息才会被路由 到队列。适用于需要复杂消息匹配的场景。
8.RabbitMQ如何保证消息可靠
1.交换机持久化 2.队列持久化 3.消息持久化:消息在发送前存一份在数据库,有一个列代表状态status=0,当生产者发送给交换机 将status=1(生产者确认)消费者消费以后把status从1改2就算完成整个链路。 4.生产者确认 5.消费者确认
丢失原因分析 观察整个 RabbitMQ 消息发送过程: 从上述流程我们可以得知:消息从生产者到达消费者,经过两次网络传输,并且在 RabbitMQ 服务器中进行路由。 因此我们能知道整个流程中可能会出现三种消息丢失场景: 1.生产者发送消息到 RabbitMQ 服务器的过程中出现消息丢失。 可能是网络波动未收到消息,又或 者是服务器宕机。 2.RabbitMQ 服务器消息持久化出现消息丢失。 消息发送到 RabbitMQ 之后,未能及时存储完成持 久化,RabbitMQ 服务器出现宕机重启,消息出现丢失。 3.消费者拉取消息过程以及拿到消息后出现消息丢失。 消费者从 RabbitMQ 服务器获取到消息过程 出现网络波动等问题可能出现消息丢失;消费者拿到消息后但是消费者未能正常消费,导致丢失, 可能是消费者出现处理异常又或者是消费者宕机。
针对上述三种消息丢失场景,RabbitMQ 提供了相应的解决方案,confirm 消息确认机制(生产者), 消息持久化机制(RabbitMQ 服务),ACK 事务机制(消费者) 解决方案 confirm 消息确认机制(生产者) Confirm 模式是 RabbitMQ 提供的一种消息可靠性保障机制。当生产者通过 Confirm 模式发送消息时, 它会等待 RabbitMQ 的确认,确保消息已经被正确地投递到了指定的 Exchange 中。 消息正确投递到 queue 时,会返回 ack。 消息没有正确投递到 queue 时,会返回 nack。如果 exchange 没有绑定 queue,也会出现消息丢失。 使用方法: 生产者通过 confirm.select 方法将 Channel 设置为 Confirm 模式。 发送消息后,通过添加 add_confirm_listener 方法,监听消息的确认状态
消息持久化机制(RabbitMQ 服务) 持久化机制是指将消息存储到磁盘,以保证在 RabbitMQ 服务器宕机或重启时,消息不会丢失。 使用方法: 生产者通过将消息的 delivery_mode 属性设置为 2(SpringBoot中deliveryMode默认为 MessageDeliveryMode.PERSISTENT 等于2),将消息标记为持久化。 队列也需要进行持久化设置,确保队列在 RabbitMQ 服务器重启后仍然存在。需要将durable属性 设置为true,且需配合autoDelete设置为false 注意事项: 持久化机制会影响性能,因此在需要确保消息不丢失的场景下使用。
ACK 事务机制(消费者) ACK 事务机制用于确保消息被正确消费。当消息被消费者成功处理后,消费者发送确认(ACK)给 RabbitMQ,告知消息可以被移除。这个过程是自动处理的,也可以关闭进行手工发送 ACK。 使用方法: 在 RabbitMQ 中,ACK 机制默认是开启的。当消息被消费者接收后,会立即从队列中删除,除非 消费者发生异常。 可以手动开启 ACK 机制,通过将 auto_ack 参数设置为 False,手动控制消息的 ACK (acknowledge-mode: manual)。 注意事项: ACK 机制可以确保消息不会被重复处理,但如果消费者发生异常或者未发送 ACK,消息可能会被重 复投递
9.RabbitMQ中如何解决消息堆积问题
解决方案
- 消费者处理消息的速度太慢 增加消费者数量:通过水平扩展,增加消费者的数量来提高处理能力。 优化消费者性能:提高消费者处理消息的效率,例如优化代码、增加资源。 消息预取限制(prefetch count):调整消费者的预取数量以避免一次处理过多消息而导致处 理缓慢。
- 队列的容量太小 增加队列的容量:调整队列设置以允许更多消息存储。
- 网络故障 监控和告警:通过监控网络状况并设置告警,确保在网络故障时快速发现并解决问题。 持久化和高可用性:确保消息和队列的持久化以避免消息丢失,并使用镜像队列提高可用性。
- 消费者故障 使用死信队列:将无法处理的消息转移到死信队列,防止堵塞主队列。 容错机制:实现消费者的自动重启和错误处理逻辑。
- 队列配置不当 优化队列配置:检查并优化消息确认模式、队列长度限制和其他相关配置。
- 消息大小 消息分片:将大型消息分割成小的消息片段,加快处理速度。
- 业务逻辑复杂或耗时 优化业务逻辑:简化消费者中的业务逻辑,减少处理每个消息所需的时间。
- 消息产生速度快于消费速度 使用消息限流:控制消息的生产速度,确保它不会超过消费者的处理能力。 负载均衡:确保消息在消费者之间公平分配,避免个别消费者过载。
- 其他配置优化 消息优先级:使用消息优先级确保高优先级消息优先处理。 调整RabbitMQ配置:优化RabbitMQ服务的配置,如文件描述符限制、内存使用限制等。
消息堆积原因
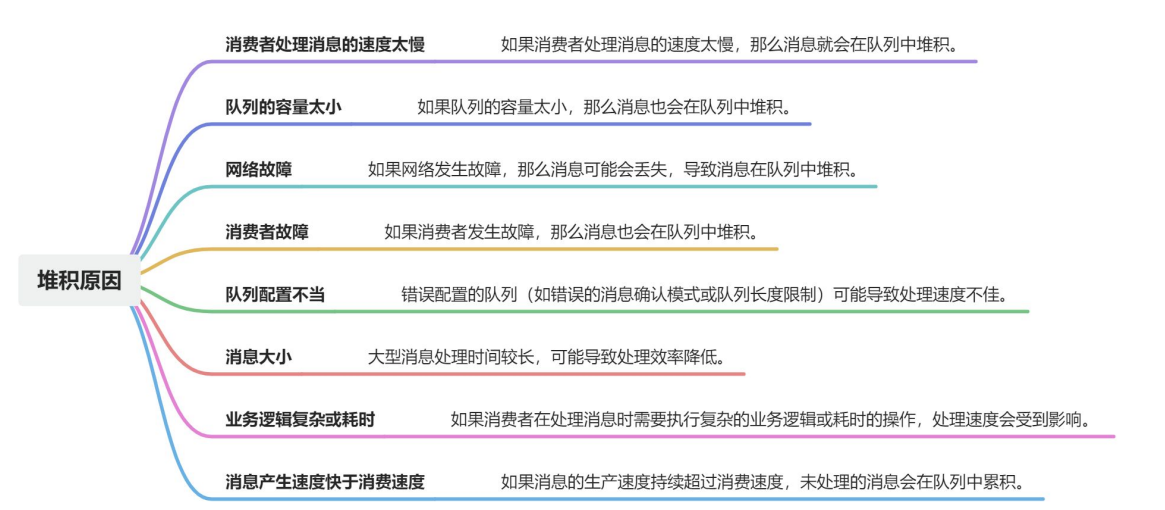
10.RabbitMQ中如何保证消息不被重复消费
1.redis做幂等性判断 2.数据库唯一约束
什么情况会导致消息被重复消费呢
- 生产者:生产者可能会重复推送一条数据到 MQ 中,比如 Controller 接口被重复调用了 2 次,没 有做接口幂等性导致的;
- MQ:在消费者消费完准备响应 ack 消息消费成功时,MQ 突然挂了,导致 MQ 以为消费者还未消 费该条数据,MQ 恢复后再次推送了该条消息,导致了重复消费。
- 消费者:消费者已经消费完消息,正准备但是还未响应给ack消息到时,此时消费者挂了,服务重 启后 MQ 以为消费者还没有消费该消息,再次推送了该条消息。 解决方案 使用数据库唯一键约束 缺点:局限性很大,仅仅只能用在我们数据新增场景,并且性能也比较低 使用乐观锁 假设是更新订单状态,在发送的消息的时候带上修改字段的版本号 缺点:如果说更新字段比较多,并且更新场景比较多,可能会导致数据库字段增加并且还有可能出现多 条消息同时在队列中此时他们修改字段版本号一致,排在后续的消息无法被消费 简单的消息去重,插入消费记录,增加数据库判断 优点:很多场景下的确能起到不错的效果 缺点:
- 这个消费者的代码执行需要1秒,重复消息在执行期间(假设100毫秒)内到达(例如生产者快速重 发,Broker重启等),增加校验的地方是不是还是没数据(因为上一条消息还没消费完,没有记 录)
- 那么就会穿透掉检查的挡板,最后导致重复的消息消费逻辑进入到非幂等安全的业务代码中,从而 引发重复消费的问题 并发消息去重基于消息幂等表 缺点:如果说第一次消息投递异常没有消费成功,并且没有将消息状态给置为成功或者没有删除消 息表记录,此时延时消费每次执行下列都是一直处于消费中,最后消费就会被视为消费失败而被投 递到死信Topic中 方案:插入的消息表必须要带一个最长消费过期时间,例如10分钟 上述方案只需要一个存储的中心媒介,那我们可以选择更灵活的存储中心媒介,比如Redis。使用 Redis有两个好处: 性能上损耗更低 上面我们讲到的超时时间可以直接利用Redis本身的ttl实现 总结
- 利用数据库唯一键约束
- 可以利用我们的乐观锁
- 插入消费记录 不丢和不重是矛盾的(在分布式场景下),总的来说,开发者根据业务的实际需求来选择相应的方式即 可。
11、RabbitMQ如何实现延迟消息?
RabbitMQ本身并不直接支持延迟消息的功能,但可以通过结合使用RabbitMQ的一些特性来实现延迟消 息的效果。下面介绍两种常见的实现方式:
- 利用消息的过期时间和死信队列(DLX):这种方式可以通过设置消息的过期时间来实现延迟消息 的效果。具体步骤如下: 创建一个普通的交换机和队列用于接收延迟消息。 设置队列的消息过期时间,可以通过设置队列的 x-message-ttl 参数或通过单独设置消息的 expiration 属性。 设置队列的死信交换机和死信路键,将过期的消息发送到指定的死信交换机和路由键。 创建一个死信交换机和队列,用于处理过期的消息。 将队列绑定到死信交换机上,指定合适的路由键。 发送延迟消息时,将消息发送到普通的交换机和队列。 消息会在指定的过期时间后发送到死信交换机和队列,从而实现延迟消息的效果。
- 使用RabbitMQ的延迟插件(rabbitmq_delayed_message_exchange):RabbitMQ社区提供了一个延迟插件,可以直接实现延迟消息的功能。具体步骤如下: 下载并安装rabbitmq_delayed_message_exchange插件。 启用延迟插件,通过RabbitMQ的管理界面或命令行工具进行配置。 创建一个延迟交换机和队列,将延迟插件应用到交换机上。 发送延迟消息时,将消息发送到延迟交换机和队列,同时设置消息的延迟时间。 延迟交换机会根据消息的延迟时间将消息发送到指定的目标队列,从而实现延迟消息的效果。 需要注意的是,以上两种方式都是通过消息的过期时间来实现延迟消息的,因此在使用时需要根据实际 需求和性能考虑合适的延迟时间设置。另外,延迟消息的实现可能会增加系统的复杂性和消息的处理延 迟,需要根据具体业务场景进行评估和选择。
12、RabbitMQ如何保证消息的顺序性?
单队列串行化 prefetch=1
消息队列中的若干消息如果是对同一个数据进行操作,这些操作具有前后的关系,必须要按前后的顺序 执行,否则就会造成数据异常。举例: 比如通过mysql binlog进行两个数据库的数据同步,由于对数据库的数据操作是具有顺序性的,如果操作顺序搞反,就会造成不可估量的错误。比如数据库对一条数据依次进行了 插入->更新->删除操作,这个顺序必须是这样,如果在同步过程中,消息的顺序变成了 删除->插入->更新,那么原本应该被删除的数据,就没有被删除,造成数据的不一致问题。
13、如何使用RabbitMQ解决分布式事务?
分布式事务:不同的服务操作不同的数据源(库或表),保证数据一致性的问题。 解决:采用RabbitMQ消息最终一致性的解决方案,解决分布式事务问题。 分布式事务场景: 1、电商项目中的商品库和ES库数据同步问题。 2、电商项目中:支付----订单---库存,一系列操作,进行状态更改等。 在互联网应用中,基本都会有用户注册的功能。在注册的同时,我们会做出如下操作: 收集用户录入信息,保存到数据库向用户的手机或邮箱发送验证码等等… 如果是传统的集中式架构,实现这个功能非常简单:开启一个本地事务,往本地数据库中插入一条用户 数据,发送验证码,提交事物。 但是在分布式架构中,用户和发送验证码是两个独立的服务,它们都有各自的数据库,那么就不能通过 本地事物保证操作的原子性。这时我们就需要用到 RabbitMQ(消息队列)来为我们实现这个需求。 在用户进行注册操作的时候,我们为该操作创建一条消息,当用户信息保存成功时,把这条消息发送到 消息队列。验证码系统会监听消息,一旦接受到消息,就会给该用户发送验证码
14.如何解决消息队列的延时以及过期失效问
题?消息队列满了之后该如何处理?有几百万的
消息持续积压几小时,说说如何解决?
1.11题答案 2.消息丢了,扫数据库里面的表状态,进行重发
方案分析 该问题,其本质针对的场景,都是说,可能你的消费端出了问题,不消费了,或者消费的极其极其慢。另外还有可能你的消息队列集群的磁盘都快写满了,都没人消费,这个时候怎么办?或者是整个这就积压了几个小时,你这个时候怎么办?或者是你积压的时间太长了,导致比如rabbitmq设置了消息过期时间后就没了怎么办? 所以这种问题线上常见的,一般不出,一出就是大问题,一般常见于,举个例子,消费端每次消费之后要写mysql,结果mysql挂了,消费端挂掉了。导致消费速度极其慢。 分析1+话术 这个是我们真实遇到过的一个场景,确实是线上故障了,这个时候要不然就是修复consumer的问题,让他恢复消费速度,然后傻傻的等待几个小时消费完毕。(可行,但是不建议 在面试的时候说) 一个消费者一秒是1000条,一秒3个消费者是3000条,一分钟是18万条,1000多万条 所以如果你积压了几百万到上千万的数据,即使消费者恢复了,也需要大概1小时的时间才能恢复过来一般这个时候,只能操作临时紧急扩容了,具体操作步骤和思路如下: 1)先修复consumer的问题,确保其恢复消费速度,然后将现有cnosumer都停掉 2)新建一个topic,partition是原来的10倍,临时建立好原先10倍或者20倍的queue数量 3)然后写一个临时的分发数据的consumer程序,这个程序部署上去消费积压的数据,消费之后不做耗时的处理,直接均匀轮询写入临时建立好的10倍数量的queue 4)接着临时征用10倍的机器来部署consumer,每一批consumer消费一个临时queue的数据 5)这种做法相当于是临时将queue资源和consumer资源扩大10倍,以正常的10倍速度来消费数据 6)等快速消费完积压数据之后,得恢复原先部署架构,重新用原先的consumer机器来消费消息 分析2+话术 rabbitmq是可以设置过期时间的,就是TTL,如果消息在queue中积压超过一定的时间就会被rabbitmq给清理掉,这个数据就没了。那这就是第二个坑了。这就不是说数据会大量积压在mq里,而是大量的数据会直接搞丢。 这个情况下,就不是说要增加consumer消费积压的消息,因为实际上没啥积压,而是丢了大量的消息。我们可以采取一个方案,就是批量重导,这个我们之前线上也有类似的场景干过。就是大量积压的时候,我们当时就直接丢弃数据了,然后等过了高峰期以后,比如大家一起喝咖啡熬夜到晚上12点以后,用户都睡觉了。 这个时候我们就开始写程序,将丢失的那批数据,写个临时程序,一点一点的查出来,然后重新灌入mq里面去,把白天丢的数据给他补回来。也只能是这样了。 假设1万个订单积压在mq里面,没有处理,其中1000个订单都丢了,你只能手动写程序把那1000个订单给查出来,手动发到mq里去再补一次 分析3+话术 如果走的方式是消息积压在mq里,那么如果你很长时间都没处理掉,此时导致mq都快写满了,咋办? 这个还有别的办法吗?没有,谁让你第一个方案执行的太慢了,你临时写程序,接入数据来消费,消费一个丢弃一个,都不要了,快速消费掉所有的消息。然后走第二个方案,到了晚上再补数据吧。
15.为什么要使用 rabbitmq
(1)在分布式系统下具备异步,削峰,负载均衡等一系列高级功能; (2)拥有持久化的机制,进程消息,队列中的信息也可以保存下来。 (3)实现消费者和生产者之间的解耦。 (4)对于高并发场景下,利用消息队列可以使得同步访问变为串行访问达到一定量的限流,利于数据库的操作。 (5)可以使用消息队列达到异步下单的效果,排队中,后台进行逻辑下单
16.使用 rabbitmq 的场景
(1)服务间异步通信 (2)顺序消费 (3)定时任务 (4)请求削峰
17.消息基于什么传输?
由于 TCP 连接的创建和销毁开销较大,且并发数受系统资源限制,会造成性能瓶颈。它信道的方式来传输数据。信道是建立在真实的 TCP 连接内的虚拟连接,且每条 TCP 连接上的信道数量没有限制。
18.消息如何分发?
若该队列至少有一个消费者订阅,消息将以循环(round-robin)的方式发送给消费者。每条消息只会分发给一个订阅的消费者(前提是消费者能够正常处理消息并进行确认)。通过路由可实现多消费的功能
19.RabbitMQ 的集群
普通集群 (只同步结构,不同步消息) 镜像集群 (都同步,出现脑裂) 仲裁队列 (都同步,没有脑裂) [推荐] Stream流 (不成熟,效率不如kafka) 第三方实现 Shovel Pluging (适用于跨集群或不同管理域的节点间传递消息,支持不同用户、vhost 和 RabbitMQ 版本) 适用于需要跨集群传递消息且对消息可靠性要求不高的场景(如日志同步) Federation Plugins (同样支持跨集群消息传递,但更强调集群间的松耦合,允许节点独立运 行) 适用于需要集群间松耦合通信的场景(如分布式系统中的服务调用)。
ElasticSearch
1、为什么要使用ElasticSearch
使用Elasticsearch有以下几个主要原因:
- 强大的全文搜索功能:倒排索引,分词,高亮,补全等功能
- 分布式和高可用性:
- 实时数据分析和聚合:
- 构建实时应用:
- 生态系统和易用性:
2、ElasticSearch为什么快
Elasticsearch之所以快速,主要有以下几个原因:
- 倒排索引(Inverted Index):Elasticsearch使用倒排索引来加速搜索过程。倒排索引是一种将词 条与其出现位置的映射关系存储在索引中的数据构。通过倒排索引,Elasticsearch可以快速定位包 含特定词条的文档,从而加搜索效率。
- 分布式架构:Elasticsearch是一个分布式系统,它可以将数据分布在多个节点上进行存储和计算。 这使得它具有横向扩展能力,能够处理大规模数据和高并发访问。通过将数据分片和分布式查询, Elasticsearch可以并行处理搜索请求,从而提高搜索效率。
- 倒排索引的内存缓存:Elasticsearch使用内存缓存来提高搜索性能。它会将热门的词条和搜索结果 存储在内存中,以便快速响应查询请求。通过利用内存缓存,Elasticsearch可以避免频繁的磁盘访 问而加速搜索速度。
- 集群化部署和负载均衡:Elasticsearch支持集群化部署,可以将索引和查询请求分布在多个节点 上。它还提供了负载均衡机制,能够均衡地将请求分发给不同的节点,从而提高整体的处理能力和 响应速度。
- 后台实时刷新机制:Elasticsearch采用了近实时(Near Real-time)的刷新机制。当数据写入到 Elasticsearch时,它会先写入内存缓冲区,然后异步地刷新到磁盘。这样可以避免频繁地磁盘写 入,同时保证数据的可靠性和一致性。 综上所述,Elasticsearch通过倒排索引、分布式架构、内存缓存、负载均衡和实时刷新机制等技术手 段,实现了高效的搜索和查询功能,从而使其具备快速响应和处理大规模数据的能力。
3、倒排索引是什么
倒排索引(Inverted Index)是一种将词条与其出现位置的映射关系存储在索引中的数据结构。它是一 种反转(倒排)了文档-词条关系的索引方式。通常,一个正向索引(Forward Index)是通过文档ID来 查找对应的词条,而倒排索引则是通过词条来查找对应的文档ID。 在倒排索引中,每个词条都会关联一个或多个文档。对于每个词条,倒排索引会记录下它在哪些文档中 出现过以及出现的位置。这样,当需要搜索某个词条时,可以快速地找到包含该词条的文档。 倒排索引通常由两个主要部分组成:词典(Dictionary)和倒排列表(Inverted List)。词典以词条为 键,记录了每个词条对应的倒排列表的位置。而倒排列表则包含了所有包含该词条的文档ID以及出现位 置的信息。 倒排索引的结构使得搜索引擎能够快速定位包含特定词条的文档,从而加快搜索的速度。它是搜索引擎 中常用的索引结构,被广泛应用于全文搜索、文本分析和信息检索等领域
4、如何保证ES和数据库的数据一致性
为了保证Elasticsearch(ES)和数据库的数据一致性,可以采取以下几种方式:
- 实时同步:在数据更新到数据库之后,立即将相应的数据同步到ES中。可以通过在应用程序的业务 逻辑中,同时更新数据库和ES来实现实时同步。这样可以保证数据库和ES中的数据始终保持一致。
- 延迟同步:在数据更新到数据库之后,通过定时任务或消息队列等机制,定期批量将更新的数据同 步到ES中。这种方式可以降低对数据库写入操作的性能影响,并在一定程度上保证数据的同步性。
- 双写模式:在数据更新时,同时向数据库和ES进行写入操作。这种方式可以确保数据同时写入到两 个存储系统,从而保证数据的一致性。但是需要注意双写模式可能增加系统的复杂度和写入延迟。
- 使用数据库的日志或触发器:数据库的日志或触发器可以捕获数据的变更操作,然后通过监听这些 变更操作,将数据同步到ES中。这种方式可以避免对应用程序进行大量修改,但需要考虑数据库和 ES之间的网络延迟和数据同步的顺序。 无论采取哪种方式,都需要确保数据库和ES的数据操作是原子的、可靠的,并且在故障恢复时能够保持 数据的一致性。此外,还可以通过监控和日志记录来及时发现和解决数据同步的问题,确保数据的一致 性和可靠性。
5、ElasticSearch深度分页解决方案
- from + size (不推荐用于深分页) 原理: 协调节点向所有分片发起请求,每个分片返回 from + size 条数据,协调节点汇总后再截取。 痛点: 随着 from 的增大,每个分片都要查询并返回大量无用数据(在内存中排序),导致 CPU 和内存消耗呈指数级上升,极易引发 OOM。 限制: 默认限制 index.max_result_window 为 10,000。强制调大该值只会导致节点崩溃。
- search_after (推荐:实时查询、大数据量遍历) 这是目前处理深度分页的官方首选方案。 原理: 利用上一页最后一条数据的“排序值(Sort Values)”作为下一页查询的起始位置。类似于“游标”,不再需要计算跳过的文档数量。 优点: 性能极佳:无论分页多深,查询性能几乎保持一致。 实时性:可以读取到最新的写入数据。 缺点: 只能向后翻页(不支持随机跳转,如直接跳转到第100页)。 需要保持排序字段的唯一性(建议在排序中加入 _id 字段以防冲突)。 使用方式: 第一次查询:sort 包含唯一字段,获取结果集中最后一条数据的 sort 值。 下一次查询:在 search_after 参数中放入该值,继续查询。
- Scroll API (推荐:全量导出、快照需求) 如果你的目的是全量遍历整个索引(例如数据迁移、备份),而不是用户交互式翻页,应该使用 Scroll。 原理: ES 会为本次查询生成一个“快照”(Snapshot),将查询结果保存在服务器端的上下文环境中,后续请求通过 scroll_id 获取后续数据。 优点: 能够保证全量数据导出的一致性(即使有数据写入,也不影响快照内容)。 缺点: 高昂的内存开销: 必须在服务器维持上下文,一旦 Scroll 超时或过多,会占用大量堆内存。 非实时: 快照建立后,后续写入的数据在本次遍历中不可见。 使用建议: 使用完后务必及时调用 DELETE /_search/scroll 接口释放资源。
- Point In Time (PIT) + search_after (ES 7.10+ 新特性) 这是 Scroll 的最佳替代方案,结合了 search_after 的灵活性和 Scroll 的一致性。 原理: PIT 保持搜索上下文的稳定性,确保查询期间底层段(Segment)不会被合并或修改,从而实现数据视图的一致性。 场景: 当你需要进行大规模并发导出,且又要求结果是“一致性快照”时,这是目前的终极方案。
一句话提炼:Elasticsearch 深分页禁止使用 from+size ,实时向后翻页首选 search_after,全量快照导出优先用 Point In Time + search_after(替代 Scroll),且务必及时释放资源。
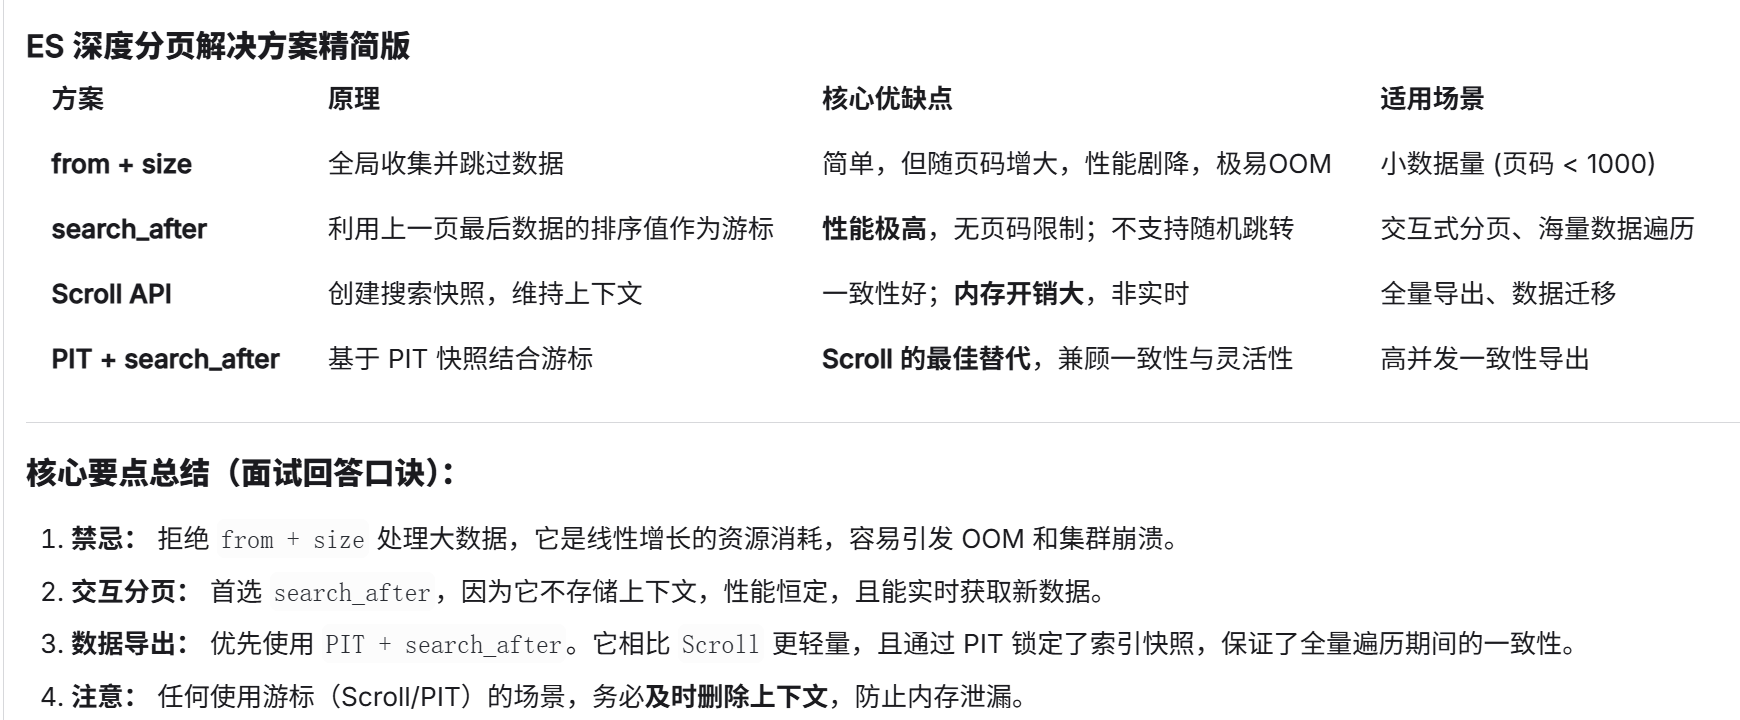
6、分片与副本作用
-
分片:用来分布式存储、分散压力、提高写入 / 查询并发。 作用:
-
数据水平拆分:把一个大索引切分成多份,分散在不同节点,解决单节点存储上限问题。
-
提高写入并发:写入可以分散到多个主分片,提升写入吞吐量。
-
分布式计算:查询时多分片并行执行,加快查询速度。 特点: 索引创建时指定数量,后期不能修改 真正存储数据、承担写入的单元
-
副本:用来做数据备份、保证高可用、分担查询流量。 作用:
-
高可用:主分片挂掉,副本可以提升为主分片,不丢数据、不停服务。
-
提高查询并发:查询请求可以落在主分片或副本分片,分摊读压力。 特点: 数量可以随时修改 不承担写入,只同步主分片数据
指标:一个片一般是50G左右,如果预计资源300G,就分6个片 刚上线的项目一个片一个备份,备份的数量不能多余片的数量
7、写数据流程
一句话总结:先写内存 buffer + 日志 translog → 每秒 refresh 成 segment → 定时 flush 到磁盘 → 清空 translog 完整流程:
- 客户端请求 → 协调节点
- 路由分片: hash(id) % 主分片数 找到对应主分片
- 写 buffer + translog 写入内存 buffer(此时数据不可搜索) 同时写 translog 日志(防止宕机丢数据)
- refresh 过程(默认 1 秒) buffer 数据生成 segment 写入 文件系统缓存 数据可被搜索 buffer 清空
- flush 与 commit 满足条件后,segment 刷入磁盘 translog 清空,数据持久化完成
8、近实时原理
写入不是立刻可查,而是默认 1 秒 refresh 一次,把内存 buffer 生成 segment 进入文件系统缓存, 这时候才能被搜索到。 详细流程
- 数据先写入 内存 buffer,同时写 translog 防止丢失。
- 此时数据不能被搜索。
- 默认每隔 1 秒,ES 执行一次 refresh: 将 buffer 中的数据生成 segment 写入 文件系统缓存 数据从此可被搜索 清空 buffer
- 之后再通过 flush 真正落盘。
9、mapping 中 text 和 keyword 区别
text 会分词,用于全文搜索,不能聚合排序; keyword 不分词,用于精确匹配、过滤、排序和聚合。
- text 类型 会分词:把文本切成一个个词,建立倒排索引。 支持全文检索:可以模糊搜索、匹配关键词。 不能排序、不能聚合(除非开 fielddata,不推荐)。 适用:文章内容、标题、描述、评论等需要搜索的长文本。
- keyword 类型 不分词:整体作为一个词存入索引。 精确匹配:用于 term 查询、过滤。 可以排序、可以聚合。 适用:状态值、枚举、标签、手机号、ID、英文名称、城市等不需要分词的字段
10、term 和 match 区别
term 不分词,精确匹配,适合 keyword; match 先分词再匹配,适合 text 全文检索。
- term 查询 不对查询内容分词,直接拿去倒排索引里查。 用于:精确匹配 适合:keyword、数字、ID、枚举 不适合:text 字段(因为存的时候分词了)
- match 查询 先对查询内容分词,再去匹配。 用于:全文检索 适合:text 字段 案例: 字段: “我喜欢Java” , text 类型分词后: 我、喜欢、Java term:“喜欢 Java” → 查不到(没有这个完整词) match:“喜欢 Java” → 分词为 喜欢、Java ,能查到
11、ES 写入优化
加大 refresh、关闭副本、批量写入、优化分片、用好 translog,性能直接起飞。 ES 写入优化主要从这几点入手:
- 写入前关闭副本(“number_of_replicas”: 0),调大 refresh_interval(“refresh_interval”: ”60s”);
- 使用 bulk 批量写入:不用单条写入,用 _bulk,批量大小:500
5000 条,总量 515MB - 合理设置分片数量,控制单分片大小,单个分片大小控制在 20~50GB,主分片数 ≈ 总数据量 / 50GB;
- 优化 translog 刷盘策略,“translog.durability”: “async” “translog.sync_interval”: “5s”;
- 精简 mapping,关闭不必要字段索引( index: false );
- 使用 SSD,合理配置 JVM 内存(堆内存 Xmx = Xms ≤ 32GB)。
- 段合并优化,ES 自动合并,可适当调高线程,避免大量小 segment 导致写入抖动
12、脑裂问题
脑裂是集群网络异常时出现多个 Master,导致数据不一致; 通过配置 minimum_master_nodes = (主节点数/2)+1 ,保证只有超过半数节点才能选举主节点,即可 避免。 ES 7.x 以后已经去掉这个配置,内部自动解决脑裂,不用手动配置。 3 个主节点 → 设置 2 5 个主节点 → 设置 3
13、集群红黄状态
绿:全部正常,所有主分片 + 所有副本分片 都正常分配; 黄:主分片正常、副本不正常,数据不丢,服务可用,但没有高可用; 红:至少一个主分片异常,数据不完整。 Yellow 常见原因 节点宕机,副本没地方分配 分片分配规则限制(分片感知、路由) 副本数设置比节点数多 Red 常见原因 节点宕机,主分片丢失 磁盘满、权限问题 数据损坏 集群脑裂 / 异常重启
14、ElasticSearch存什么,如何分片
① 配件搜索索引:配件名称、型号、规格参数(CPU/显卡等),支撑全文检索和筛选 ② 配置单搜索:用户公开的配置单标题、配件组合,用于社区推荐和搜索 ③ 用户行为日志:点击、搜索词、DIY操作,用于分析和个性化推荐 ④ 监控日志(ELK) 分片: ① 主分片每个分片大小控制在 10~50GB 配件索引数据约 500 万条,存储 2GB,设 1 主分片 + 1 副本 即可; 日志索引日增 5GB,按天滚动,每天 3 主分片 + 1 副本,便于水平扩展。
场景题
场景描述:
你负责一个日增数据量约为 500GB 的日志检索系统,集群有 15个数据节点(每台 64GB 内存,SSD 磁盘)。业务高峰期(QPS 约 2000 写入,500 查询),发现集群频繁出现 CPU 飙升、查询超时,甚至节点因 OOM(内存溢出) 而频繁掉线。
经排查,索引采用默认配置:number_of_shards = 5,number_of_replicas = 1,refresh_interval = “1s”,且大量查询使用 from + size 进行深度翻页。
请回答以下问题(层层递进,考察深度):
1、问题定位:根据现有配置,列举至少 3个 最可能导致集群性能恶化的配置缺陷,并阐述每个缺陷会引发哪类具体资源瓶颈(CPU/内存/磁盘I/O)。 ① 分片数过少(单分片数据量可能超100GB,导致查询合并慢);② 1s 刷新太频繁(生成大量小段,消耗CPU和文件句柄);③ 深度分页内存爆炸(协调节点每分片拉取大量数据,堆内存被撑爆)。
2、写入优化:为了缓解写入压力,你需要在索引设置和客户端编码上做哪些调整?请重点解释 translog 和 refresh_interval 的权衡策略,以及 indexing buffer 与节点堆内存的关系。 ① 将 refresh_interval 调整为 30s 或 60s(指数级降低段合并压力);② 控制 translog 的 durability 为 async 并调大 flush_threshold_size(提升写入吞吐,但需允许少量数据丢失);③ 确保 indices.memory.index_buffer_size 占堆内存的 10%-20%。
3、查询优化:针对用户的深分页需求,为什么不能直接调大 index.max_result_window?请对比 search_after 和 Scroll 在内存消耗和数据一致性上的本质区别,并说明各自适合的应用场景。 ① search_after 基于实时游标,不占用堆外内存,适合交互式翻页,但数据变更会影响结果集;② Scroll 基于快照,会占用大量堆外内存(Context),适合海量数据导出,但不适合实时查询。
4、故障恢复与预防:如果其中一个节点因为 Full GC 导致掉线,集群会立刻发生什么?(请从 主分片重分配、副本提升、集群状态变化 三个角度描述)。为了防止节点再次 OOM,你会如何调整 堆内存大小 和 熔断器(Circuit Breaker) 的设置? ① 集群状态变 Yellow(丢失副本);② 如果掉线节点包含主分片,该分片的副本会被提升为主分片;③ 触发 recovery 流程,在剩余节点间复制分片,此时I/O压力会进一步加剧。预防措施:堆内存不超过 32GB(压缩指针失效临界点),并设置 indices.breaker.total.limit 为堆内存的 70%。
5、终极脑暴:假设业务方要求“必须支持实时按用户ID查询最近1小时的数据,同时又要支持全量历史数据的导出”,在索引设计和查询策略上,你会如何兼顾这两类差异巨大的负载?(提示:涉及冷热分离与读写分离)
冷热分离架构:热节点(SSD + 高性能)存最近1小时数据,索引设 routing 按用户ID哈希;冷节点(HDD)存历史数据。读写分离:通过 跨集群复制(CCR) 或 别名(Alias) 将查询流量路由到专有副本节点,避免写入时的锁竞争影响查询。
mongoDB
MongoDB 类型 文档数据库 数据模型 BSON文档 核心特征 灵活文档存储 性能特点 读写均衡,水平扩展好 一致性 最终一致性/可调一致性 主要用途 灵活文档存储,内容管理,实时分析 适用场景 灵活模式、JSON文档
MongDB存什么
① 用户行为埋点 ② 配件规格参数 ③ 配置单的评论、点赞、分享 ④ 用户 DIY 会话状态 ⑤ 商品评价与晒单 ⑥ 价格变动历史
为什么MySQL用B+树,MongoDB用B树?
MySQL 靠范围吃饭 → B + 树 MongoDB 靠随机点查吃饭 → B 树 MySQL(InnoDB)面向关系型数据、范围查询、排序、事务,B + 树只有叶子节点存数据、非叶子节点 索引密度更高、树更矮、磁盘 IO 更少,且叶子节点用链表连接,范围查询极快,因此选择 B + 树。 MongoDB 是文档数据库,以单文档随机读写为主,范围查询少,B 树所有节点均可存储数据,查到索 引即可直接获取数据,减少磁盘 IO,随机查询更快,因此选择 B 树。
JSON跟BSON
JSON 与 BSON(Binary JSON)对比
一、核心定义与设计目标
| 维度 | JSON | BSON (Binary JSON) |
|---|---|---|
| 本质 | 文本格式的轻量级数据交换语言 | 二进制编码的序列化数据格式(JSON 的二进制超集) |
| 设计目标 | 人类易读 / 编写、跨语言数据交换(如接口传输) | 高效存储 / 快速解析、支持更多数据类型(适配数据库) |
| 诞生背景 | 1999 年,基于 JS 对象语法,为前端 - 后端交互设计 | 2009 年,MongoDB 团队推出,解决 JSON 存储缺陷 |
| 可读性 | 纯文本,人类可直接阅读 / 修改 | 二进制,不可直接阅读(需工具解析) |
二、基础类型对比
| JSON 支持类型 | BSON 支持类型 |
|---|---|
| 字符串(String) | 字符串(String) |
| 数字(Number,不分整型 / 浮点) | 整型(Int32/Int64)、浮点(Double)、十进制(Decimal128) |
| 布尔(Boolean) | 布尔(Boolean) |
| 数组(Array) | 数组(Array) |
| 对象(Object) | 文档(Document)兼容 JSON 对象,支持嵌套 |
| null | null |
| - | 日期(Date) 原生存储时间戳(无需转字符串) |
| - | 二进制数据(Binary)存储图片、文件等二进制内容 |
| - | ObjectId MongoDB 主键类型,高效生成唯一 ID |
| - | 正则表达式(Regex)原生支持正则匹配 |
| - | 时间戳(Timestamp)数据库事务 / 版本控制 |
| - | 代码(Code)存储 JS 代码片段(如 MongoDB 脚本) |
三、性能与存储特性对比
| 维度 | JSON | BSON |
|---|---|---|
| 存储体积 | 文本冗余(如键名重复、分隔符),体积较大 | 二进制紧凑存储,体积通常比 JSON 小 20%-50%(如数字用固定字节存储) |
| 解析速度 | 需逐字符解析文本,速度慢 | 二进制按固定格式解析(如 Int32 占 4 字节),速度提升 2-5 倍 |
| 索引支持 | 无原生索引(需上层解析后处理) | 支持字段级索引(MongoDB 基于 BSON 字段建索引,查询极快) |
| 遍历效率 | 需解析完整文本才能访问嵌套字段 | 可直接定位二进制偏移量访问字段(无需全解析) |
| 兼容性 | 全语言支持(所有语言都能解析文本) | 需专用库解析(如 MongoDB Java Driver、bson-js) |
四、业务场景选型对比
| 场景 | 推荐使用 JSON | 推荐使用 BSON |
|---|---|---|
| 前后端接口传输 | ✅ 人类可读,跨语言兼容 | ❌ 二进制无法直接调试 |
| 配置文件 | ✅ 易编辑、易阅读 | ❌ 二进制无法手动修改 |
| MongoDB 存储 | ❌ 类型缺失、性能差 | ✅ 原生支持,高效存储 / 查询 |
| 大数据批量存储 / 传输 | ❌ 体积大、解析慢 | ✅ 紧凑、解析快,降低 IO 开销 |
| 精准数值存储(金额) | ❌ 浮点精度丢失 | ✅ Decimal128 类型精准存储 |
| 二进制内容存储 | ❌ 需转 Base64(体积增加 30%) | ✅ 原生二进制类型,无冗余 |
| 时间字段处理 | ❌ 需转字符串(解析耗时) | ✅ 原生 Date 类型,时区适配友好 |
MongoDB 索引类型有哪些?各自使用场景?索引失效场景?
常用索引 单键索引:普通单个字段索引 复合索引:多个字段,遵循最左前缀原则 多键索引 (multikey):字段是数组,自动为数组每个元素建立索引 唯一索引 unique:字段值不可重复,可配合 sparse 稀疏索引 TTL 索引:自动过期删除数据(会话、临时验证码、日志) 文本索引:全文检索 2dsphere 地理索引:地理位置范围查询 稀疏索引 sparse:只索引存在该字段的文档,忽略无此字段文档 索引失效常见场景 查询条件字段使用函数、运算:{$gt:new Date() - 3600} 复合索引不满足最左前缀; 正则以.开头 /abc./; 字段隐式类型匹配(字符串数字和 Number 类型对比); 大量数据过滤后走索引代价过高,优化器自动选择集合扫描 COLLSCAN; 使用$where、JavaScript 表达式查询。 排查命令:explain(“executionStats”)
MongoDB 事务机制?多文档事务有什么限制?
3.2:只支持单文档原子性(不需要事务,天然原子) 4.0:副本集支持多文档事务 4.2:分片集群支持事务 关键限制 事务内操作不能跨分片(分片集群); 事务大小限制:整个事务 BSON 不能超过 16MB; 事务执行时间默认最大 60s,超时自动回滚; 多文档事务性能远低于单文档操作,能设计成内嵌文档就不要用事务; 不支持长事务,避免事务中做耗时 IO。 最佳实践:优先通过文档内嵌实现业务原子操作,减少事务使用。
什么是副本集(Replica Set)?作用?选举机制?
副本集:一组 Mongo 节点,实现高可用、数据备份、读写分离。 角色: Primary 主节点:接收所有写操作; Secondary 从节点:同步主节点 oplog,可以承担读请求; Arbiter 仲裁节点:不存储数据,只参与投票选举。 选举规则 多数节点投票才能选出主节点; 标准部署:1 主 2 从(3 节点,具备故障转移能力); 主节点宕机,剩余节点发起选举,自动选出新主; oplog:主节点操作日志,从节点依靠 oplog 同步数据。 Java 开发关注点:客户端读写策略 readPreference primary:只读主(强一致) secondaryPreferred:优先读从,从不可用读主(最常用)
MongoDB 分片集群(Sharded Cluster)组成,分片键选择原则?
分片集群四大组件: Shard:分片节点,每个 shard 本身通常是副本集;存储真实数据 mongos 路由:请求入口,无状态,负责路由转发 Config Server:元数据服务器,保存分片、块 (chunk) 路由信息 分片键选择 分片键是集合分片划分依据,一旦选定很难修改! 好分片键特征: 基数足够大(取值多,避免集中一块) 读写分布均匀,防止热点块 常用在查询条件中,避免 mongos 广播查询所有分片 糟糕分片键案例: 使用时间作为唯一分片键:新数据全部写入同一个分片(写热点) 解决方案:复合分片键 {time, userId} 打散写入压力 概念补充:chunk(数据块),默认 64MB,达到阈值自动分裂、迁移。
什么是写关注 WriteConcern、读偏好 ReadPreference?生产如何配置?
WriteConcern(写关注,控制写入确认强度) {w: “majority”, wtimeout: 5000} w:1:主节点写入成功即返回(速度快,故障可能丢数据) w:“majority”:大多数副本写入成功才返回(生产推荐,数据安全) wtimeout:写入超时时间,防止永久阻塞。 ReadPreference 读偏好 控制从哪个节点读取:primary /primaryPreferred/secondary /secondaryPreferred/nearest 业务注意:读从节点存在数据延迟(最终一致性),敏感业务必须读主节点。 Java 项目开发注意:SpringDataMongo / MongoClient 需要正确配置这两个参数。
MongoDB 常见性能优化手段
建模优化:优先内嵌,减少集合关联;一对多用内嵌,多对多分开设计; 索引优化:合理创建复合索引,定期分析 explain,删除无用索引;索引过多拖慢写入; 避免大文档:单文档上限 16MB,超大文档拆分; 杜绝深度 skip 分页,采用密钥分页; 读写分离:非实时查询路由到从节点; 热点数据规避:分片键合理设计,防止单分片压力过大; 批量操作使用 bulkWrite,减少网络往返; TTL 索引自动清理过期数据,避免定期大量 remove; 控制事务范围,尽量只用单文档原子操作; 监控慢查询,开启 profile 捕获慢操作。
MongoDB 单文档大小限制?为什么限制 16MB?
防止超大文档占用内存,导致内存溢出; 副本集同步、分片迁移时减少网络压力; 内存映射机制设计,方便内存管理。 如果数据超过限制:拆分成多个文档,或者使用 GridFS 存储超大文件(图片、视频等 > 16MB 文件)。
linux
常用命令
1.ls 列出当前目录下的文件和文件夹
2.cd 切换目录
3.pwd 显示当前所在的完整路径
4.mkdir 创建新文件夹
5.rm 删除文件或文件夹
6.cp 复制文件或文件夹
7.mv 移动文件/重命名
8.touch 创建空文件或更新时间戳
9.cat 查看文件全部内容(适合小文件)
10.head / tail 看文件头部/尾部几行
11.vim 终端里的文本编辑器(纯键盘操作)
12.nano 比 vim 简单好用的编辑器
13.grep 搜索文件内容(超级重要)
14.chmod 修改文件权限(读/写/执行)
15.chown 修改文件所属用户和组
16.sudo 以超级管理员(root)身份执行
17.whoami 查看当前登录的用户名
18.ps 查看当前运行的进程
jps 查看Java所有进程
19.top 实时看系统资源占用(CPU/内存)
20.kill 杀掉进程(强制结束程序)
21.nohup 让程序在后台运行(关终端也不停)
22.ping 测试网络通不通
23.tar 打包/解包(最常用)
24.zip / unzip zip格式压缩/解压
25.ifconfig / ip addr 查看本机IP地址
26.netstat 查看端口占用情况
27.free -h 查看内存使用情况
28.df -h 查看磁盘剩余空间
常用符号 1.| 管道:把前一个命令的结果传给后一个命令 2.> 重定向:把命令输出保存到文件(覆盖) 3.>> 追加:把命令输出追加到文件末尾 4.& 让命令在后台运行
前端
VUE3常见的渲染指令 1 插值表达式 {{}} 2 文本渲染指令 v-text v-html 3 属性渲染 v-bind 简写为 : 4 事件渲染 v-on 简写 @ VUE3事件名称 onclick >>> click 事件的修饰符 .once .prevent .stop 5 条件渲染 v-if v-else v-show 6 列表渲染 v-for=“(对象,index) in 数组/集合” 7 双向绑定 v-model 仅仅用于表单标签
响应式数据 ref 更适合处理单个值的数据 在script标签中,通过.value方式访问 在template标签中,无需.value reactive 更适合处理多个属性的对象
| 生命周期阶段 | 选项式 API | 组合式 API | 说明 |
|---|---|---|---|
| 初始化前 | beforeCreate | 初始化数据、函数、调用数据监听 之前 | |
| 初始化后 | created | 初始化数据、函数、调用数据监听 之后 | |
| 挂载前 | beforeMount | onBeforeMount() | 当前组件挂载到 DOM 树之前 |
| 挂载后 | mounted | onMounted() | 当前组件挂载到 DOM 树之后 |
| 更新前 | beforeUpdate | onBeforeUpdate() | 响应数据已经改变,更新到 DOM 树前 |
| 更新后 | updated | onUpdated() | 响应数据已经改变,更新到 DOM 树后 |
| 卸载前 | beforeUnmount | onBeforeUnmount() | 当前组件从 DOM 中卸载前 |
| 卸载后 | unmounted | onUnmounted() | 当前组件从 DOM 中卸载后 |
AJAX 的原理是什么?用原生 JS 怎么发请求? 原理:通过浏览器提供的 XMLHttpRequest 或 Fetch API,在后台向服务器发送 HTTP 请求并接收数据(通常是 JSON),然后用 JavaScript 更新 DOM,实现局部刷新。 原生实现步骤(以 XMLHttpRequest 为例): 创建对象 配置请求 设置回调 发送请求
常见 HTTP 状态码有哪些? 常见状态码: 200 OK :成功 201 Created :创建资源成功(POST) 204 No Content :删除成功,无响应体 301/302 重定向 304 Not Modified :缓存有效 400 Bad Request :请求参数错误 401 Unauthorized :未认证 403 Forbidden :无权限 404 Not Found :资源不存在 500 Internal Server Error :服务器内部错误
v-show 与 v-if 的区别 v-show 指令是通过修改元素的 display 的 CSS 属性让其显示或者隐藏; v-if 指令是直接 销毁 和 重建 DOM 达到让元素显示和隐藏的效果; 使用 v-show 会更加节省性能上的开销;当只需要一次显示或隐藏时,使用 v-if 更加合理。
双向绑定
生命周期
v-if和v-show
docker
Docker 是轻量级的”虚拟机”,把应用和它的依赖打包成一个”集装箱”,在任何机器上都能一致运行。
Docker 和虚拟机的区别
对比维度 Docker 容器 传统虚拟机(VM)
启动速度 秒级启动 分钟级启动 资源占用 轻量,共享宿主机内核 重,每个虚拟机都有完整操作系统 隔离级别 进程级隔离 硬件级完全隔离 镜像大小 MB 级别 GB 级别 本质 就是一个进程 模拟了一整台电脑
Docker 的三大核心概念 1.镜像(Image) 2.容器(Container) 3.仓库(Repository)
常用命令 1.docker pull nginx 从仓库拉取镜像 2.docker images 查看本地所有镜像 3.docker run -d -p 80:80 nginx 创建并启动容器 -d 后台运行,-p 宿主机端口:容器端口 4.docker ps 查看运行中的容器 -a 查看所有 5.docker stop <容器id>/<容器名> 停止容器 6.docker start <容器id>/<容器名> 启动已停止的容器 7.docker restart <容器id>/<容器名> 重启容器 8.docker rm <容器id>/<容器名> 删除容器(需先停止) 9.docker rmi <镜像id> 删除镜像 10.docker logs <容器id> 查看容器日志 11.docker exec -it <容器id> /bin/bash 进入容器内部 12.docker inspect <容器名或ID> 查看容器配置
数据卷:容器删除后,里面的数据就没了。Volume 就是把容器内的数据”挂载”到宿主机上,永久保存
基础命令: 1.docker volume create my_data 创建数据卷 2.docker run -v my_data:/app/data my-app 运行容器时挂载卷 3.docker run -v /host/path:/container/path 挂载宿主机目录
nginx
Nginx是一个高性能的开源 Web 服务器、反向代理服务器、负载均衡器、HTTP 缓存和邮件代理。
为什么性能这么高?能抗多少并发?
核心原因:异步非阻塞事件驱动模型 + epoll/kqueue(而非 Apache 的进程/线程模型)。 一个 master + 多个 worker 进程模型,每个 worker 单线程处理成千上万连接。 生产经验:单机 4核8G 配置,开启 gzip + keepalive,轻松 5–10 万 QPS;优化后单机可达 20–30 万 QPS。
如何处理一个 HTTP 请求的
客户端建立 TCP 连接 → accept epoll 监听 → 读事件就绪 读取请求头 → 解析 HTTP 请求行/头 根据 server_name / listen / location 匹配 upstream 或本地文件 → 输出响应头 + body keepalive 或 close 连接 整个过程不阻塞,靠状态机 + 事件循环驱动。
正向代理和反向代理
| 项目 | 正向代理 | 反向代理 |
|---|---|---|
| 代理谁 | 客户端(替客户端去访问目标) | 服务器(替服务器接收请求) |
| 客户端知道吗 | 知道要设置代理 | 不知道(以为直接访问 Nginx) |
| 典型场景 | 科学上网、公司内网突破 | 负载均衡、隐藏真实后端、动静分离 |
| Nginx 支持 | ngx_http_proxy_module(较少用) | 默认支持,最强项 |
核心用途
核心用途: 静态资源服务器(最高效) 反向代理 + 负载均衡(微服务网关前置) 四/七层负载均衡(TCP/UDP + HTTP) Ingress Controller(K8s 最常用的一种)
基本命令
nginx # 启动(若已启动会报错) nginx -s stop # 立即停止 nginx -s quit # 优雅停止(处理完当前请求后退出) nginx -s reload # 不中断服务重新加载配置 nginx -t # 测试配置文件语法是否正确 nginx -V # 查看编译参数及版本信息
nginx和gateway
| 维度 | Nginx | Spring Cloud Gateway |
|---|---|---|
| 定位与角色 | 全局负载均衡器、反向代理、Web服务器,技术栈无关 | 业务性的API网关、服务路由,专为Java Spring Cloud微服务生态设计 |
| 技术栈 | 基于 C/Lua,与语言无关 | 基于 Java/Spring,深度集成Spring生态 |
| 性能 | 极高。基于事件驱动模型,资源消耗低,擅长处理高并发静态请求和反向代理。 | 高。基于 Reactor 模式 (WebFlux),性能优于 Zuul,但在纯粹的反代理和静态资源处理上通常不及Nginx。 |
| 动态配置 | 原生支持较差。依赖文件系统,重载配置需要 nginx -s reload。可通过 Nginx Plus 或 结合Consul/Lua 实现动态更新。 | 天生支持。与Spring Cloud Config、Nacos、Eureka等无缝集成,可动态更新路由和配置,无需重启。 |
| 服务发现 | 需要插件或第三方模块。如 nginx-plus 或 nginx-upsync-module 来集成Consul/Eureka。 | 天生支持。无缝集成 Eureka, Nacos, Consul 等。 |
| 功能特性 | 反向代理、负载均衡、缓存、SSL终结、动静分离 等Web服务器核心功能非常强大。 | API路由、断言(Predicate)、过滤器(Filter)、限流、熔断、鉴权 等微服务治理功能强大。 |
| 扩展性与生态 | 通过 C模块/Lua脚本(OpenResty) 扩展,功能强大但开发门槛高。 | 通过 Java代码/Spring Bean 扩展,易于Java开发者上手,Spring生态丰富。 |
| 学习成本 | 需要学习其配置语法和架构,高级功能需要C/Lua基础。 | 对Spring技术栈的开发者非常友好,学习成本低。 |
在实际的微服务架构中,Nginx 和 Spring Cloud Gateway 通常不是互斥的选择,而是协同工作,各司其职。Ngninx做第一层网关,Gateway做第二层网关。 什么时候只用 Nginx? 你的架构很简单,只是一个单体应用或少数几个服务。 你只需要基础反向代理和负载均衡,没有复杂的、基于Java的业务逻辑(如JWT鉴权)。 你对性能(尤其是静态资源)有极致要求。
人话
Nginx 像个万能门卫,啥请求都能接,性能极猛,特别适合扛流量、转发、处理静态文件,但微服务那套玩法它不擅长,动态改配置比较费劲。 Spring Cloud Gateway 是 Spring 体系的“内部管家”,跟 Java 微服务天然一体,路由、鉴权、限流随手就来,但纯粹拼转发和静态资源干不过 Nginx。
实战里通常两个一起用:Nginx 顶在最外层挡流量、做 SSL,Gateway 在后头做精细化的微服务路由和治理。 只用 Nginx 就够的情况:架构简单(单体/少量服务),只需要反代和负载均衡,没有复杂的业务网关需求,或者你对静态性能和资源消耗有极致要求。
git
常用命令
1.git status 查状态
2.git add . 或 git add -a 暂存到本地库 -a就是所有
3.git add <文件名> 暂存指定文件
4.git commit -m “feat: 信息” 提交到本地仓库
5.git log —oneline —graph 查看简洁提交历史
6.git branch 列出本地分支 -s所有分支(含远程)
7.git branch -d <分支名> 删除本地分支(安全)
8.git branch -D <分支名> 强制删除本地分支(高危)
9.git pull 拉取远程代码并自动合并
10.git fetch 仅下载远程更新,不合并
11.git push origin main 推送到远程主分支
12.git restore <文件> 丢弃工作区的改动(未 add)
13.git restore —staged <文件> 将文件移出暂存区(取消 add)
14.git reset —soft HEAD1 撤销 commit,保留代码改动(在暂存区)
15.git reset —mixed HEAD1 撤销 commit,保留代码改动(在工作区,需重新 add)
16.git reflog 查看所有 HEAD 移动历史
17.git log —oneline 查看历史版本
18.git reset —hard <哈希> 穿梭
Tomcat
tomcat开源的 Servlet 容器和 Web 服务器,主要用于运行 Java Servlet 和 JSP 应用。它轻量、跨平台,适合中小型 Web 应用的开发和部署。默认端口8080
WEBAPP的标准结构
一个标准的可以用于发布的WEB项目标准结构如下:
- app 本应用根目录
- static 非必要目录,约定俗成的名字,一般在此处放静态资源 ( css js img);
- WEB-INF必要目录,必须叫WEB-INF。受保护的资源目录,浏览器通过url不可以直接访问的目录;
- classes 必要目录,src下源代码、配置文件,编译后会在该目录下。web项目中如果没有Java源码,则该目录不会出现。
- lib 必要目录,项目依赖的jar编译后会出现在该目录下,web项目要是没有依赖任何jar,则该目录不会出现。
- web.xml 必要文件,web项目的基本配置文件.,较新的版本中可以没有该文件,但是学习过程中还是需要该文件。
- index.html 非必要文件,index.html/index.htm/index.jsp为默认的欢迎页;
部署方式
1.WAR 文件部署: 2.解压目录部署: 3.使用管理界面部署: 4.使用命令行工具:
Connector 运行模式
BIO:一个线程处理一个请求。缺点:并发量高时,线程数较多,浪费资源。Tomcat7版本或更低版本中,在Linux系统中默认使用这种方式。 NIO:利用Java的异步IO处理,可以通过少量的线程处理大量的请求。tomcat8.0.x中默认使用的是NIO。Tomcat7必须修改Connector配置来启动 APR:即Apache Portable Runtime,从操作系统层面解决io阻塞问题。Tomcat7或Tomcat8在Win7或以上的系统中启动默认使用这种方式。
如何优化
1.JVM 调优:堆内存大小、垃圾收集器和其他 JVM 参数 2.Connector 配置:线程池大小和连接超时设置,合适的运行模式 3.资源管理:优化静态资源的缓存策略 4.数据库优化:用连接池,优化 SQL 查询和索引 5.应用优化:定期清理无用资源,使用更高效的算法和数据结构 6.监控与日志:采用监控工具,优化日志级别
三个组件
1.Tomcat Valve,用于在请求处理流程中插入自定义功能或处理逻辑。它可以在请求到达 Servlet 之前或响应返回客户端之前执行特定操作。Valves 常用于以下目的:
日志记录:记录请求和响应的信息。 访问控制:基于请求的条件(如 IP 地址)决定是否允许访问。 请求过滤:对请求进行预处理或修改,或在响应返回前进行处理。
2.Tomcat Coyote 是 Tomcat 的 HTTP 连接器,负责处理客户端请求和响应。它是 Tomcat 的核心组件之一,提供了以下功能:
协议支持:支持 HTTP 和 AJP(Apache JServ Protocol),处理 Web 应用的请求和响应。 连接管理:管理与客户端之间的连接,支持多线程处理和异步 I/O。 性能优化:通过使用 NIO(非阻塞 I/O)提高并发性能,支持高并发的 Web 应用。 安全性:提供支持 HTTPS 的功能,确保数据传输的安全性。
3.Tomcat Jasper 是 Tomcat 的 JSP 引擎,负责处理 JavaServer Pages (JSP)。它的主要功能包括:
JSP 编译:将 JSP 文件编译为 Java Servlet 类,使其可以被 Tomcat 执行。 动态内容生成:处理 JSP 中的动态内容,通过嵌入的Java代码生成HTML或其他响应内容。 错误处理:在 JSP 编译过程中捕获和处理错误,提供调试信息。 标签库支持:支持JSP标签库(如 JSTL),使得开发人员可以更简便地构建动态 Web 应用。
Servlet的生命周期
加载与实例化:
当 Servlet 被请求时,容器加载 Servlet 类并创建其实例。 初始化: 调用 init(ServletConfig config) 方法进行初始化,进行一次性设置(如读取配置)。 请求处理: 当有请求到达时,容器调用 service() 方法,通常会调用 doGet()、doPost() 等方法处理请求。 销毁: 当 Servlet 不再需要或容器关闭时,调用 destroy() 方法,进行资源清理。 这一生命周期管理了 Servlet 的创建、使用和销毁,确保其高效运行。
如何监视Tomcat的内存使用情况
JVisualVM:使用此工具连接到 Tomcat 实例,查看内存和线程状态。 JConsole:类似 JVisualVM,连接并监控内存使用情况。 监控工具:使用 Prometheus 和 Grafana,通过 JMX 收集内存数据。 JVM 选项:启动 Tomcat 时添加 -Dcom.sun.management.jmxremote 启用 JMX 监控。 GC 日志:查看 Tomcat 的 GC 日志,分析内存和垃圾收集情况。
Tomcat工作模式
单线程模式:每个请求使用一个线程处理,适合小型应用。 多线程模式:使用线程池处理多个并发请求,提高性能。 NIO 模式:非阻塞 I/O,允许单个线程处理多个连接,适合高并发场景。默认的 I/O 模型 APR 模式:基于 Apache Portable Runtime,提供高性能和异步 I/O。
使用的连接器
这些连接器负责处理客户端请求和响应,并支持不同的协议和功能。 HTTP Connector: 处理 HTTP 请求,支持多种工作模式(如阻塞和非阻塞)。 AJP Connector: 用于与其他 Web 服务器(如 Apache HTTP Server)通信,支持 AJP(Apache JServ Protocol)。 HTTPS Connector: 处理 HTTPS 请求,提供安全的加密连接。 JMX Connector: 用于监控和管理 Tomcat 实例,支持通过 JMX 进行远程管理。
连接器的优化选项:
port: 作用:指定连接器监听的端口。 优化建议:根据实际需求选择合适端口,避免冲突。
protocol: 作用:选择 I/O 模型(BIO、NIO、APR/NIO2)。 优化建议:选择合适的协议(如 NIO、APR)以提升性能。
maxThreads: 作用:最大线程数,决定可同时处理的最大请求数。 优化建议:根据硬件配置和请求量调优,通常为 CPU 核心数 × 2 或更多。
acceptCount: 作用:当线程用尽时,最大等待队列长度。 优化建议:适当增大以防请求被拒绝,一般 100-200。
connectionTimeout: 作用:连接超时时间,控制空闲连接的存活时间。 优化建议:设置为 30000(30秒)左右,减少资源占用。
maxConnections: 作用:允许的最大连接数。 优化建议:根据硬件和业务负载设定,防止连接耗尽。 优化原则:根据应用需求和硬件资源,合理配置连接器参数,避免瓶颈,提高并发处理能力和响应速度。
Tomcat的BIO、NIO 、AIO模式的特点及适用场景
BIO(Blocking I/O): 特点:一个线程处理一个请求,同步阻塞。 适用场景:并发量小、简单场景(如开发、测试环境)。
NIO(Non-blocking I/O): 特点:使用少量线程处理大量请求,非阻塞,基于事件驱动。 适用场景:并发量大、需要更好性能的场景(如生产环境)。
AIO(Asynchronous I/O): 特点:完全异步处理,操作系统层面通知完成。 适用场景:高并发、长时间连接(如 WebSocket、大量 IO 操作)。 总结:BIO 用于低并发,NIO 用于高并发,AIO 用于极高并发场景。
Tomat线程池的作用及优化选项
Tomcat 线程池的作用: 处理并发请求:Tomcat 使用线程池管理 HTTP 请求,避免频繁创建和销毁线程带来的性能开销,提高处理效率。 资源管理:控制线程的数量和生命周期,防止过多线程导致系统资源耗尽或内存溢出。
线程池的优化选项: maxThreads: 作用:设置最大线程数,即可同时处理的最大请求数。 优化建议:根据服务器硬件和应用需求调整,通常设置为 CPU 核心数 × 2 或更多。
minSpareThreads: 作用:设置最小空闲线程数,保证有足够线程随时处理新请求。 优化建议:一般设置为 10-20 左右,根据应用请求的波动情况调整。
acceptCount: 作用:当所有线程都被占用时,最多允许多少个请求在队列中等待。 优化建议:适当增大,避免请求被拒绝或连接被重置,通常设置为 100-200。
maxIdleTime / keepAliveTimeout: 作用:控制线程空闲时间,超时后线程被销毁,节省资源。 优化建议:根据业务情况调整,一般设置为 60000 毫秒(60秒)。
executor(自定义线程池): 作用:使用自定义线程池,精细控制线程池参数,如核心线程数、队列大小等。 优化建议:在高级场景中使用,进一步优化性能。 优化原则:根据应用的并发量、处理时间和硬件配置合理调整线程池参数,避免过多或过少线程带来的性能问题。
实现热部署和热加载
Tomcat 实现热部署和热加载的方式如下:
热部署(Hot Deployment):
方式:将新的 WAR 文件或应用目录放入 webapps 目录,Tomcat 自动检测并部署。
配置:conf/server.xml 中的
热加载(Hot Reload):
方式:修改应用的 .class 文件或配置文件,Tomcat 自动重新加载。
配置:conf/context.xml 或
对Tomcat内存调优
对 Tomcat 进行内存调优,可以调整以下 JVM 参数:
设置堆内存大小: -Xms:设置初始堆内存大小,如 -Xms512m。 -Xmx:设置最大堆内存大小,如 -Xmx2048m。
设置新生代大小: -Xmn:设置新生代内存大小,如 -Xmn512m。
元空间(Java 8 及以上): -XX:MetaspaceSize:初始元空间大小,如 -XX:MetaspaceSize=128m。 -XX:MaxMetaspaceSize:最大元空间大小,如 -XX:MaxMetaspaceSize=512m。
垃圾回收器选择: 使用 G1 垃圾收集器:-XX:+UseG1GC。 或使用 CMS 垃圾收集器:-XX:+UseConcMarkSweepGC。
启用堆内存转储: -XX:+HeapDumpOnOutOfMemoryError:在内存溢出时生成堆转储文件,用于分析内存问题。 将上述参数添加到 CATALINA_OPTS 中进行调优即可。
类加载的顺序
Bootstrap 类加载器: 加载 Java 核心类库($JAVA_HOME/jre/lib),如 java.lang.、java.util. 等。 系统类加载器(System ClassLoader): 加载 Tomcat 和 JRE 自身的库($JAVA_HOME/lib/ext 和 $CATALINA_HOME/lib)。
Web 应用类加载器(WebappClassLoader): 加载每个 Web 应用的类和库,按以下顺序: /WEB-INF/classes:加载应用的自定义类。 /WEB-INF/lib/*.jar:加载应用的依赖库。
父类委托模型: 类加载器采用“父类委托”机制,即先从父类加载器加载类,如果未找到,再从自己的路径加载,避免重复加载和类冲突。
注意事项: 共享类库:$CATALINA_HOME/lib 中的类库可被所有应用共享,适用于全局依赖。 隔离性:各 Web 应用的类加载是独立的,互不干扰,保证应用之间的隔离性。
Netty
一、Netty是一个基于Java NIO 封装的高性能网络编程框架,它简化了网络编程的复杂性,提供了统一的API来处理各种网络协议。 主要应用场景包括: 构建高性能的网络服务器和客户端:如游戏服务器、即时通讯系统 分布式系统中的远程调用框架:如Dubbo、RocketMQ等中间件的通信层 大数据处理中的网络传输:如Spark、Hadoop等大数据框架的节点间通信 物联网设备通信:如智能家居、工业物联网等场景的设备管理
二、Netty中的零拷贝是如何实现的,有什么作用? Netty中的零拷贝主要通过以下几种方式实现: CompositeByteBuf:将多个ByteBuf组合成一个逻辑上的ByteBuf,避免了数据的复制。 FileRegion:用于文件传输,通过FileChannel的transferTo方法将文件内容直接传输到目标Channel,减少了用户空间和内核空间之间的数据拷贝。 ByteBuf的切片:通过slice方法创建ByteBuf的切片,切片和原ByteBuf共享底层的内存数据,避免了数据的复制。 零拷贝的作用:减少数据在内存中的复制次数,提高数据传输效率,降低CPU开销。
三、基本概念: 1.Channel是Netty中网络操作的抽象概念,它代表一个到实体(如硬件设备、文件、网络套接字等)的开放连接,提供了一系列操作方法,如读、写、连接、绑定等。 常用的Channel实现有: NioSocketChannel:用于TCP客户端。 NioServerSocketChannel:用于TCP服务器。 NioDatagramChannel:用于UDP通信。 EpollSocketChannel:Linux下基于epoll的高性能Channel。
EventLoop:是Netty中负责处理I/O事件和执行任务的线程,它继承自Java的ScheduledExecutorService接口。一个EventLoop可以处理多个Channel的I/O事件,是阻塞的。
EventLoopGroup:是EventLoop的集合,用于管理多个EventLoop。在Netty中,通常会创建两个EventLoopGroup,一个作为bossGroup用于处理客户端的连接请求,另一个作为workerGroup用于处理已连接通道的读写事件。
ChannelPipeline是一个ChannelHandler的链表,它负责管理和执行一系列的ChannelHandler。当有数据在Channel中流动时,数据会依次经过ChannelPipeline中的每个ChannelHandler进行处理。 ChannelPipeline的作用:将不同的业务逻辑拆分成多个独立的ChannelHandler,提高代码的可维护性和可扩展性。 工作原理: 入站事件:从Pipeline的头部(HeadContext)流向尾部(TailContext)。 出站事件:从Pipeline的尾部(TailContext)流向头部(HeadContext)。 Netty中的ChannelHandler主要分为两种类型: ChannelInboundHandler:处理入站事件,如连接建立、数据读取等。 ChannelOutboundHandler:处理出站操作,如连接、写、刷新等。
ChannelInitializer是Netty中用于初始化ChannelPipeline的特殊ChannelHandler。它在Channel注册到EventLoop后被调用,用于向ChannelPipeline中添加自定义的ChannelHandler。 主要作用: 简化ChannelPipeline的初始化过程 集中管理ChannelHandler的添加逻辑 初始化完成后自动从Pipeline中移除,避免影响后续事件处理
人话
-
Channel(通道) 就是一根水管。你想跟外面通信(发数据、收数据),先得接上这根管子。不同的通信方式对应不同的管子:TCP客户端用一根,TCP服务端用另一根,UDP又有专门的管子,Linux下还有性能更好的“高级管子”。
-
EventLoop 和 EventLoopGroup EventLoop = 一个干活的工人,专门盯着几根管子,哪根管子来水了(有数据来了),他就处理。他是死心眼,一次只盯一件事,干完再盯下一件。 EventLoopGroup = 一个工人小组。 实际干活时分两拨人:
bossGroup:只负责门口接客(接收新连接)。 workerGroup:接完客把客人领进去,负责后续所有端茶倒水的活儿(读写数据)。
- ChannelPipeline(管道流水线) 数据进来或出去,不是直接到目的地,而是经过一条流水线,流水线上站了一排工人,每个工人干一件特定的事。
数据进来时:从第一个工人传到最后一个工人。 数据出去时:从最后一个工人倒着传回第一个。 工人分两种:一种只处理进来的活儿,一种只处理出去的活儿。
- ChannelInitializer 这是一个临时工头。新管道刚接好的时候,他过来把流水线上的工人安排到位,安排完了自己就走人,后面不再掺和。
Docker Compose
Docker Compose 是 Docker 官方提供的多容器编排工具,主要用于把多个容器的启动配置写到一个 compose.yaml 或 docker-compose.yml 文件中,然后通过一条命令统一启动、停止、重建和管理整套服务。
典型场景:一个项目中同时包含 Java 后端、MySQL、Redis、Nginx 等多个服务,如果逐个使用 docker run 启动会比较麻烦,Docker Compose 可以把这些服务统一编排。
1. 核心作用
- 统一管理多个容器。
- 用 YAML 文件描述服务配置。
- 自动创建容器网络。
- 支持容器之间通过服务名访问。
- 支持端口映射、环境变量、数据卷、依赖关系等配置。
- 适合开发环境、测试环境、小型部署环境。
2. 基本示例
services:
  app:
    image: myapp:latest
    ports:
      - "8080:8080"
    depends_on:
      - mysql
      - redis

  mysql:
    image: mysql:8.0
    environment:
      MYSQL_ROOT_PASSWORD: 123456
      MYSQL_DATABASE: demo
    ports:
      - "3306:3306"
    volumes:
      - mysql-data:/var/lib/mysql

  redis:
    image: redis:7
    ports:
      - "6379:6379"

volumes:
  mysql-data:
3. 核心配置
services:定义服务,一个服务通常对应一个容器,例如 app、mysql、redis。
image:指定使用哪个镜像。
build:指定使用本地 Dockerfile 构建镜像。
ports:端口映射,格式是 宿主机端口:容器端口。
environment:环境变量配置,例如数据库密码、启动参数。
volumes:数据卷挂载,用于数据持久化或挂载配置文件。
networks:容器网络配置。同一个 Compose 项目中的服务默认在同一个网络下,可以通过服务名互相访问。
depends_on:控制服务启动顺序,例如后端服务依赖 MySQL、Redis。
restart:容器重启策略,例如 always、unless-stopped。
4. 常用命令
docker compose up启动服务。
docker compose up -d后台启动服务。
docker compose down停止并删除容器、网络。
docker compose ps查看服务运行状态。
docker compose logs -f查看实时日志。
docker compose restart重启服务。
docker compose build重新构建镜像。
docker compose pull拉取服务使用的镜像。
5. 重点理解
Docker Compose 解决的是多个容器如何一起启动、一起配置、一起管理的问题。
容器之间访问时,一般不要写 localhost,而是写服务名。例如 Java 后端连接 MySQL 时,地址通常写 mysql:3306,连接 Redis 时写 redis:6379。
数据需要持久化时,要使用 volumes,否则容器删除后数据可能丢失。
生产环境也可以使用 Docker Compose,但大型集群、弹性伸缩、多节点调度一般会使用 Kubernetes。
一句话总结:Docker Compose 就是用一个 YAML 文件描述一组容器,然后用一条命令管理整个应用环境。
AI知识点精简总结
AI / Agent / RAG 知识点精简总结
根据
0713-AI-Model、0715-AI-tool、0717-AI-RAG、0718-AI-evaluation以及 LangChain 系列目录中的 Markdown 笔记整理。
1. 整体学习主线
AI 应用开发可以按下面这条线理解:
模型调用
-> Prompt 控制
-> 对话记忆
-> 结构化输出
-> Tool / Function Call
-> MCP 外部能力接入
-> RAG 知识库增强
-> Skill 业务能力封装
-> Agent 智能体编排
-> 评估、监控、上线优化
Java 侧重点:Spring AI、业务接口、后台管理、权限、日志、系统集成。
Python 侧重点:LangChain、LangGraph、RAG、Agent 编排、向量库、评估实验。
2. Spring AI 核心知识
Spring AI 是 Java 生态中对大模型能力的统一封装,主要解决模型调用、提示词、记忆、工具调用、RAG、评估和可观察性等问题。
核心模块:
ChatModel:底层模型调用接口,偏基础能力封装。ChatClient:更高级的对话客户端,支持链式调用、Prompt、Advisor、Tool、结构化输出等。Prompt:控制模型角色、任务、上下文、约束和输出格式。Advisor:对模型请求和响应做拦截增强,例如日志、记忆、安全过滤、RAG。ChatMemory:保存多轮对话上下文,可用内存、数据库、Redis 实现。Tool:让模型调用 Java 业务方法。VectorStore:统一封装向量数据库检索。Evaluation:对模型回答效果做自动化评估。
3. 模型调用与模型选型
常见模型来源:
- 云端模型:DeepSeek、阿里百炼、OpenAI、硅基流动等,接入快、效果稳定,但有成本和数据安全问题。
- 本地模型:Ollama 部署本地开源模型,数据更安全,但对硬件要求更高。
- 多模型切换:业务中可按场景切换模型,例如普通问答用低成本模型,复杂推理用高质量模型。
常见参数:
temperature:控制创造性,越高越发散,越低越稳定。maxTokens:控制最大输出长度。stop:设置停止生成条件。model:指定使用的模型名称。
项目中建议:
- 普通客服、知识问答:低温度,保证稳定。
- 文案生成、创意任务:适当提高温度。
- 重要业务:固定输出格式,加校验和兜底。
4. Prompt 提示词
Prompt 是控制模型输出的核心手段。
一个好 Prompt 通常包含:
- 角色:告诉模型扮演什么身份。
- 任务:明确要做什么。
- 上下文:提供业务背景和输入资料。
- 约束:说明不能做什么、边界在哪里。
- 输出格式:要求 JSON、表格、列表或固定字段。
常见消息类型:
SystemMessage:系统规则和角色设定。UserMessage / HumanMessage:用户输入。AssistantMessage / AIMessage:模型回复。ToolMessage:工具调用结果。
设计原则:
- 指令要清晰具体。
- 输出格式要明确。
- 复杂任务要拆步骤。
- 关键业务不要只靠模型自由发挥。
- Prompt 要版本化,方便测试和回滚。
5. Advisor、记忆与结构化输出
Advisor 可以理解为 Spring AI 的对话拦截器,用于在请求前后增强模型调用。
常见用途:
- 日志记录:记录输入、输出、耗时、模型名称。
- 对话记忆:保存历史消息,实现多轮对话。
- 动态 Prompt:根据用户、租户、场景拼接不同系统提示词。
- 安全审查:敏感词、越权内容、危险操作过滤。
- RAG 增强:先检索知识库,再把上下文传给模型。
对话记忆常见方案:
- 内存:适合测试。
- MySQL:适合长期存储和审计。
- Redis:适合短期会话和高并发。
- 多层记忆:短期上下文 + 长期用户画像 + 业务数据。
结构化输出:
- 让模型返回固定 JSON、对象、列表或业务 DTO。
- 适合意图识别、参数抽取、评估打分、表单生成等场景。
- 生产中必须做 JSON 解析失败处理和字段校验。
6. Tool / Function Call
Tool 的作用是让模型调用真实业务能力,而不是只生成文本。
典型流程:
用户输入
-> 模型识别意图
-> 选择 Tool
-> 提取参数
-> 调用 Java / Python 方法或接口
-> 工具返回结果
-> 模型组织最终回复
适合封装成 Tool 的能力:
- 查询订单、报名状态、库存、课程、医生排班。
- 创建工单、提交反馈、发送通知。
- 查询数据库、调用第三方 API。
- 文件解析、OCR、地图、支付状态查询。
设计注意点:
- Tool 名称和描述要清楚,避免缩写。
- 参数不要过多,建议一个工具控制在 5 个参数以内。
- 重要操作如支付、删除、报名提交必须二次确认。
- 能用代码判断的逻辑,不要全部交给模型。
- 工具调用要有超时、异常处理和日志。
7. MCP 知识点
MCP 是 Model Context Protocol,用于让 AI 应用用统一协议连接外部工具、数据源和服务。
核心角色:
- Host:使用 MCP 的宿主应用,例如 IDE、AI 客户端、智能体平台。
- Client:负责连接 MCP Server。
- Server:暴露工具、资源和能力。
常见通信方式:
STDIO:适合本地工具、命令行工具。SSE:基于 HTTP 的服务端事件推送。Streamable HTTP:更适合 Web 服务化调用。
适用场景:
- IDE 调用代码工具。
- Agent 调用企业内部系统。
- 统一接入数据库、地图、文件系统、业务 API。
- 把不同工具标准化暴露给模型。
8. RAG 知识库增强
RAG 的目标是让模型基于外部知识回答问题,解决大模型不知道私有知识、容易幻觉、知识更新困难的问题。
RAG 标准流程:
文档收集
-> 文档清洗
-> 文档切分
-> 向量化
-> 写入向量库
-> 用户提问
-> 向量检索 / 关键词检索
-> Rerank 重排序
-> 拼接上下文
-> 模型生成回答
-> 返回答案和来源
核心概念:
Document:文档对象,包含正文和元数据。Embedding:把文本转换成向量。VectorStore:存储和检索向量。Metadata:来源、分类、版本、租户、页码、业务线等信息。Retriever:检索器,负责找相关文档。Rerank:对召回结果重新排序,提高相关性。
常见文档来源:
- Markdown、Text、PDF、Word、Excel。
- 网页、字幕、企业知识库。
- 数据库业务规则、FAQ、客服话术。
切分策略:
- 按长度切分:简单,但可能截断语义。
- 按段落 / 标题切分:适合 Markdown、文档手册。
- 递归字符切分:更适合中英文混合文档。
- 中文增强切分:注意标点、句子和段落边界。
生产建议:
- 向量库同一个集合必须使用同一个 Embedding 模型和维度。
- 换 Embedding 模型后要重建索引。
- 文档导入要幂等,避免重复数据。
- 检索时加元数据过滤,防止跨租户、跨权限查询。
- 没有检索结果时要拒答或转人工。
- 回答最好带来源、文档版本和片段位置。
9. 向量数据库
常见向量库:
FAISS:本地内存向量库,适合学习、小知识库、本地测试。Milvus:开源向量数据库,适合生产和大规模向量检索。Chroma:轻量,适合原型验证。Pinecone:云服务,接入方便。pgvector:PostgreSQL 扩展,适合中小规模业务系统。Elasticsearch / OpenSearch:适合混合检索和关键词检索。
选型建议:
- Demo / 学习:FAISS、Chroma。
- Java 业务系统轻量落地:pgvector。
- 大规模知识库:Milvus。
- 需要关键词 + 向量混合检索:Elasticsearch / OpenSearch。
10. LangChain 核心知识
LangChain 是 Python 生态中连接大模型、Prompt、工具、记忆、检索和 Agent 的开发框架。
核心能力:
- Model IO:统一调用 OpenAI、DeepSeek、Qwen 等模型。
- Prompt Template:模板化管理提示词。
- Message:用系统、用户、AI、工具消息组织多轮对话。
- Tool:封装外部函数和 API。
- Retriever:封装知识库检索。
- Agent:让模型自主选择工具并完成任务。
LangChain 生态:
LangChain:基础组件和模型调用。LangGraph:复杂流程、状态机、多节点编排。LangSmith:调试、追踪、评估和可观测性。Deep Agent:更复杂的自主规划、多步骤任务和多智能体协作。
11. LangGraph 核心知识
LangGraph 适合做复杂 Agent 工作流,它不是简单链式调用,而是用“图”管理流程。
核心组件:
State:贯穿整个流程的状态数据。Node:一个处理节点,可以是模型调用、工具调用、数据处理。Edge:节点之间的流转关系。Conditional Edge:根据状态决定下一步走向。Reducer:控制多个节点如何更新同一个状态字段。Runtime Context:单次运行中只读的上下文,例如模型、数据库连接、租户 ID。Checkpoint:保存执行状态,支持恢复和短期记忆。Store:长期记忆存储。
适用场景:
- 多步骤任务。
- 多工具调用。
- 需要状态持久化的流程。
- 人工审批、暂停后继续执行。
- Fan-out 并行和 Map-Reduce 汇总。
- 多轮问答和复杂 Agent。
12. Skill 技能封装
Skill 是比 Tool 更高一层的业务能力封装。
区别:
- Tool:一个具体动作,例如查询课程、创建报名记录。
- Skill:一组业务流程,例如课程咨询、学生报名、售后处理。
Skill 通常包含:
- 技能名称。
- 技能描述。
- 适用场景。
- 输入参数。
- 可调用工具。
- Prompt 规则。
- 执行结果。
设计原则:
- 一个 Skill 只负责一类业务。
- Skill 内部可以调用多个 Tool。
- Skill 的输入输出要结构化。
- 路由要保守,无法判断时交给通用技能。
- 业务边界和异常兜底要明确。
13. Agent 智能体
Agent 不是普通聊天机器人,而是能根据目标自主选择步骤、调用工具并完成任务的系统。
Agent 四个核心能力:
- 感知:理解用户输入和业务意图。
- 规划:决定下一步做什么。
- 行动:调用工具、查询数据、执行业务操作。
- 反馈:根据结果继续执行或返回用户。
典型业务流程:
用户输入
-> 意图识别
-> 选择 Skill 或 Tool
-> 检查必要参数
-> 缺参数时追问
-> 参数完整后执行工具
-> 汇总结果
-> 生成回复
-> 记录日志
开发注意点:
- Agent 边界要清晰,不是 Prompt 越长越好。
- 复杂 Agent 要拆成感知、规划、行动、反馈几层。
- 高风险操作必须二次确认。
- 每一步都要记录日志,方便排查工具调用问题。
- 对外部接口要做超时、重试、异常兜底。
- 无法回答时拒答、转人工或创建工单。
14. 模型评估
模型评估用于判断模型、Prompt、RAG、工具调用是否真的适合业务。
评估流程:
准备测试集
-> 调用模型生成答案
-> 对比标准答案
-> 打分并记录原因
-> 汇总平均分
-> 根据结果优化模型、Prompt 或知识库
常见指标:
- 准确性:是否答对核心问题。
- 完整性:是否覆盖关键点。
- 幻觉率:是否编造不存在的信息。
- 格式稳定性:是否按要求输出 JSON、表格或字段。
- 工具调用成功率:是否选对工具、参数是否正确。
- RAG 命中率:是否检索到正确文档。
评估建议:
- 测试集要来自真实业务问题。
- 标准答案要包含关键点。
- 答题模型和裁判模型最好分开。
- 重要业务不能只靠 AI 自动评分,要抽样人工复核。
- 每次改模型、Prompt、知识库都要重新评估。
15. 企业级 AI 项目开发流程
完整开发流程:
需求调研
-> 场景拆解
-> 模型选型
-> Prompt 设计
-> Tool / API 封装
-> 知识库建设
-> Agent / Skill 编排
-> 管理后台开发
-> 联调测试
-> 模型评估
-> 灰度上线
-> 日志监控
-> 持续优化
Java 工程师常负责:
- 用户、权限、角色、菜单。
- 业务接口和数据库设计。
- Spring AI 接入模型。
- Tool 方法封装。
- 知识库管理后台。
- 问答日志、反馈、评估结果展示。
- Redis / MySQL / MQ / 定时任务集成。
Python 工程师常负责:
- LangChain / LangGraph 编排。
- RAG 文档处理和向量化。
- 向量数据库接入。
- Agent 实验和评估。
- 文档解析、Embedding、Rerank。
- 模型服务封装。
16. 面试表达总结
可以这样概括自己的 AI 项目能力:
我做的 AI 应用不是简单调模型接口,而是围绕业务系统做完整闭环:前端或后台接收用户问题,Java 负责用户权限、业务接口和管理后台,Python 或 Spring AI 负责模型调用、RAG 检索、Tool 调用和 Agent 编排。上线后通过日志、评估集、用户反馈持续优化 Prompt、知识库和工具调用链路。
可以重点讲的亮点:
- 基于 RAG 实现企业知识库问答,支持文档导入、切分、向量化、检索和引用来源。
- 基于 Tool / Function Call 让模型调用真实业务接口,而不是只做文本生成。
- 基于 Skill 封装课程咨询、报名、售后、工单等业务能力。
- 基于 Agent 编排多步骤任务,支持意图识别、参数补全、多轮对话和人工兜底。
- 基于模型评估体系对准确率、幻觉率、格式稳定性和 RAG 命中率做持续优化。
- 使用 Redis / MySQL 保存会话、日志、反馈和评估结果,便于排查和运营。
17. 快速复习清单
- Spring AI:
ChatModel、ChatClient、Prompt、Advisor、Memory、Tool、VectorStore。 - Prompt:角色、任务、上下文、约束、输出格式。
- Tool:模型调用业务方法,重点是描述、参数、权限和二次确认。
- MCP:统一协议接入外部工具和资源,常见 STDIO、SSE、Streamable HTTP。
- RAG:文档清洗、切分、向量化、检索、Rerank、上下文生成。
- 向量库:FAISS 适合本地测试,Milvus 适合生产,pgvector 适合轻量业务落地。
- LangChain:Python AI 应用基础框架。
- LangGraph:状态图、节点、边、条件路由、记忆、持久化。
- Skill:把多个 Tool 封装成业务能力。
- Agent:感知、规划、行动、反馈。
- Evaluation:测试集、评分、幻觉率、格式稳定性、持续优化。
场景
1.如果你的业务量突然提升100倍QPS你会怎么做?
- 紧急处理(马上要做) ① 服务扩容: 水平扩容:加机器,多实例部署,负载均衡:Nginx / LVS / SLB 分发流量 ② 限流保护:没有限流加限流;有限流,当服务扩容后扩大限流③ ③ 熔断降级:没有就加 提前预防:数据库加redis缓存,应用层优化(异步,锁竞争,本地缓存)网关层(Nginx层缓存,静态CDN加速,接口页面缓存)
2.让你设计一个订单号生成服务,该怎么做?
我会设计一个基于雪花算法的分布式 ID 生成服务:
- 使用 64 位雪花结构:1 位符号 + 41 位时间戳 + 10 位机器 ID+12bit 序列号。
- 纯内存生成,性能极高,支持高并发。
- 处理时钟回拨,确保 ID 不重复、不乱序。
- 可扩展号段模式做兜底,保证极端场景高可用。
- 最终生成全局唯一、趋势递增、长度固定的订单号。
时钟回拨: ① 方案 1:等待时间追上来(最常用、最简单) ② 方案 2:使用备用序列位 / 扩展位(高可用方案) ③ 方案 3:使用独立时间源,不依赖系统时钟(最稳 ntp同步时间服务)
3.订单到期关闭如何实现
rabbitMQ死信队列 1.创建订单时发送一条 30 分钟 TTL 的延迟消息,到期后消息进入死信队列 2. 由消费者监听并关闭未支付订单、释放库存。 3. 同时使用定时任务轮询做兜底,保证极端情况下(消息丢失、服务宕机)订单也能正常关闭。 1个定时任务:读订单表(超时订单状态未完成并且未关闭的)订单id拿到:开线程挨个改订单状态(jdk21用虚拟线程)
4、如何设计一个购物车功能?
购物车采用 Redis + 数据库 架构: 未登录存在前端 localStorage,登录后存在 Redis 并持久化到 DB
Key
cart:user:{userId}
结构 Hash
field:skuId(字符串) value:购物车商品JSON字符串
5.每天100w次登录请求,4C8G机器如何做JVM调优?
- 分配 6G 堆,4G 新生代(-Xms6g -Xmx6g -Xmn4g )
- 使用 G1 收集器,设置 最大停顿 20ms(
- 关闭显式 GC
- 打开 OOM 自动 dump
6、不用redis分布式锁, 如何防止用户重复点击?
- 前端控制:按钮禁用 + 防抖 + loading,挡住大部分重复点击。
- 请求唯一 ID(submitToken):后端生成一次性 token,提交时校验并删除,保证只执行一次。
- 数据库唯一索引:从存储层保证业务唯一,终极兜底。
- 本地锁 / 参数签名缓存:单机环境用本地锁或参数签名做快速防重。
7、让你设计一个秒杀系统,你会考虑哪些问题?
① 页面 CDN → 按钮倒计时 ② 请求进入 → 网关限流、用户校验 ③ Redis 原子扣减库存,扣减成功 → 发送 MQ, 人添加到Redis存储的list中(秒过就不能再秒) ④ MQ 消费 → 异步生成订单 ⑤ DB 悲观锁扣减库存 (兜底) ⑥ 超时未支付 → 自动关单、库存回滚
要考虑哪些问题? 1.前端 / 静态资源优化 2.网关层限流 & 拦截 3.服务限流、熔断、降级 4.库存预热到 Redis 5.防作弊、防刷、防黄牛 6.防止重复下单 7.数据库兜底 8.高可用 & 兜底
8.库存扣减如何避免超卖和少卖?
- Redis 预扣库存
- 数据库乐观锁最终扣减
- 订单超时关单自动回滚库存
- 定时任务对账
9、如何用Redis/mongo实现朋友圈点赞功能?
redis:
key: moment:like:${朋友圈id}
value: 点赞用户ID的ZSet集合
mongo: {key: value}
10.如何实现”查找附近的人”功能
Redis GEO 地理位置数据结构,底层基于 ZSet + Geohash 实现。 GEOADD 存储用户经纬度,使用 GEORADIUSBYMEMBER 命令查询指定范围内的附近用户,返回按距 离排序的结果
GEOADD people 经度 纬度 用户ID GEOADD people 121.4894 31.2466 1001 GEOADD people 121.4895 31.2467 1002
GEORADIUSBYMEMBER people 1001 1000 m WITHDIST
GEORADIUS people 116.40386 39.91488 5 km
11、一个订单,在11:00超时关闭,但在11:00也支付成功了,怎么办?
-
支付请求: 锁订单 从未支付0 更新为 已支付1 释放锁
-
关单请求: 锁订单 查询状态 已支付 1 直接退出,不做任何操作
锁订单 查询状态0 关闭订单 2 释放锁
12,索引失效的问题是如何排查的,有那些种情况?
排查索引失效先 explain 看执行计划,重点看 key、type、Extra。 常见失效场景包括: 违反最左前缀、索引列用函数 / 运算、模糊 % 开头、隐式类型转换、使用!= 或 OR、order by 不按索 引顺序、回表代价大导致优化器放弃索引等
13,40亿个QQ号,限制1G内存,如何去重?
最优方案是 Bitmap。用 1 bit 表示一个整数是否存在,只需要约500MB 内存,遍历一遍即可完成去重,时间复杂度 O (n),空间效率极高。
14、说一说多级缓存是如何应用的?
多级缓存就是按照靠近用户的顺序,搭建:浏览器缓存 → CDN → 本地缓存 → Redis → DB 的缓存体 系。 访问流程: ① 先读 本地缓存 → 有就直接返回 ② 没有 → 读 Redis,读到 → 回填本地缓存 ③ Redis 没有 → 读 数据库,读到 → 写入 Redis,再回填本地缓存 ④ 全部没有 → 返回空
15.从B+树的角度分析为什么单表2000万要考虑分表?
分表是为了让每张表的 B + 树保持小而高效,始终维持在 3 层左右、全部热点在内存,保证查询最快。
16、线上接口如果响应很慢如何去排查定位问题呢?
线上接口响应慢,排查思路是从外到内、从入口到核心、先宏观后微观:
- 先看服务器、JVM、流量、监控,判断是否基础环境问题;
- 再用APM、日志、Arthas定位具体方法或组件;
- 接着排查第三方依赖:MySQL(慢 SQL)、Redis、第三方接口、MQ 等最常见瓶颈;
- 最后检查网络、配置、安全策略 通过监控 + 链路追踪(超时告警) + 诊断工具,能快速定位是代码、SQL、中间件还是环境问题。
17、怎么做数据对账?
数据对账是保证系统间数据一致性的核心手段,流程分为:数据准备 → 标准化 → 按唯一键匹配 → 差异 处理 → 生成结果。 通过订单号 / 流水号匹配,核对状态、金额、时间,识别漏单、多单、金额不一致,并通过自动补单、 人工审核闭环。海量数据采用分批次、离线、分片对账,保证资金安全与系统可信。 支付对账? ① 按订单号关联 ② 比较: 1.订单状态 2.支付状态 3.支付金额 4.手续费 ③ 异常: 1.我待支付,他已支付 → 补单 2.我已支付,他未支付 → 风控 / 核查 3.金额不一致 → 人工核实 怎么对账?
- 分批次对账 按小时 / 按天 / 按用户分片 避免一次全量拉爆内存
- 离线对账 用 Spark / Hive 跑批处理 T+1 对账
- 实时对账 基于 MQ 消息 支付成功 → 实时核对
- 最终核对:我方总成功金额 = 渠道总成功金额
18.和外部机构交互如何防止被外部服务不可用而拖垮
采用超时控制、线程池隔离、熔断、降级、限流、异步化六种手段:
- 设置合理超时,避免无限阻塞;
- 独立线程池隔离,外部故障不影响主线程;
- 自动熔断,错误率过高快速失败;
- 熔断后降级,保证核心流程可用;
- 限流,保护自身与第三方;
- 尽量异步化,彻底解耦依赖
查询最新电影信息 本地过期电影信息兜底数据(冷启动)
CPU飙高问题排查过程
- GC 疯狂执行(FullGC 不断):jstat -gc PID 1000
- 死循环 / 空转循环
- 高频锁竞争 / 自旋锁
- 复杂计算 / 正则表达式失控
OOM问题排查过程
- 应用启动时配置 HeapDump 参数,保证 OOM 时自动导出堆快照;
- 使用 MAT/jprofile 打开堆文件,通过 Histogram 找到占用内存最大的对象;
- 通过 Path to GC Roots 找到强引用链,定位谁在持有对象;
- 结合 jstat 查看 GC 情况,判断是内存泄漏还是真的内存不足;
- 常见问题是:静态集合只增不减、批量查询大对象、缓存无上限、资源未关闭;
- 修复后观察堆内存可正常回收,FullGC 频率恢复正常。
频繁FullGC问题排查
- 通过 jstat -gc 或 GC 日志,观察老年代使用情况,判断是内存泄漏还是内存不足;
- 若为泄漏,使用 jmap 导出堆快照,通过 MAT 工具找到占用内存最大的对象及GC Root 引用链;
- 定位代码问题,常见是静态集合只增不减、批量查询大对象、缓存无上限、资源未关闭;
- 若不是泄漏,检查堆内存配置、新生代大小,调大内存或优化大对象操作;
- 修复后观察 FullGC 频率恢复正常。
什么是IaaS、PaaS、SaaS?
IaaS(基础设施即服务,Infrastructure as a Service) PaaS(平台即服务,Platform as a Service)SaaS(软件即服务,Software as a Service)
DDD 领域驱动模型
什么是Serverless?
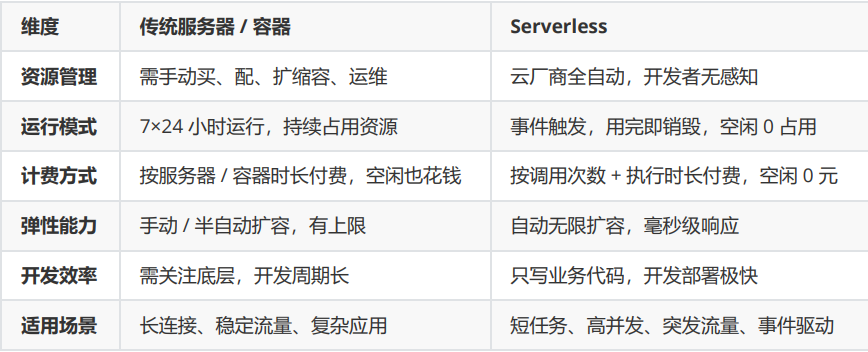
Serverless(无服务器)是一种计算模型,旨在让开发者能够更专注于编写代码和功能,而无需显式管 理服务器和基础设施。虽然名称中带有“无服务器”,但实际上并不意味着没有服务器存在,而是指开发 者无需关心服务器的管理细节。
线上的k8s,根据QPS动态扩缩容,灰度发布等
MySQL 里有 2000W 数据,Redis 中只存 20W 的数据,如何保证 Redis 中的数据都是热点数据?
主要靠 LRU 淘汰机制 + 懒加载缓存:
- 将 Redis 内存淘汰策略设置为 allkeys-lru,内存满时自动删除冷数据,保留热点;
- 采用 懒加载模式,只有被访问的数据才写入 Redis,未访问数据不进入;
- 对首页、爆款等已知热点主动预热;
- 不做全量加载,避免冷数据污染缓存;
- 合理设置过期时间,防止缓存雪崩。 这样就能保证 20W 缓存空间里,存的永远是访问量最高的热点数据。